Desvio Padrão Em Estatistica

Começando pelo cálculo, não pela definição
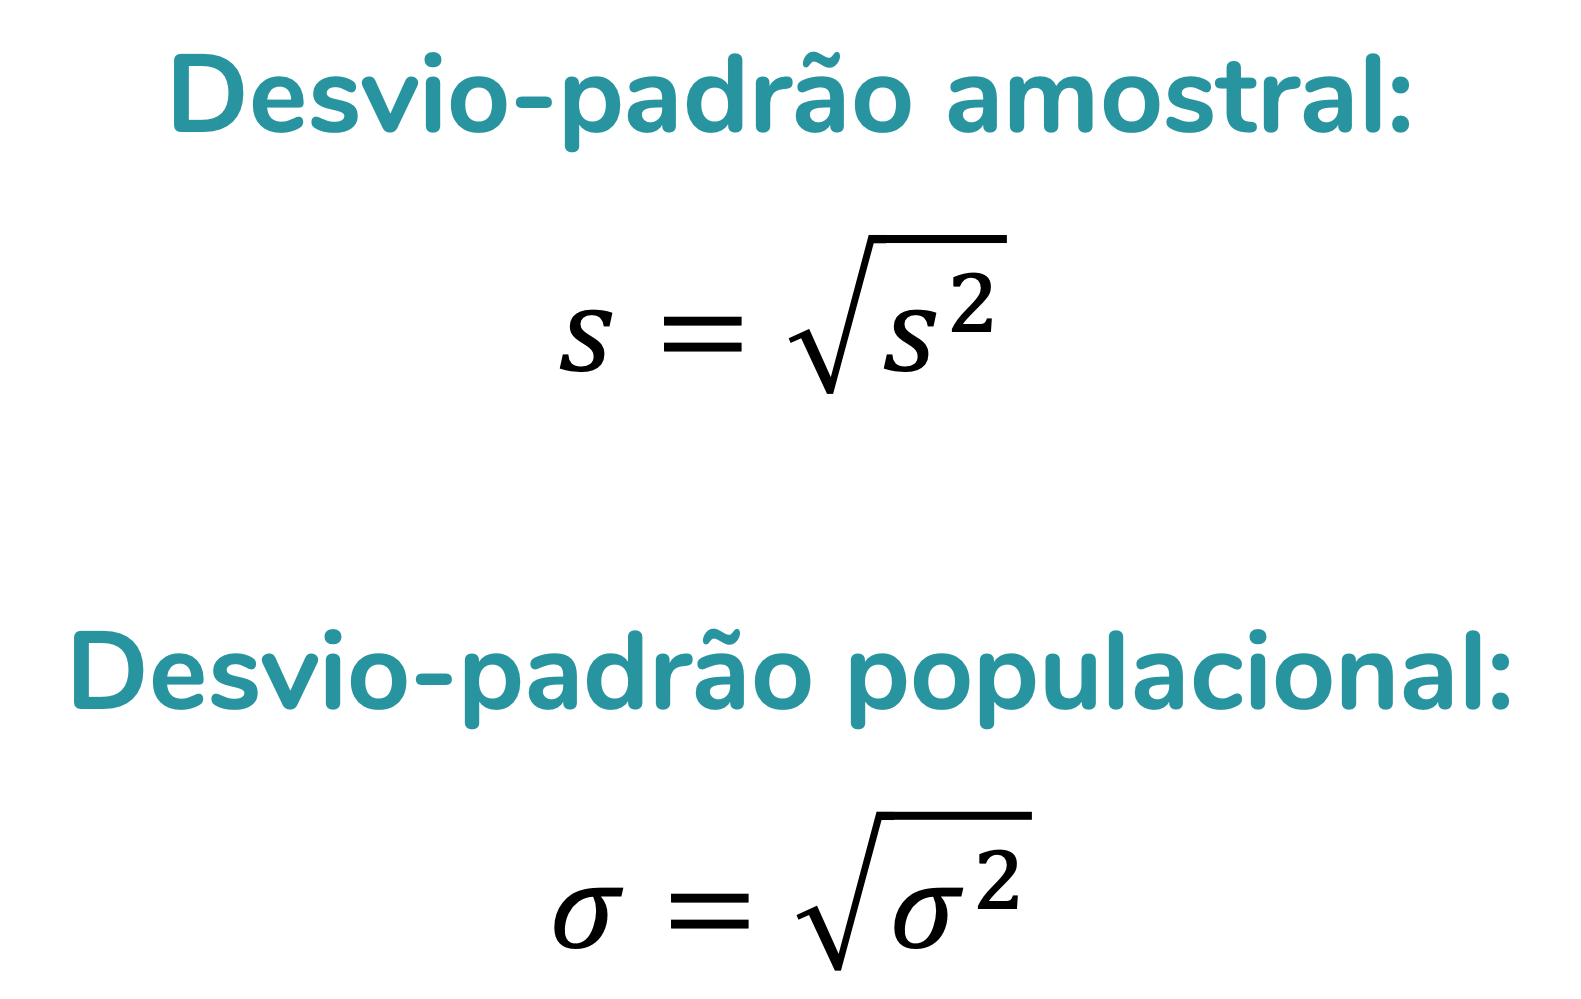
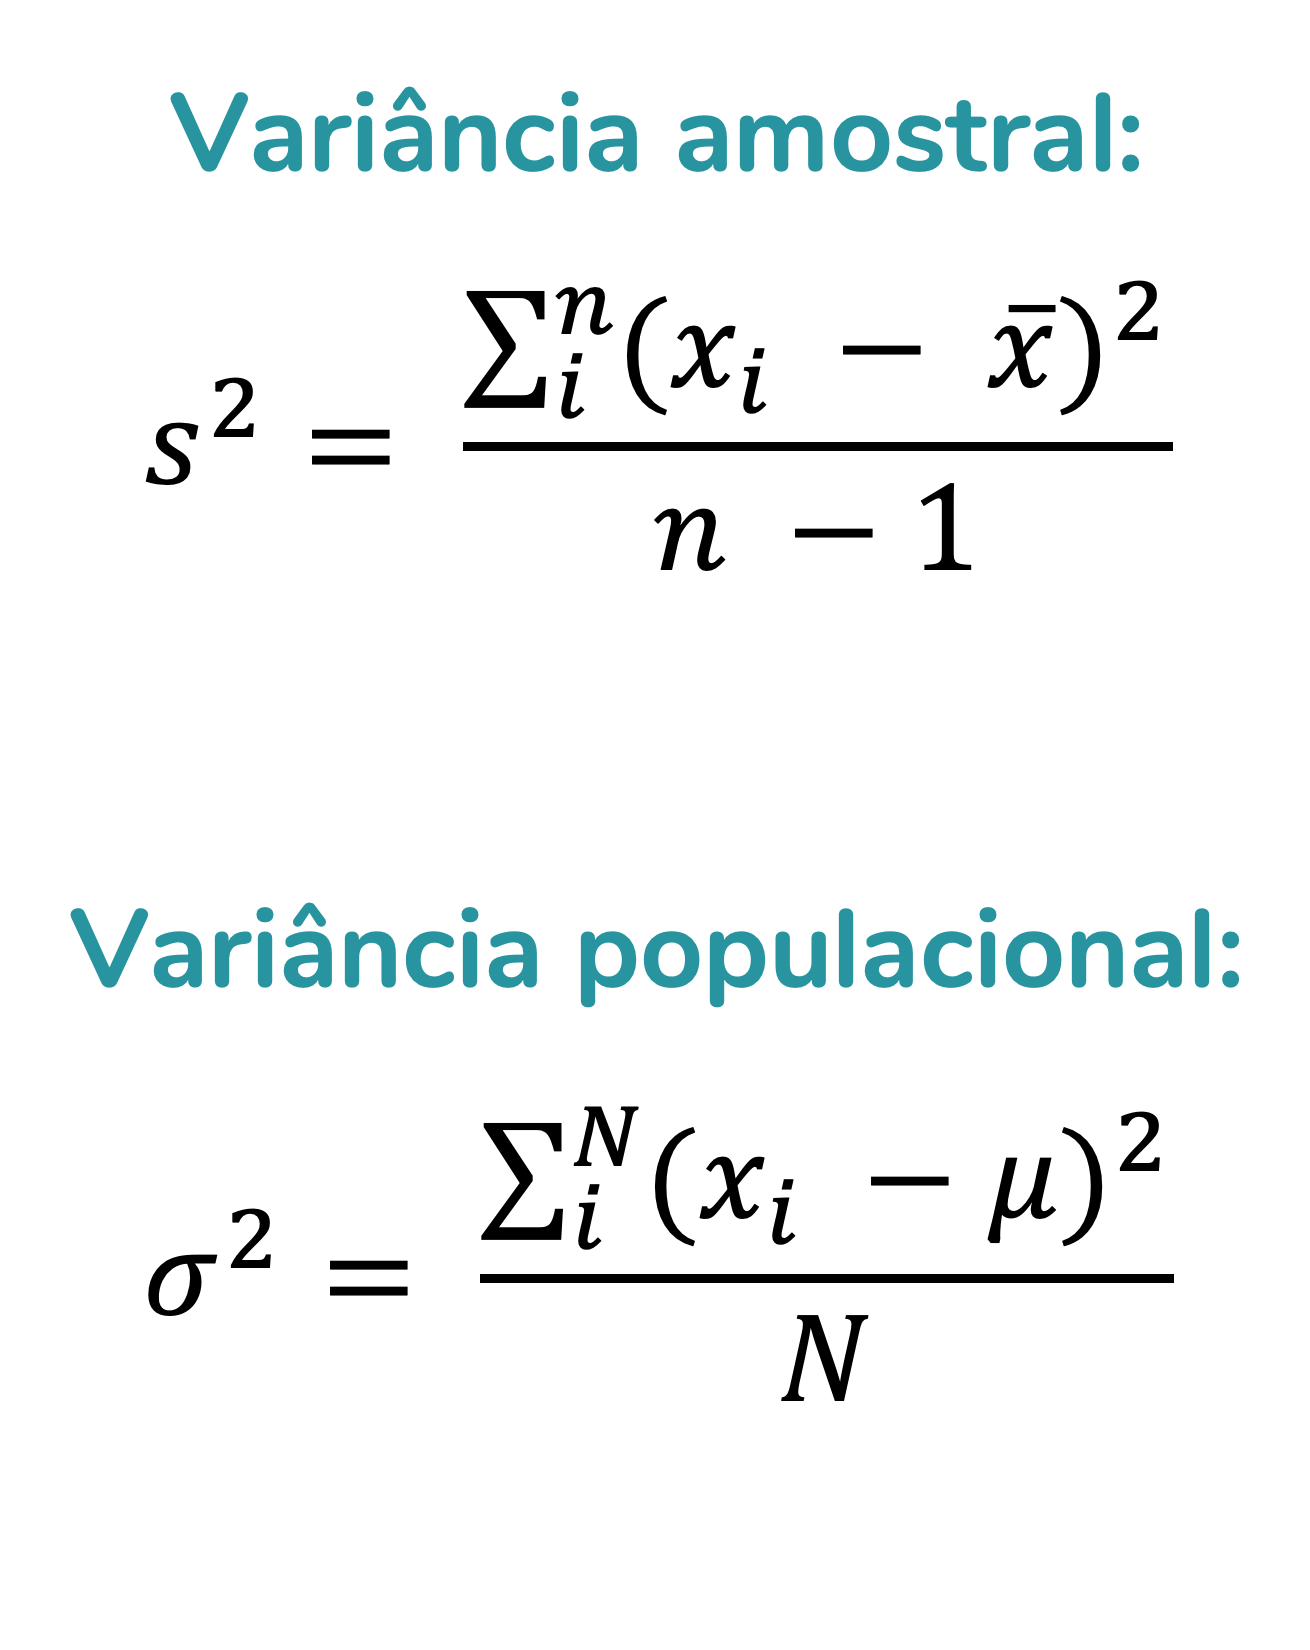
Você pega os seus dados, subtrai a média de cada observação, eleva ao quadrado, calcula a média desses quadrados e depois abre a raiz quadrada. O resultado é o desvio padrão. Parece simples porque é simples. O problema é que as pessoas geralmente erram na hora de decidir se divide por N ou por N-1, e isso muda o valor final de forma significativa. Para população, divide por N. Para amostra, divide por N-1. A diferença é o fator de correção de Bessel, que compensa o viés que aparece quando você estima a variabilidade de uma amostra em vez de ter todos os dados da população. Eu vejo gente usar a fórmula de população com dados amostrais todo dia. O resultado fica subestimado. Às vezes em 10%, às vezes em 30% se a amostra for pequena.
Como calcular o desvio padrão em estatistica
Aqui vai um exemplo prático, porque números ajudam mais do que palavras. Suponha que você tenha os seguintes valores de produção diária: 10, 12, 14, 11, 13, 16. A média é 13. As diferenças em relação à média são: -3, -1, 1, -2, 0, 3. Elevando ao quadrado: 9, 1, 1, 4, 0, 9. A soma é 24. Dividindo por 6 (população), a variância é 4. A raiz quadrada de 4 é 2. Esse é o desvio padrão populacional. Se fosse amostra, dividiria por 5, a variância seria 4,8 e o desvio padrão aproximado seria 2,19. No Excel, a função para amostra é STDEV.S e para população é STDEV.P. No Google Sheets funciona igual. Em Python, você usa numpy.std com o parâmetro ddof=0 para população ou ddof=1 para amostra. Nada complicado, mas cada plataforma usa convenções ligeiramente diferentes e isso gera confusão. O erro mais comum que eu vejo no dia a dia é pessoa calcular o desvio padrão sem olhar a distribuição dos dados primeiro. Você pode ter um desvio padrão baixo e ainda assim ter dados completamente distorcidos por valores extremos. O desvio padrão por si só não te conta isso.
Onde o desvio padrão falha — e eu aprendi na prática
Trabalhando com dados de tempo de resposta de servidores, eu me deparei com uma situação em que o desvio padrão estava dizendo que o sistema era estável, mas os usuários reclamavam de travamentos frequentes. A média era 120ms com desvio padrão de 15ms. Parecia perfeito. Até eu olhar o histograma. Havia dois picos claros: um em 110ms e outro em 450ms. O desvio padrão estava achatando essa realidade porque assume distribuição simétrica. O quartil 75 estava em 130ms e o quartil 95 em 410ms. Eu mudei a análise para intervalo interquartil e mediana absoluta do desvio, e aí sim a imagem ficou clara. Distribuições bimodais, assimétricas com cauda longa, dados com outliers estruturais — nessas situações o desvio padrão perde a capacidade de comunicar coisa útil. Ele ainda existe, ainda pode ser calculado, mas a interpretação que as pessoas fazem dele fica errada. Regra empírica dos 68-95-99,7 só vale para distribuição normal. Se os seus dados não são normais, essa regra não se aplica.
Insights que não estão nos livros introdutórios
Primeiro: o desvio padrão é sensível a outliers de forma quadrática. Um único ponto muito distante puxa a média e infla o desvio padrão proporcionalmente ao quadrado da sua distância. Isso significa que em conjuntos pequenos, um único valor problemático pode quase dobrar o desvio padrão. Segundo: quando você compara desvios padrão de grupos com médias muito diferentes, a comparação direta é enganosa. O desvio padrão absoluto não considera a escala. Nesse caso, o coeficiente de variação (desvio padrão dividido pela média) é mais honesto. Terceiro: desvio padrão zero não significa que todos os dados são iguais em contextos práticos. Pode significar que você só tem uma observação ou que os dados foram arredondados a ponto de perder variação. Eu vi relatórios onde o desvio padrão aparecia como zero porque os valores eram todos expressos em inteiros e a variação real estava nos decimais que foram truncados.
Alternativas quando o desvio padrão não serve
Intervalo interquartil é mais robusto para dados assimétricos. Desvio médio absoluto também é mais resistente a outliers porque não eleva ao quadrado. Em modelos estatísticos mais avançados, uso frequência dispersion index para dados de contagem e madlib para detectar múltiplos modos em distribuições antes de decidir qual métrica de dispersão reportar. O desvio padrão em estatistica é uma ferramenta válida e amplamente usada, mas não é universal. Ele funciona bem quando os dados são razoavelmente simétricos, quando não há outliers dominantes e quando a distribuição se aproxima do normal. Fora disso, você precisa de outras métricas ou de uma combinação delas. Calcular o desvio padrão é fácil. Saber quando não usá-lo é o que separa uma análise rasa de uma análise que realmente descreve o que está acontecendo nos dados.
Galeria
-

Vetores de Fórmula De Desvio Padrão Para Estatística Matemática ... -

DESVIO PADRÃO - Estatística - Variância e Desvio Padrão -
O que é variância? E desvio-padrão? | Fernanda Peres | Estatística aplicada -

Estatística: Amplitude, Variância e Desvio Padrão - Blog do Prof. H
