Diferença De Conjuntos

Como calcular diferença de conjuntos na prática
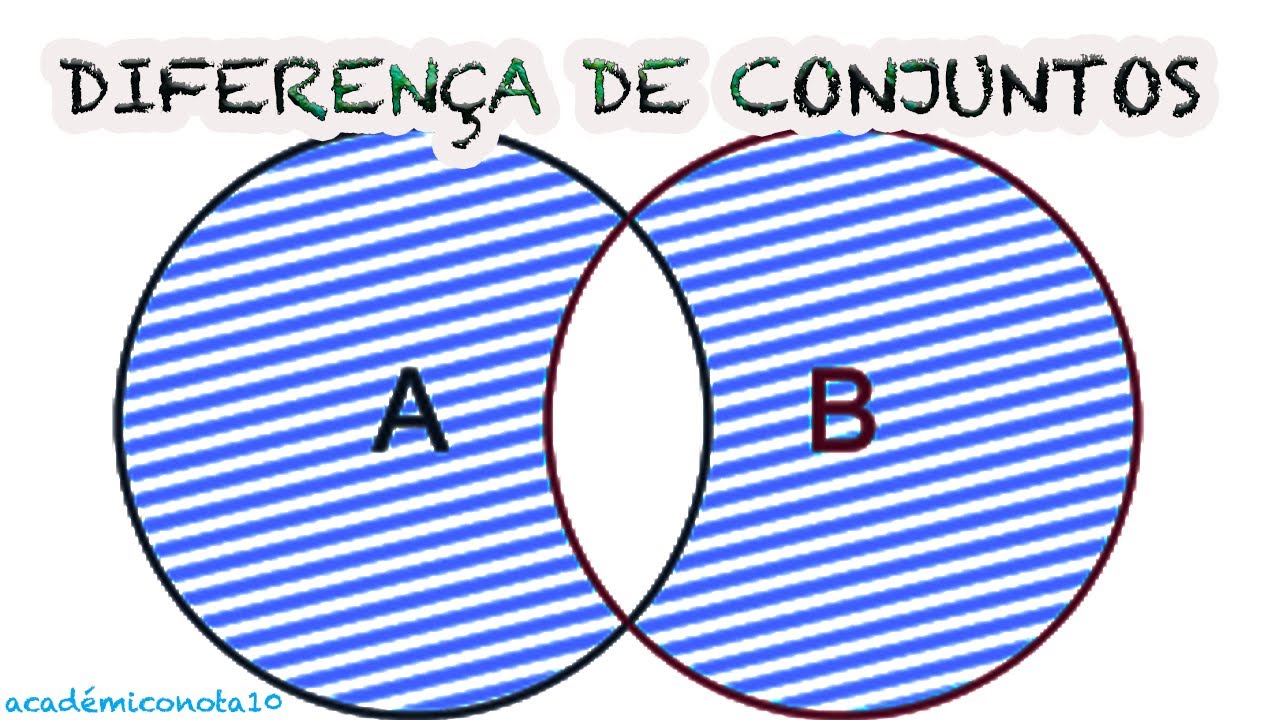
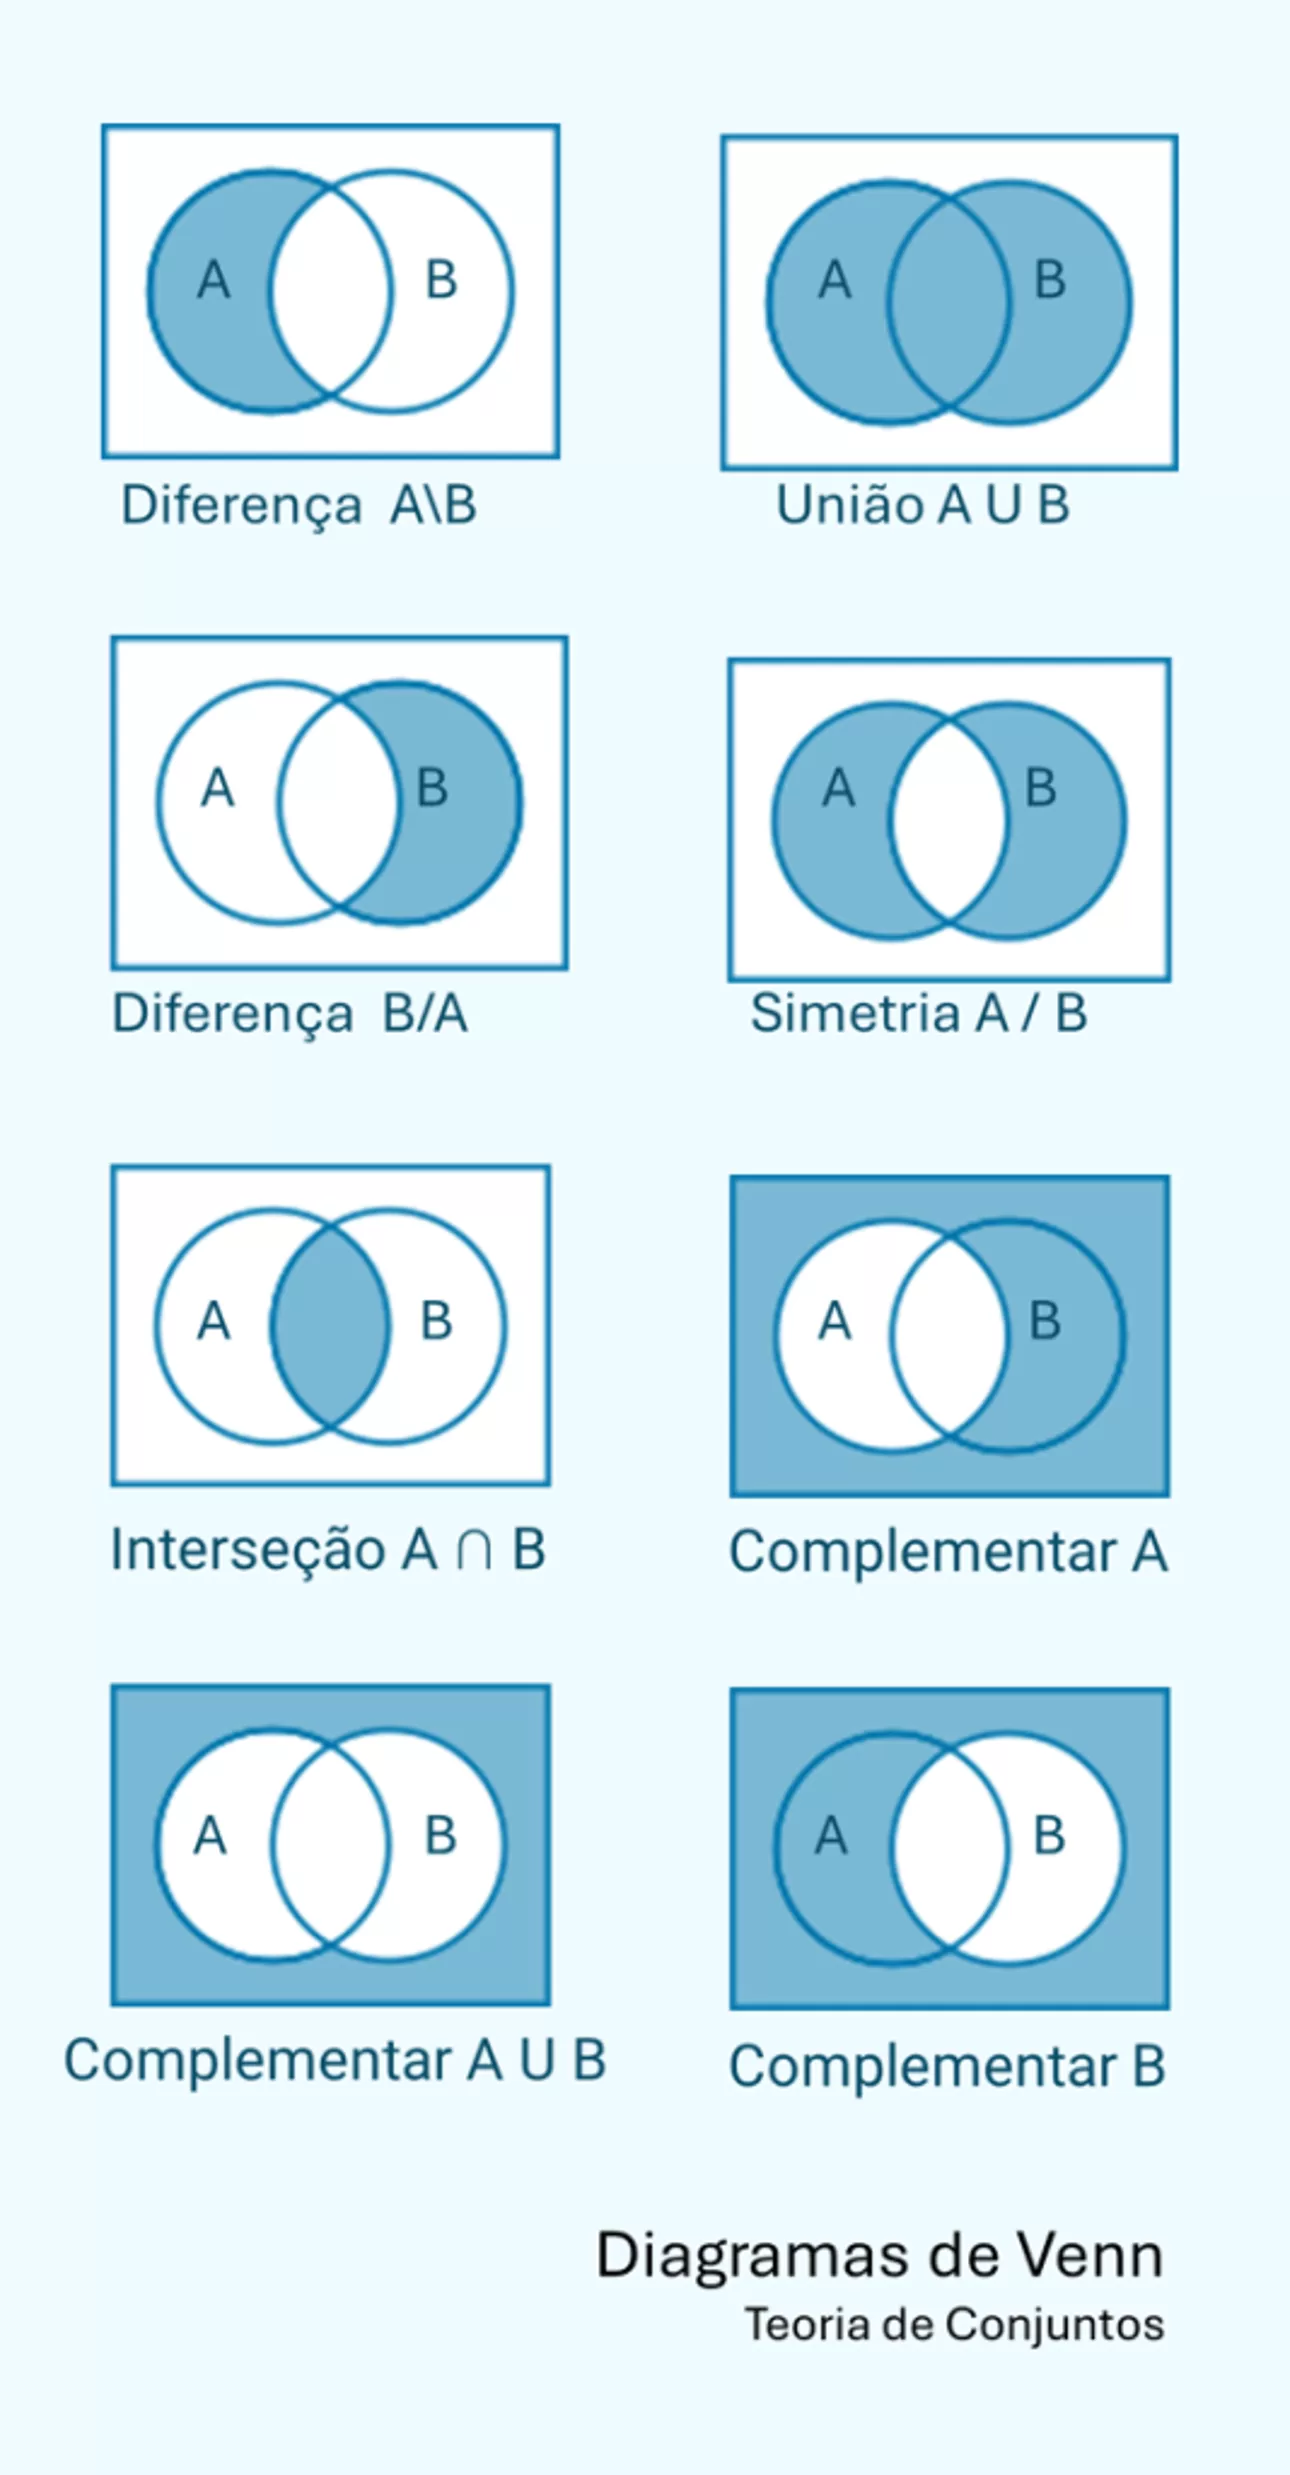
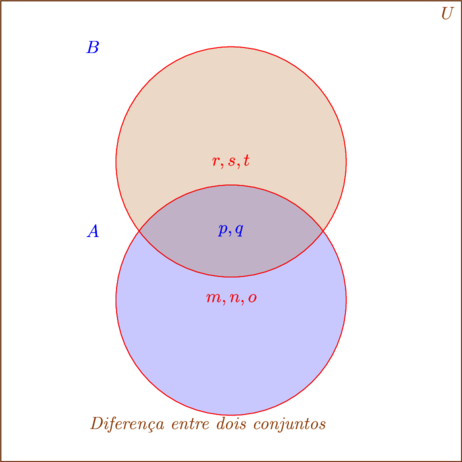
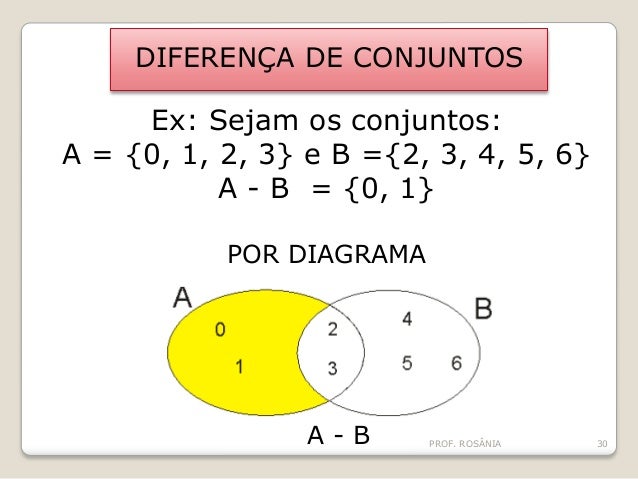
A diferença de conjuntos é simplesmente o que sobra quando você tira os elementos de um conjunto A dos elementos de um conjunto B. A notação matemática é A \ B, e o resultado é o conjunto formado por todos os elementos que pertencem a A mas não pertencem a B. Parece óbvio, mas é onde muita gente erra pela primeira vez, especialmente quando os conjuntos envolvem números decimais ou intervalos. Vou mostrar o método direto, sem rodeio. Você pega o conjunto A, examina cada um dos seus elementos, e verifica se esse elemento existe também no conjunto B. Se existir, descarta. Se não existir, mantém. O que sobrar é a diferença de conjuntos.
Diferença de conjuntos: o que realmente acontece
Usando notação formal: A \ B = {x | x A e x B}. Essa fórmula já diz tudo, mas muita gente lê rápido e esquece a ordem. A \ B não é a mesma coisa que B \ A. Trocar a ordem troca completamente o resultado. Isso é o erro mais frequente em provas e em execução prática também. Pegando um exemplo concreto: seja A = {1, 2, 3, 4, 5} e B = {3, 4, 6, 7}. A \ B resulta em {1, 2, 5}, porque 3 e 4 existem em B e são removidos. Já B \ A daria {6, 7}, que é outro conjunto completamente diferente. A não-comutatividade da diferença de conjuntos é um detalhe que as listas de exercícios quase sempre testam e que causa perda de pontos desnecessária. No meu caso, trabalhei com conjuntos de IDs de usuários em uma base de dados onde precisei calcular a diferença para identificar cadastros duplicados entre dois sistemas legados. Os dados vinham de fontes diferentes com formatos ligeiramente distintos. Um dos problemas que encontrei foi que o sistema A tinha o campo "cpf" como string com pontos e traços ("123.456.789-00") enquanto o sistema B armazenava apenas os dígitos ("12345678900"). Se eu fizesse a diferença de conjuntos diretamente, nenhum CPF seria reconhecido como igual e o resultado seria completamente equivocado.
A solução que implementei foi normalizar ambas as strings antes da operação, removendo todos os caracteres não numéricos com uma função simples de replace. Depois disso, a diferença de conjuntos funcionou corretamente e identifiquei cerca de 200 IDs que existiam em um sistema mas não no outro. Isso reduziu o tempo de conciliação manual de uns dois dias de trabalho para algo perto de 30 minutos, dependendo da carga. Há nuances que não aparecem em livros introdutórios. A primeira é que a diferença de conjuntos é sensível a duplicatas quando você opera em listas ou arrays ao invés de conjuntos matemáticos. Se A = [1, 2, 2, 3] e B = [2], o resultado depende inteiramente da estrutura de dados que você está usando. Em Python, o set() remove duplicatas automaticamente, então set(A) - set(B) daria {1, 3}. Mas se você precisa preservar a ordem ou contar repetições, a abordagem muda completamente e você acaba usando list comprehension com filtros, o que é mais lento mas mais preciso para certos casos. O segundo ponto contra-intuitivo é que diferença de conjuntos não é transitiva. Se A \ B = {} e B \ C = {}, isso não implica que A \ C = {}. Os conjuntos podem ter interseções parciais que só aparecem quando você compara diretamente. Em projetos reais de engenharia de dados, já vi gente assumir essa transitividade e pular etapas de validação, o que gerou inconsistências que levaram semanas para serem detectadas.
Em termos de performance, a complexidade de calcular a diferença de conjuntos depende da estrutura. Com sets em Python, a operação é O(n) onde n é o tamanho do primeiro conjunto, porque a busca em hash é constante. Com listas, vira O(n*m) porque cada elemento de A precisa ser verificado contra todos os elementos de B. Para conjuntos pequenos, a diferença é irrelevante, mas a partir de cem mil elementos, escolher a estrutura errada pode transformar uma operação que leva segundos em uma que leva minutos. O principal limitação da diferença de conjuntos como ferramenta analítica é que ela não lida bem com dados fuzzy ou aproximados. Se você tem {"maria silva"} e {"maria silva."}, matematicamente são elementos diferentes. Em contexto real, provavelmente são a mesma pessoa. Nesse cenário, a diferença de conjuntos pura falha e você precisa de uma etapa prévia de normalização ou de uma métrica de similaridade string, como distância de Levenshtein, antes de aplicar a operação. Outro cenário onde a técnica mostra suas limitações claras é com intervalos contínuos. Diferença de conjuntos funciona bem para conjuntos discretos, mas calcular A \ B quando A e B são intervalos reais como [0, 10] e [3, 7] exige tratamento diferente. O resultado não é um único intervalo, pode ser a união de múltiplos intervalos. Ferramentas como NumPy com operações de mask ou bibliotecas especializadas em geometria computacional são mais adequadas para esse caso do que a abstração matemática pura.
Galeria
-
Teoria de Conjuntos e Diagramas de Venn ⋆ Colaborae -

Teoria dos conjuntos - Tipos, pertinência, intersecção, Diagrama de Venn -
019 – Matemática – Aritmética, Teoria dos conjuntos. Diferença entre ... -
Conjuntos
