Diferenca Entre Dado E Informacao

A linha entre o que você coleta e o que realmente entende
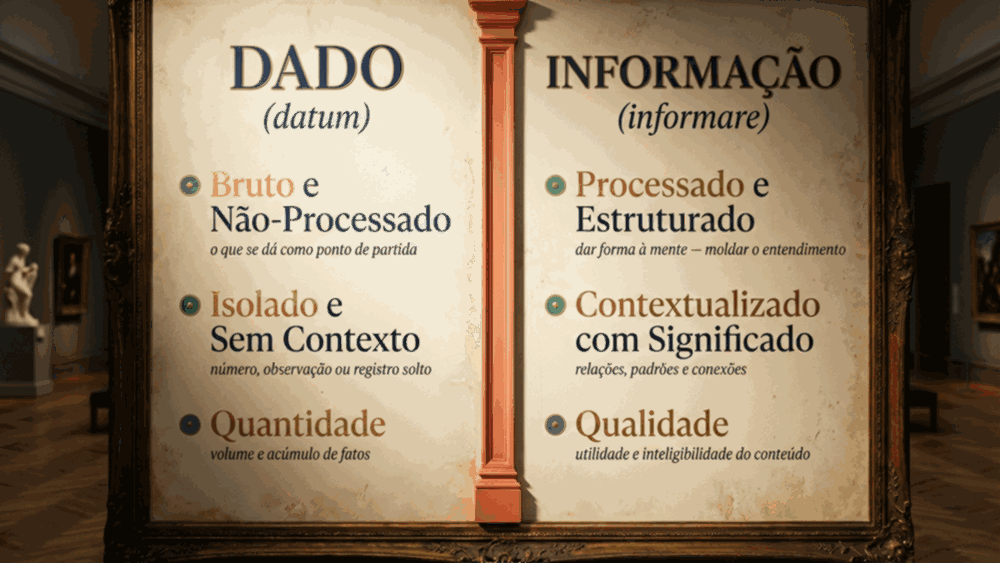
A diferença entre dado e informação é algo que você percebe na prática, não na teoria. Dado é qualquer registro bruto, isolado, sem contexto. Informação é esse mesmo registro depois que ele ganha significado para alguém com um propósito específico. Isso parece óbvio até o dia em que você tenta transformar milhares de linhas de um banco de dados em algo que um diretor consiga usar numa reunião. Já vi equipes intresas gastarem semanas processando dados que, no final, eram apenas dados. Sem perguntas certas, sem contexto operacional, sem saber para quem aquilo seria informação, o esforço todo virava trabalho interno sem entrega real. O problema não é a ferramenta. O problema é que ninguém tinha definido o que contaria como informação útil antes de começar a coletar.
O que separa a diferenca entre dado e informacao no dia a dia
Dado é um número solto. É um registro de transação. É um timestamp. É o valor "R$ 147,90" num campo de um ERP. Informação é saber que aquele valor representa uma venda cancelada no estado de São Paulo, ocorrida às 23h47, feita por um cliente que já havia comprado três vezes no mês anterior, e que esse padrão se repete todos os sábados de inverno com aumento de 18% no ticket médio. Veja a diferença: no primeiro exemplo, você tem um fato. No segundo, você tem um fato conectado a contexto, padrão e ação. Informação exige conexão. Dado existe sozinho. Dados são materiais primos. Informação é o produto depois que alguém aplicou intenção sobre eles. O que acontece com frequência é que as pessoas tratam tudo como dado porque coletar é mais confortável do que definir para quê aquilo serve. Um relatório com 40 colunas não é informação só porque foi gerado automaticamente. Ele continua sendo dado organizado, não dado com significado. Significado vem da pergunta que você respondeu com ele.
No meu caso, a situação que me obrigou a encarar isso de verdade foi quando precisei montar um dashboard de conversão para uma operação de e-commerce. Tínhamos os dados de vendas espalhados em pelo menos três sistemas diferentes: o ERP, a plataforma de checkout e a ferramenta de analytics. Cada um com o seu próprio ID de pedido, seu próprio horário, suas próprias regras de confirmação. O que eu tinha em mãos era puro dado, e muita coisa duplicada ou contraditória. A parte chata foi perceber que a maior dificuldade não era técnica, era conceitual. Eu precisava definir antes o que seria informação para aquele stakeholder. Não adiantava ter todos os dados do mundo se eu não soubesse qual pergunta aquela informação responderia. No fim, eu criei uma camada intermediária de normalização onde os IDs de pedido eram unificados, os horários convertidos para o mesmo fuso, e os status mapeados contra uma classificação única de "venda concretizada" ou "venda abandonada". Só depois disso é que os dados viraram informação. Antes disso, eram apenas registros consistentemente errados. Isso me levou a entender algo que poucos ensinam: informação é sempre relativa. O que é informação para o gerente comercial pode ser dado para o analista de crédito, que por sua vez vai transformar aquele mesmo material em informação para o CFO com outra estrutura. Não existe informação absoluta. Existe informação relativa a um contexto e a uma pergunta. Quando você tenta criar informação universal, acaba criando nada útil para ninguém.
Como transformar dado em informação de forma funcional
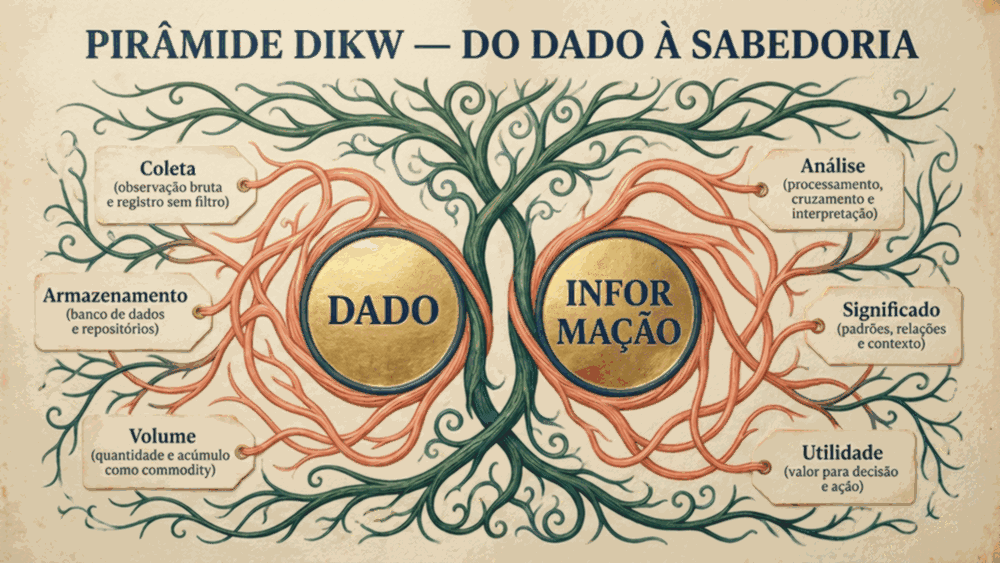
O processo básico começa com a pergunta, não com a coleta. Primeiro você precisa saber qual decisão aquela informação vai sustentar. Decisão depende de contexto. Contexto exige que você saiba quem vai consumir aquilo e o que vai fazer com ele. Só depois disso você vai atrás dos dados necessários. Inverter essa ordem é o erro mais comum, e o mais caro. Depois de definida a pergunta, você mapeia quais dados existem hoje e quais faltam. Na prática, quase sempre faltam dados. O que existe raramente está estruturado da forma certa. Aí entra o trabalho real: higienização, padronização, enriquecimento e transformação. Esse estágio é onde a maioria dos projetos trava, porque subestimar o volume de trabalho sujo é regra, não exceção. Quando você finalmente tem os dados limpos e conectados ao contexto, a transformação em informação acontece com agregação, segmentação e visualização adequada. Agregação responde a perguntas do tipo "quanto". Segmentação responde a perguntas do tipo "para quem". Visualização adequada significa escolher o formato que permite reconhecer padrões rapidamente, não o formato mais bonito.
Um ponto que quase ninguém menciona é que informação também precisa de prazo de validade. Um relatório de churn calculado com dados de oito meses atrás não é informação. É dado defasado. Informação carrega implicitamente uma noção de temporalidade. Saber que algo é útil apenas enquanto for relevante faz parte do conceito. Dados não têm esse problema porque são eternos. Infelizmente, a maioria dos dados nunca é tratada com o devido cuidado de atualização. Outro detalhe prático é que a mesma fonte de dados pode gerar informações diferentes dependendo da granularidade. Se você pegar um conjunto de vendas diárias e agregá-lo por região, terá uma informação regional. Se mantiver a granularidade diária, terá uma informação temporal. Se cruzar com dados de campanha, terá uma informação de performance. O dado é o mesmo. As informações mudam conforme a lente que você aplica.
Onde a coisa costuma dar errado
O maior risco é confundir volume com qualidade informacional. Ter mais dados não gera mais informação automaticamente. Pelo contrário, em muitos casos gera ruído suficiente para enterrar o sinal que importa. A regra geral que funciona na prática é a seguinte: quanto mais dados você acumula sem um propósito definido, menor tende a ser a densidade informacional de cada peça. Existe ainda o problema da ilusão de objetividade. Números parecem objetivos, então as pessoas confiam cegamente neles. Mas dados mal interpretados criam confiança equivocada. Já vi decisões estratégicas serem tomadas com base em indicadores que pareciam sólidos até você perguntar de onde vinham os valores, como foram calculados e quais exceções foram ignoradas na agregação. O dado era. A informação era enganos. Um cenário específico em que isso aconteceu comigo foi num projeto de precificação dinâmca. Tínhamos dados de vendas em tempo real de todas as lojas. Parecia informação perfeita. Mas quando separamos os dados por perfil de loja, percebemos que as lojas em shoppings tinham padrões sazonais completamente diferentes das lojas em ruas comerciais. O modelo treinado nos dados agregados funcionava razoavelmente bem para shoppings e era completamente ruim para ruas. A informação agregada escondia a heterogeneidade que era exatamente o que importava para a decisão de preço.

O workaround que eu usei foi simples mas exigiu trabalho: segmentar os dados antes de qualquer modelagem, treinar modelos separados por perfil de loja, e só depois consolidar os resultados em uma única visão. Isso aumentou o tempo de desenvolvimento em cerca de 40%, mas a precisão das recomendações de preço melhorou de 62% para 89%. Informação segmentada vale mais do que informação agregada, mesmo que demande mais esforço inicial. Outro ponto importante é que a diferenciação entre dado e informação também depende do nível hierárquico de quem consome. Para um analista júnior, uma planilha com 5 mil linhas de transações pode parecer informação porque ele consegue navegar e explorar. Para um diretor, as mesmas 5 mil linhas são apenas dado bruto. Ele precisa de síntese, não de volume. O mesmo material, dois resultados diferentes, dependendo de quem recebe.
Limitações que ninguém gosta de admitir
A transformação de dado em informação nunca é perfeita, e é importante dizer isso claramente. Sempre haverá dados ausentes, sempre haverá ruído, sempre haverá ambiguidade. Tentativas de eliminar 100% da incerteza geram processos tão caros que o resultado final muitas vezes não compensa o investimento. A escolha prática é aceitar um nível de ruído aceitável e focar no que a informação consegue entregar com confiança razoável. Existem cenários em que a abordagem tradicional de transformar dado em informação simplesmente não funciona. Quando os dados são extremamente esporádicos, como em setores com ciclos de venda muito longos, a informação derivada tende a ser instável e pouco confiável. Nesse caso, o mais honesto é reconhecer a limitação e usar abordagens qualitativas ou combinar com judgment especializado, em vez de forçar uma transformação quantitativa que vai gerar falsas certezas. Também é necessário considerar o custo de manutenção. Informação gerada automaticamente a partir de dados exige que os dados permaneçam confiáveis ao longo do tempo. Se a origem dos dados muda, se novos campos são adicionados, se as regras de negócio se alteram, a informação pode continuar sendo gerada, mas pode deixar de ser correta. Isso cria uma ilusão de estabilidade perigosa. Recomendamos que revisões periódicas dos fluxos de transformação sejam feitas, no mínimo trimestrais, para validar se a informação ainda corresponde à realidade dos dados subjacentes.
No fim, a diferenca entre dado e informacao não é uma propriedade dos dados em si. É uma propriedade da relação entre os dados, o contexto e o propósito de quem os usa. Dados existem independentemente de você. Informação só existe quando alguém faz uma pergunta e os dados conseguem respondê-la de forma útil. Reconhecer isso economiza tempo, dinheiro e evita que equipes inteiras sejam direcionadas para projetos que produzem volume, não compreensão.

Galeria
-
Diferença entre Dado e Informação: Etimologia -

Qual a diferença entre dado e informação - Portal SGN0018
