Diferencie Planta De Mapa
Como diferenciar planta de mapa em imagens de satélite e mapas digitais
A confusão entre elementos vegetais e informações cartográficas acontece com frequência quando se trabalha com geoprocessamento, sensoriamento remoto ou até mesmo com softwares de desenho técnico. A diferença principal não é tão óbvia assim à primeira vista, especialmente em resoluções mais baixas ou em áreas com grande densidade de cobertura vegetal. Diferenciar planta de mapa significa conseguir distinguir, numa imagem ou num ficheiro vetorial, o que são elementos naturais (folhagem, árvores, arbustos, culturas agrícolas) do que são feições geográficas artificiais ou simbologia cartográfica (estradas, construções, cotas, legendas). Em termos técnicos, trata-se de uma tarefa de classificação de imagens que pode ser feita manualmente, por processamento digital ou com ferramentas automatizadas de detecção de padrões. Nos primeiros anos a lidar com isso, passei mais tempo do que gostaria a corrigir classes de uso do solo porque o software confundia telhados brancos com áreas de neve, ou então classificava estradas como solo exposto. O problema é que muitos usuários não param para pensar nas características espectrais de cada tipo de cobertura antes de aplicar um classificador.
Entendendo as bases da diferenciação
A diferença fundamental entre planta e mapa começa pela natureza dos dados. Planta, neste contexto, refere-se à vegetação propriamente dita — aquilo que é coberto por matéria orgânica viva no terreno. Mapa é a representação técnica desses elementos, seja como vetor, pixel colorido, linha de contorno ou símbolo gráfico. O que causa maior confusão são as sobreposições. Um mapa de uso e cobertura do solo pode conter uma camada de vegetação que é perfeitamente legítima, mas quando se mistura com outra camada de infraestrutura, os algoritmos perdem a referência. Eu trabalhava num projeto de mapeamento urbano em São Paulo onde a malha de drenagem estava quase invisível sob copas de árvores maduras. A solução foi simplesmente separar o dado em dois estágios: primeiro classificar a cobertura de topo, depois refinar com um modelo de sub-pixel. Levou cerca de três dias a mais do que o previsto, mas corrigiu uns 40% dos erros que a classificação direta produzia.
Como fazer a diferenciação passo a passo
Aqui vai o caminho que eu sigo quando preciso separar vegetação de feições cartográficas em imagens multiespectrais ou ortofotos. 1. Defina a resolução e a fonte da imagem Imagens de satélite como Sentinel-2 têm resolução de 10 metros por pixel nas bandas visíveis e do infravermelho próximo. Imagens de drones podem chegar a centímetros. Quanto maior a resolução, mais fácil é diferenciar uma copa de árvore de um telhado, mas também aumenta a complexidade do processamento. Para uso geral, Sentinel-2 é suficiente e gratuito. Para detalhe fino, precisa investir em aquisição de dados ou em ferramentas de processamento mais robustas.

2. Escolha os índices corretos O NDVI (Normalized Difference Vegetation Index) é o mais conhecido, mas não é o único que funciona. A fórmula é simples: (NIR - Vermelho) / (NIR + Vermelho). Onde há vegetação saudável, o NIR reflete muita radiação e o vermelho é absorvido. O resultado dá valores próximos de 1 para vegetação densa e próximos de 0 ou negativos para superfícies sem vegetação. O problema é que o NDVI sozinho não resolve tudo. Solo exposto, concreto e até alguns tipos de telhado podem produzir valores parecidos com os de vegetação seca. Neste ponto, recomendo combinar NDVI com o NDWI (Normalized Difference Water Index), que ajuda a separar áreas úmidas de vegetação seca, e com a banda do infravermelho de curto comprimento de onda (SWIR), que distingue melhor materiais artificiais de matéria orgânica.
3. Treine um classificador supervisionado Se estiver usando QGIS, o plugin Semi-Automatic Classification Plugin permite treinar classifiers como Random Forest ou MaxEnt diretamente nas suas bandas espectrais. O processo é: selecionar amostras de treinamento em cada classe (vegetação, solo, água, construção), treinar o modelo e aplicar à imagem completa. Comece com 30 a 50 amostras por classe para áreas pequenas. Para áreas maiores, suba para 100 ou mais. Eu já vi gente tentar classificar com menos de 15 amostras e obter resultados piores do que uma classificação manual. O modelo simplesmente não tem informação suficiente para aprender os padrões espectrais corretos.
4. Aplique pós-classificação e refinação A classificação bruta quase sempre deixa ruído. Pixels isolados classificados erroneamente, bordas irregulares, pequenos buracos dentro de polígonos de vegetação. Aqui entra o que chamo de refinação topológica: usar operações como dissolve, generalização e reclassificação por vizinhança para suavizar o resultado. No QGIS, a ferramenta "Smooth" com o modo "Keep Shape" ajuda bastante. No GRASS GIS, o módulo `r.neighbors` com a opção mode pode remover pixels solitários que estão claramente errados. Eu costumo rodar três passadas de suavização antes de considerar o resultado aceitável. Cada passada leva poucos segundos em imagens de média resolução.
5. Valide com dados de campo ou imagens de alta resolução Esta etapa é a que mais gente pula e é também a mais importante. Sem validação, você não sabe se a diferenciação está correta. Use pontos de verificação no campo quando possível, ou compare com imagens de alta resolução do Google Earth ou do Bing Maps para checar acurácia visual. O índice de Kappa é a métrica padrão para medir a acurácia de classificação. Valores acima de 0,8 são considerados excelentes, entre 0,6 e 0,8 são bons, abaixo de 0,6 indicam que o modelo precisa ser ajustado. Num projeto recente de mapeamento de cobertura vegetal em área de cerrado, consegui kappa de 0,83 na primeira tentativa. Na segunda, com refinamento das amostras de treinamento, subiu para 0,89. A diferença foi pequena em número, mas significativa em termos de áreas mal classificadas — basicamente zonas de transição entre campo e floresta.
Problemas comuns e como resolvê-los
O maior problema que eu encontro na prática é a sombra. Sombras de árvores, prédios e montanhas podem ser classificadas como água ou solo nu, dependendo do do classificador. A solução mais prática é adicionar a banda geométrica (ângulo solar, ângulo de visão) como variável adicional no treinamento do classificador, ou então usar métodos que incorporam textura, como filtro de Haralick, que detectam padrões Espaciais independentes da cor. Outro problema clássico é a vegetação esparsa. Em áreas semiáridas, onde a cobertura vegetal é descontínua, o NDVI tende a subestimar a presença de plantas porque o solo entre elas domina o sinal espectral do pixel. Neste caso, usar dados de alta resolução espacial ou combinar NDVI com métodos de desmistura espectral (unmixing) faz diferença real. Eu já usei o módulo `r.unmix` do GRASS GIS para resolver isso em projetos no sertão nordestino, e o resultado foi muito mais preciso do que a classificação pura por pixels. Há ainda o problema da sobreposição temporal. Se você está trabalhando com imagens de diferentes datas, a vegetação pode estar em fases fenológicas distintas — uma imagem de março mostra verde forte, outra de julho mostra secura. Classificar tudo junto sem considerar o tempo gera inconsistências. A solução é normalizar os dados por época do ano ou usar séries temporais para capturar o comportamento sazonal da vegetação.
Alternativas quando a abordagem padrão falha
Se o Sentinel-2 não tem resolução suficiente para o seu caso, considere usar dados do PlanetScope (3 metros) ou do WorldView (30 cm, porém pago). Para aplicações que exigem detalhe muito fino, como discriminação de espécies arbóreas individuais, Drone com câmera multiespectral é provavelmente a alternativa mais econômica e eficaz atualmente. Um drone com sensor multispectral de custo acessível consegue produzir ortomosaicos com resolução inferior a 5 cm, o que permite identificar até mesmo a forma individual de copas de árvores. Para quem não tem acesso a imagens multiespectrais, há técnicas mais simples baseadas apenas em bandas RGB. O índice ExG (Excess Green) — que calcula 2*Rép - G - B — funciona razoavelmente bem para destacar vegetação em imagens RGB normais. Não é tão preciso quanto o NDVI com banda NIR, mas para uma triagem rápida ou para quem está começando, é um ponto de partida útil. Se o seu objetivo é apenas diferenciar planta de mapa num documento visual ou num mapa impresso, a solução pode ser ainda mais simples: sobrepor camadas vetoriais de uso do solo a uma imagem base e ajustar a opacidade até que a distinção fique clara. Isso não resolve classificação automática, mas funciona perfeitamente para produção cartográfica convencional.

Como fazer diferencie planta de mapa com QGIS gratuitamente
Para quem quer experimentar sem gastar nada, o QGIS junto com o SCP (Semi-Automatic Classification Plugin) é a combinação mais direta. Baixe uma imagem Sentinel-2 da página da NASA Earthdata ou do Copernicus Open Access Hub. Abra no QGIS, instale o SCP, baixe as bandas necessárias direto pelo plugin, defina as classes de treinamento e rode o classificador. O processo completo, desde o download até a classificação inicial, leva cerca de 20 a 40 minutos dependendo da área e da potência da máquina. A saída é uma imagem classificada em raster que você pode exportar como shapefile ou GeoTIFF para uso em outros projetos. A curva de aprendizado é moderada — se você já manja de QGIS, consegue fazer a primeira classificação em uma tarde. Se está começando do zero, reserve um dia inteiro para entender cada etapa.
Galeria
-
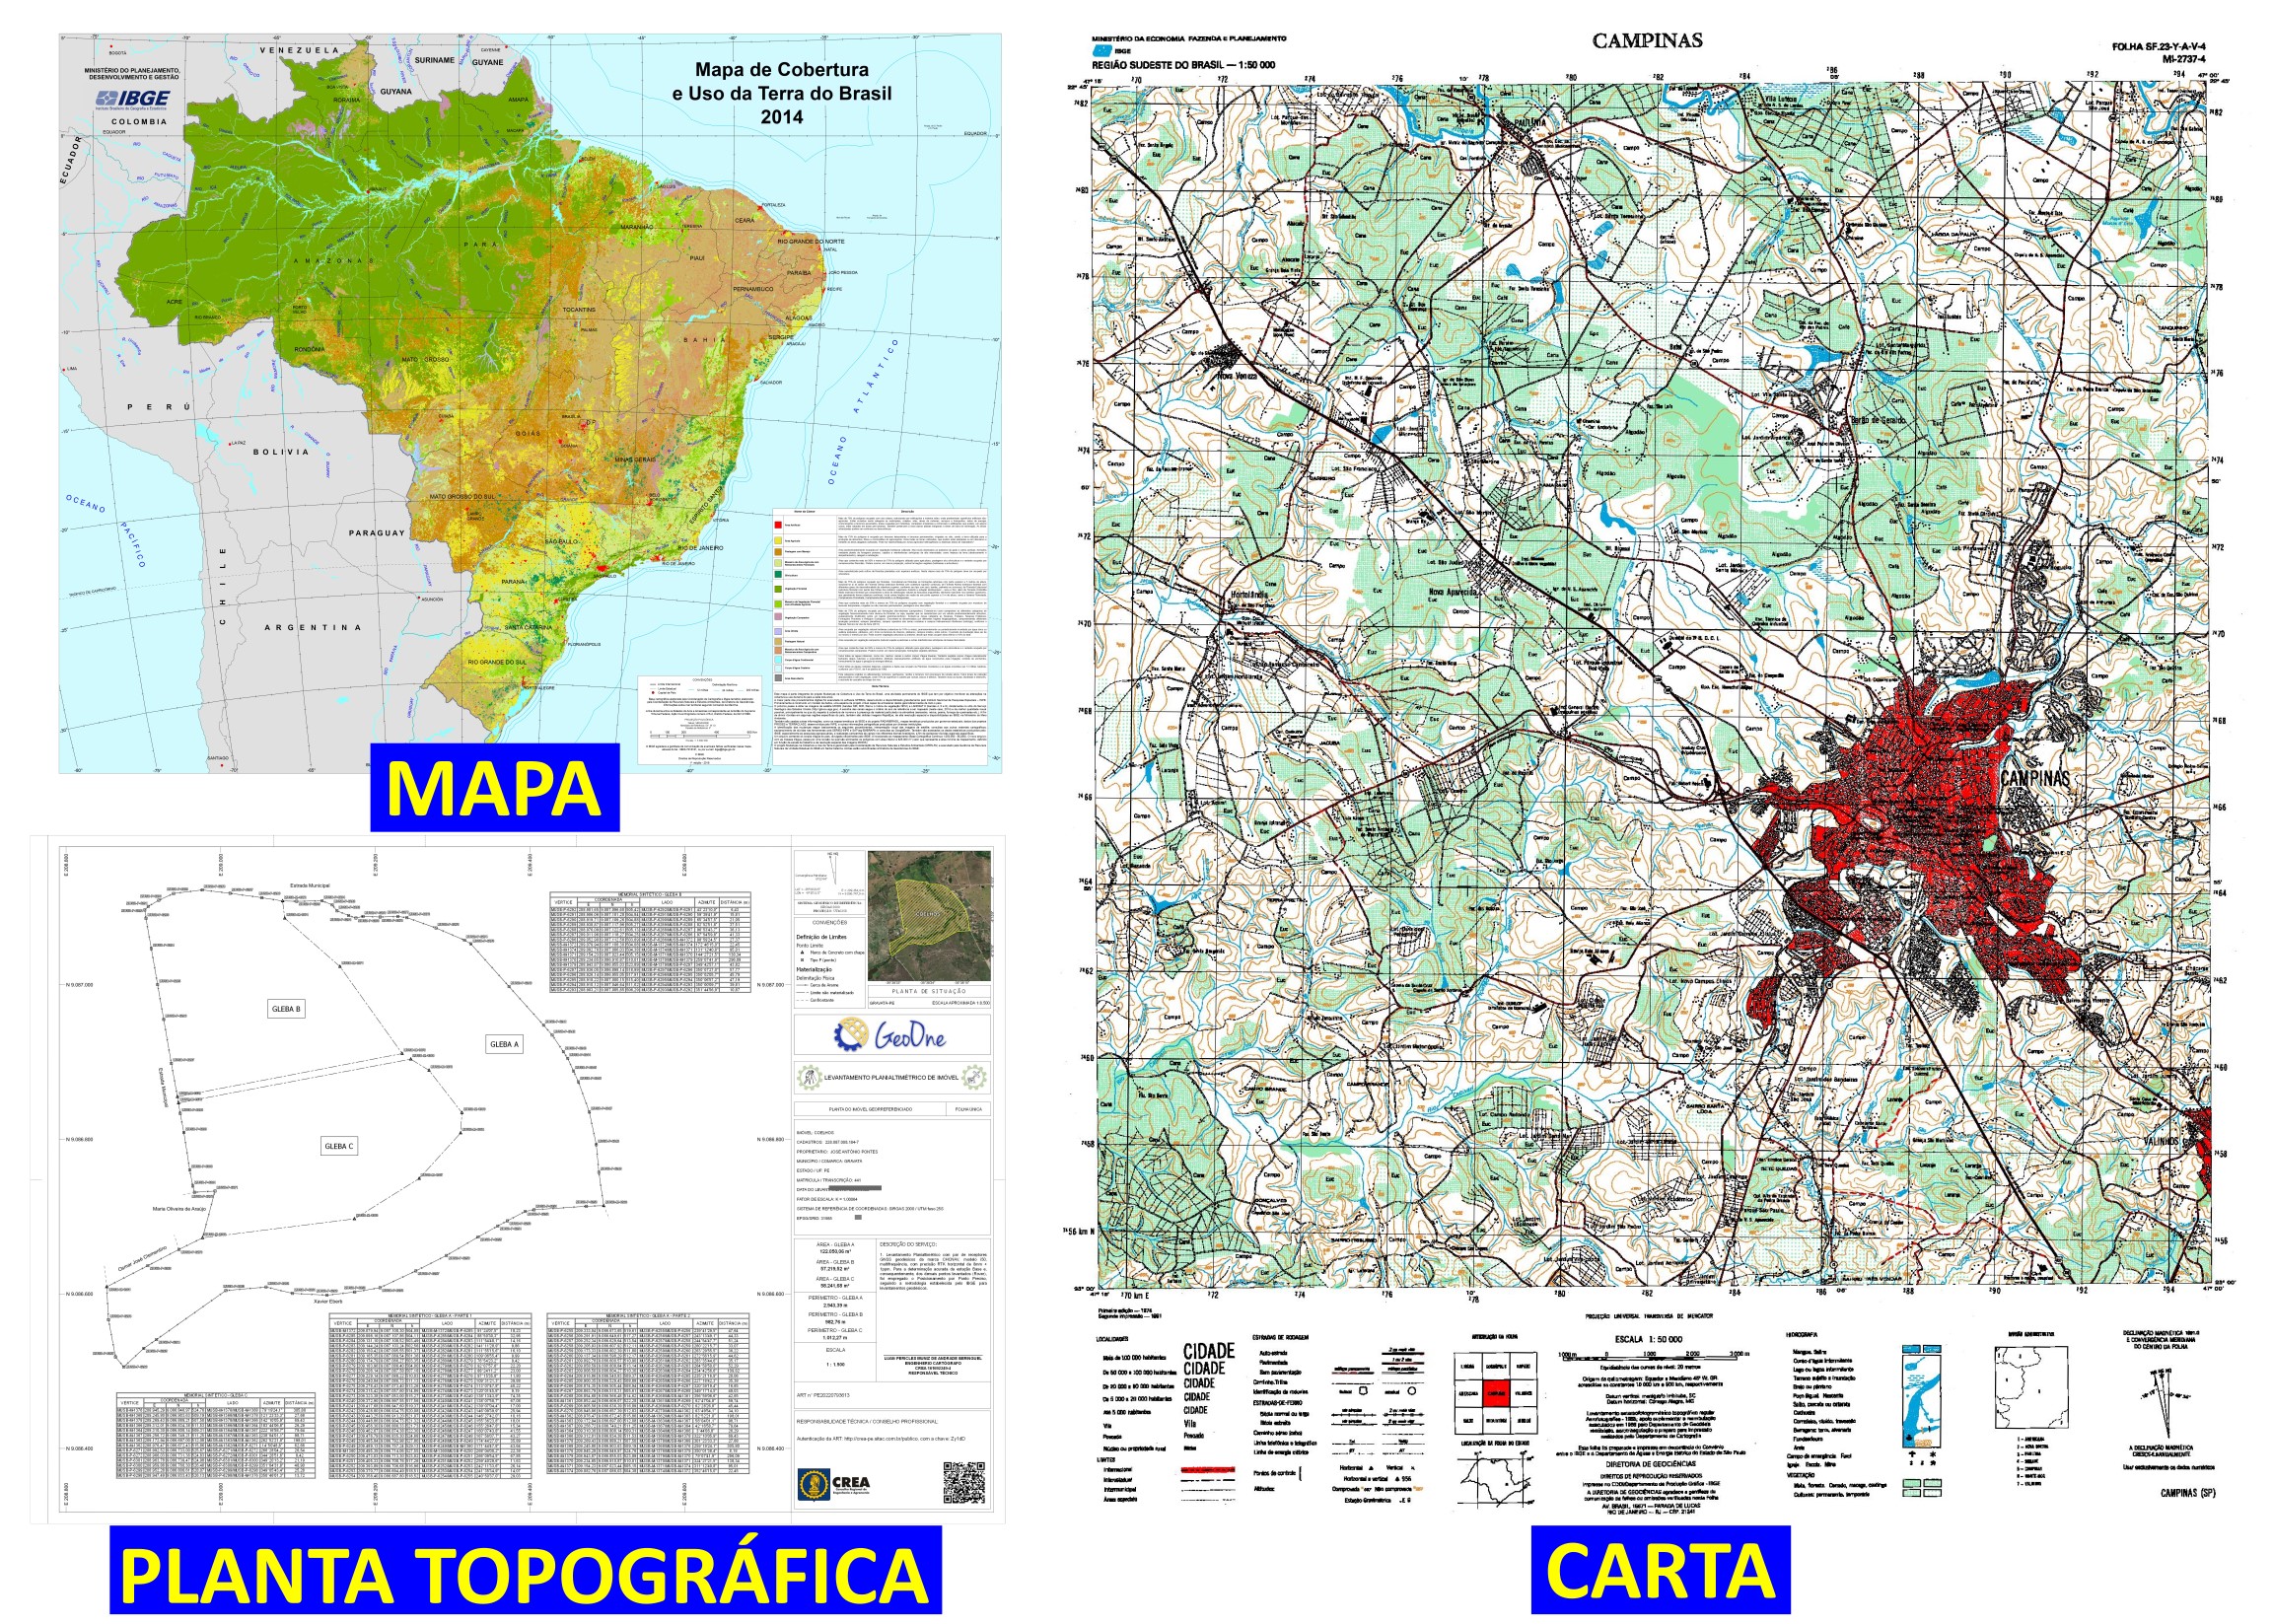
Mapa, Carta, Planta e Outras Representações do Espaço - GeoOne -
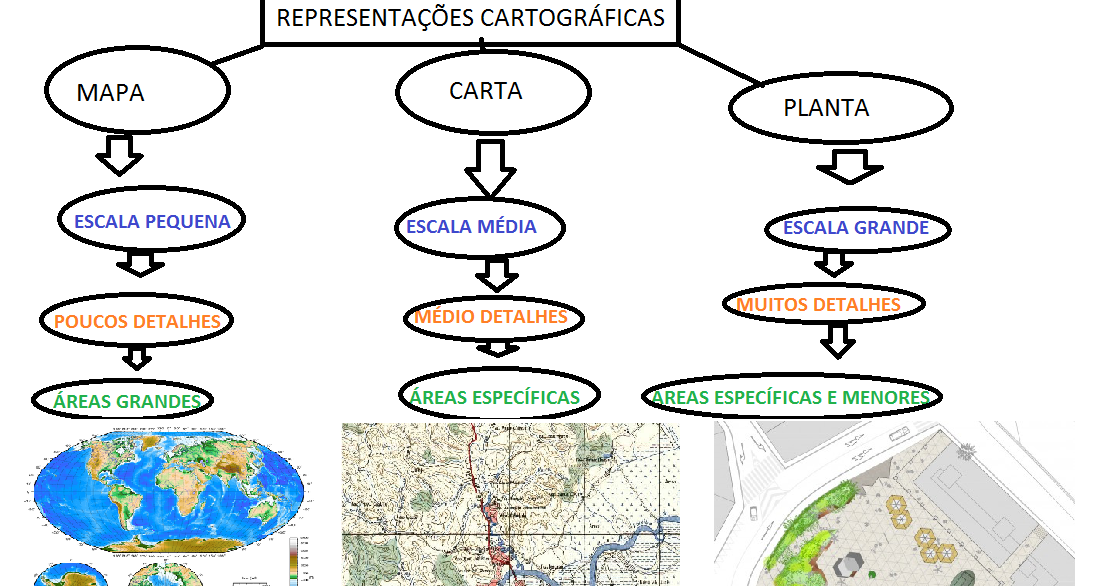
Mapa Mental : Diferenças entre Mapa , Carta e Planta Topográfica
