Distribuição De Frequencia Com Intervalo De Classe
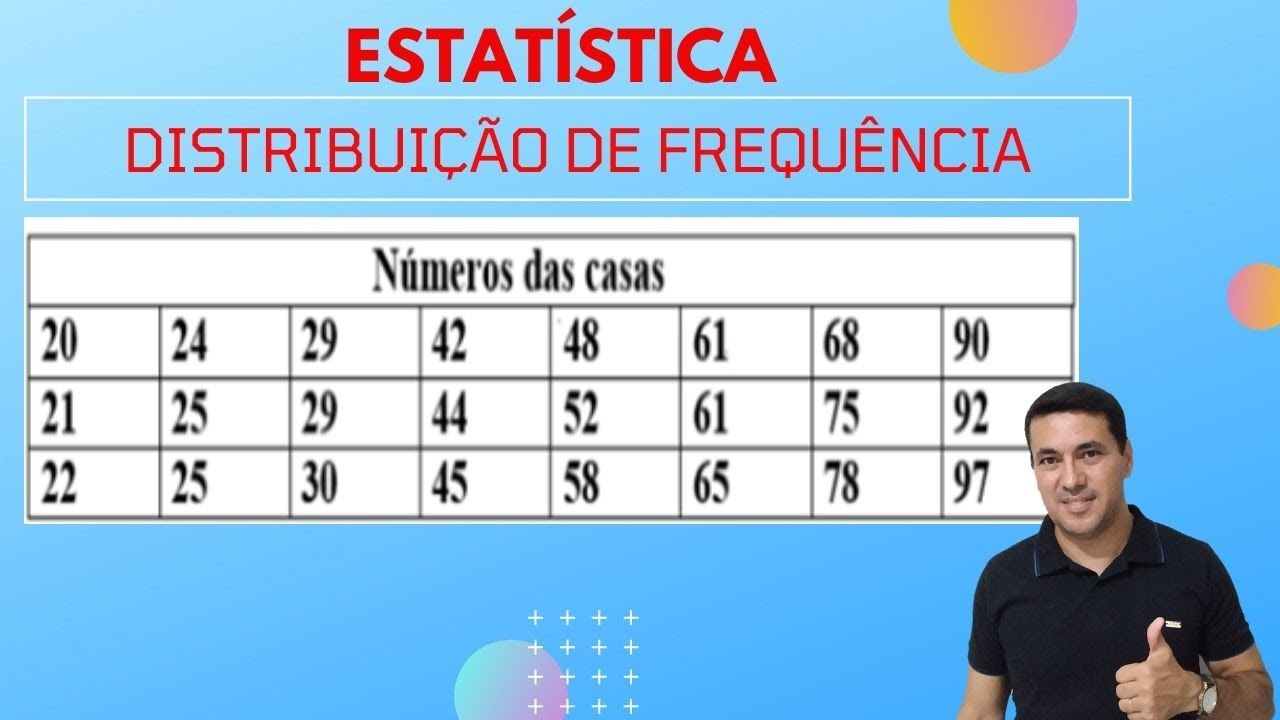
Montando uma distribuição de frequência com intervalo de classe na prática
A primeira coisa que todo mundo esquece ao montar uma distribuição de frequência com intervalo de classe é que os dados precisam estar organizados antes de qualquer coisa. Ordenar uma lista de 80 valores manualmente é um gasto de tempo que não vale a pena. Eu sempre peço para alguém rodar um ROL no Excel ou usar o comando sort do R antes de abrir qualquer plano de classes. Se os dados estiverem desordenados, o primeiro e o último valor que você identifica vão estar errados, e todo o resto da tabela herda esse erro desde o início.
O que é distribuição de frequencia com intervalo de classe
É basicamente um jeito de agrupar valores contínuos em faixas, chamadas classes, e contar quantos observações caem em cada uma. A ideia principal é transformar um rol de dados brutos — que pode ter centenas de linhas — em algo legível, tipo uma tabela com 5 a 12 classes no máximo. Sem isso, você passa a tarde olhando números e não aprende nada novo.O cálculo começa com a amplitude total, que é o valor máximo menos o valor mínimo do seu conjunto de dados. Digamos que você tenha idades de 18 a 73 anos. A amplitude total é 55. A partir daí você define quantas classes quer usar. A regra de Sturges é um ponto de partida razoável: k = 1 + 3,322 × log(n), onde n é o número de observações. Para 80 dados, isso dá cerca de 7 classes. Não siga Sturges como se fosse lei. Ela tende a subestimar o número de classes quando os dados têm muitos valores repetidos, e a tabela fica com faixas muito largas, perdendo informação importante no meio do distribuição. A amplitude de cada classe se calcula dividindo a amplitude total pelo número de classes, e normalmente se arredonda para cima para um número mais fácil de trabalhar. Amplitude 55 dividida por 7 classes dá 7,86. Eu arredondo para 8. Isso é intencional: se você arredondar para baixo, as classes podem não cobrir todos os dados e você fica com valores sobrando fora da última classe. Os limites das classes ficam então definidos assim: a primeira vai de 18 a menos de 26, a segunda de 26 a menos de 34, e assim por diante, até cobrir o valor máximo. Note que estou usando a notação [a, b), com o limite inferior incluso e o superior exclusivo. Isso evita ambiguidade. Se um valor for exatamente 26, ele entra na segunda classe, não na primeira. Parece óbvio, mas eu vi muita gente colocar o mesmo valor em duas classes porque não estabeleceu essa convenção antes de fechar a tabela.
A frequência de cada classe é simplesmente a contagem de dados dentro daquele intervalo. Você pode fazer isso de várias formas: marcando com tally, usando fórmulas no Excel com CONT.SE, ou um simples GROUP BY no SQL. O que eu prefiro é usar CONT.SESobrepostos quando tenho classes que não são inteiras, porque a funçãoConta.Se simples falha quando o limite superior de uma classe é igual ao inferior da próxima e os dados têm casas decimais.
Um problema real que eu encontrei e como resolvi
Trabalhando com dados de temperatura ambiente coletados a cada 15 minutos durante três meses, eu montei uma distribuição com intervalos de 2 graus. No total eram 12.960 registros. Quando cheguei na última classe, percebi que dois valores de 35,00 estavam sendo excluídos porque meu limite superior era estritamente menor que 35, e a última classe ia de 34 até 35, sem incluir 35. Como dois registros tinham temperatura exatamente 35,00, a soma das frequências dava 12.958, não 12.960. Faltavam dois pontos. A solução foi deixar a última classe como semiaberta por baixo e fechada por cima, ou seja, [34, 35], enquanto todas as outras permaneciam semiabertas [a, b). Dessa forma, o limite superior da última classe pega os valores exatos sem ambiguidade. Eu nunca mais esqueci disso.
Outro detalhe que as pessoas ignoram: a frequência relativa. Ela se calcula dividindo a frequência de cada classe pelo total de observações. A soma das frequências relativas deve dar 1,00, ou 100% se você preferir em percentual. Se não der, tem algo errado na contagem ou nas classes não cobrem todos os dados. Eu rodo uma verificação automática com SOMA dos relativos — se o resultado ficar fora de 1,00 ± 0,001, eu volto e conferia cada classe individualmente. Quando os dados têm muitos valores idênticos, como notas escolares que só variam entre 0 e 10 com uma casa decimal, a regra de Sturges não funciona bem. O número de classes ideal aumenta, porque Classes muito amplas agrupam muitas notas iguais juntas e você perde a variação real. Nesse caso, eu uso a regra de Scott, que calcula a amplitude da classe como 3,5 × desvio padrão dividido pela raiz quadrada de n. Scott tende a produzir mais classes do que Sturges para conjuntos pequenos, mas para dados discretos com pouca variabilidade, ela preserva melhor a estrutura dos dados. Um erro comum é confundir amplitude de classe com limite das classes. A amplitude de classe é a largura de cada faixa. Os limites são os valores numéricos que separam uma classe da outra. Se você misturar essas duas coisas na hora de escrever a tabela, quem for ler vai entender errado e a interpretação sai distorcida. Anotar explicitamente qual é a amplitude de cada classe no cabeçalho evita essa confusão.
A histograma é a representação gráfica mais adequada para dados agrupados em classes, e a área de cada barra deve ser proporcional à frequência, não apenas a altura. Se as classes tiverem amplitudes diferentes — o que acontece quando você não usa intervalo constante — e você desenhar apenas a frequência absoluta no eixo Y, as barras maiores vão parecer mais importantes do que realmente são. A solução é usar densidade de frequência no eixo vertical: frequência relativa dividida pela amplitude da classe. Assim a área total do histograma representa a proporção correta dos dados. Se seus dados são qualitativos nominais, como cor dos olhos, distribuição de frequência com intervalo de classe não se aplica de forma alguma. Classes só fazem sentido para variáveis quantitativas contínuas ou discretas com suficiente variação. Tentar criar intervalos para dados categóricos gera uma tabela sem sentido prático e ninguém consegue tirar nenhuma conclusão útil dela. Outra limitação séria: se o número de dados for pequeno, digamos menos de 30, qualquer plano de classes que você escolher vai ser arbitrário. Sturges dá 5 ou 6 classes, Scott dá 4 ou 5, mas o resultado muda drasticamente dependendo do método. Nessas situações, eu recomendo apresentar os dados brutos ordenados em vez de forçar uma distribuição em classes. Uma tabela de frequência simples, com cada valor único e sua contagem, é mais honesta e mais informativa do que classes forçadas.
Para quem quer repetir o processo rapidamente, eu recomendo começar com uma planilha Excel contendo as colunas: Valor, Limite Inferior, Limite Superior, Frequência, Frequência Relativa, Densidade. Uma única fórmula com SE aninhado ou, melhor ainda, uma medida no Power Query classificando cada linha pela classe correspondente automatiza todo o processo. Dados de teste de 10 mil linhas levam menos de 3 segundos para serem processados dessa forma. Se você fizer manual, leva 40 minutos e provavelmente comete erros de contagem.
Dados e referências
Se precisar de uma base para testar, o repositório do R com o dataset mtcars ou o iris já vêm com variáveis quantitativas prontas para prática. Para dados brasileiros, a base do SIDRA do IBGE permite exportar séries temporais que se adaptam bem a exercícios de distribuição de frequência. O pacote distributions do R ou as funções nativas do Python com pandas.cut facilitam muito a construção automática de classes e contagens.
Na hora de montar sua primeira tabela, eu sugiro fazer três versões: uma com Sturges, uma com Scott e uma com intervalo fixo arbitrário de sua escolha. Compare como a forma dos dados aparece em cada uma. As diferenças costumam ser grandes e reveladoras sobre o que seus dados realmente mostram.
Galeria
-
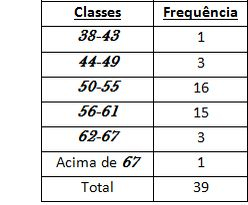
Distribuição de Frequência: Tabela de Distribuição e Mais | Responde Aí -

DISTRIBUIÇÃO DE FREQUÊNCIA - ppt carregar -

Distribuição frequência para dados agrupados em classe - Estatística ...
