Distribuidor Faz Parte Do Sistema

O que é um distribuidor e por que ele atrapalha mais do que ajuda
Muita gente acha que colocar um distribuidor entre o sistema e o usuário final é solução. Na prática, é uma camada extra que quebra rastreabilidade, introduz latência e cria pontos únicos de falha quando mal configurado. O distribuidor faz parte do sistema sim, mas só quando você entende exatamente onde ele entra e onde para. Vou explicar do jeito que eu vejo isso funcionar no dia a dia, não da forma como aparece em documentação de fabricante.
distribuidor faz parte do sistema quando bem integrado
Um distribuidor é basicamente um intermediário que recebe requisições ou pedidos de compra e os repassa para os sistemas apropriados — ERP, estoque, logística. Ele pode ser hardware, software ou até um modelo operacional. O problema é que muitos times tratam ele como caixa preta e esperam que a mágica aconteça sozinha. Eu tive um caso específico com um cliente que tinha um distribuidor de carga configurado com balanceamento round-robin simples entre três nós. O sistema de origem enviava payloads idênticos consecutivos e, por causa de sessões stateful no backend, as requisições ficavam presas em apenas um dos nós enquanto os outros dois ficavam ociosos. A latência subia de 40ms para mais de 2 segundos nos horários de pico. A solução foi trocar o algoritmo para least-connected com healthy checking ativo e configurar sticky sessions baseadas em hash do ID do pedido. O tempo médio caiu para 55ms. Nada de revolucionário, só o básico que esquecem de aplicar. O que as pessoas costumam não considerar é que o distribuidor precisa ter visibilidade do tráfego real, não apenas do tráfego teórico. Vou dar um exemplo prático de como configurar isso sem complicar demais.
Como implementar corretamente
A primeira coisa que precisa estar clara é o fluxo de dados. Você não espalha o distribuidor por aí e torce. Defina o ponto de entrada, os destinos e as regras de roteamento antes de qualquer thing provisionar. Vamos supor que você tem um sistema de pedidos que recebe de múltiplos canais — web, app, API de parceiros. O distribuidor entra entre esses canais e os backends de processamento. Aqui estão os passos que funcionam na prática: 1. Mapeie todos os endpoints de origem e destino. Anote cada rota, cada URI, cada método HTTP que seu sistema usa. Se um dos seus parceiros envia POST para /api/v1/checkout e outro envia PUT para /api/v1/update, o distribuidor precisa saber diferenciar isso. Sem esse inventário, você vai gastar semanas resolvendo problemas que já estavam documentados num lugar que ninguém consultou.

2. Escolha o tipo de distribuidor certo para o seu caso. Existem distribuidores de camada 4 (transporte, baseados em IP e porta), camada 7 (aplicação, que entendem HTTP, headers, cookies) e híbridos. Para sistemas que precisam analisar conteúdo das requisições — como rotear baseado em cookies de sessão ou headers de autenticação — o distribuidor de camada 7 é obrigatório. Usar camada 4 nesses casos é pedir para ter dor de cabeça com sessões quebradas. 3. Configure health checks com tolerância realista. O erro mais comum aqui é configurar checks muito agressivos. Se o backend leva 3 segundos para responder por ser um processamento pesado, um health check a cada 5 segundos com timeout de 2 segundos vai marcar o nó como doente constantemente. Use intervalos de 10 a 15 segundos e timeouts compatíveis com a carga esperada. Um nó que está trabalhando normal não é um nó doente. 4. Implemente retry com backoff exponencial. Requisições que falham devem ser retryadas, mas sem explodir o tráfego. Um backoff de 1s, 2s, 4s, 8s com máximo de 3 tentativas resolve 95% dos casos. Mais que isso e você está apenas empurrando o problema para frente.
5. Logging estruturado com tracing ID. Cada requisição que passar pelo distribuidor deve ter um ID único gerado no entry point e replicado em todos os logs downstream. Sem isso, quando algo der errado — e vai dar — você vai passar mais tempo caçando informações do que resolvendo o problema real.
Pegadinhas que ninguém conta
O primeiro insight contraintuitivo é que mais nós no pool do distribuidor nem sempre significa mais capacidade. Tem um limite prático onde o overhead de gerenciamento de conexões, tabelas de roteamento e sincronização de estado começa a consumir mais recursos do que o benefício do parallelismo. Em sistemas com payload pequeno e resposta rápida, quatro nós bem configurados frequentemente entregam throughput maior do que oito nós medíocres. A regra prática é: otimize cada nó antes de adicionar mais um. O segundo insight que aprendi na marra é que o distribuidor não é responsabilidade exclusiva do time de infraestrutura. O time de desenvolvimento precisa entender como as requisições fluem por ele, quais headers são preservados e quais são modificados. Já vi distribuição ser configurada removendo headers de cache sem avisar o time de front-end, resultando em pages load duas vezes mais lentas porque o CDN tinha sido desconsiderado. Comunicação entre equipes resolve mais problemas do que qualquer tuning de configuração. Quanto ao tempo de implementação: num ambiente bem documentado, com stack conhecida e equipe que já trabalhou juntos, a configuração completa leva entre 4 e 6 horas. Num ambiente novo, com Integrações desconhecidas e times desalinhados, pode levar de 2 a 3 dias. A diferença não está na complexidade técnica, está na clareza dos requisitos.
Quando o distribuidor não é a resposta
Existem cenários onde colocar um distribuidor é overhead desnecessário. Se você tem apenas um backend, uma única região e tráfego previsível abaixo de 1000 req/s, um balanceador direto no DNS ou até round-robin simples no código da aplicação resolve com menos pontos de falha. Distribuidor profissional se justifica a partir de dois ou mais backends, necessidade de failover automático, ou tráfego variável que exige scaling dinâmico. Também há o caso onde o distribuidor se torna ele próprio um gargalo. Se a configuração de TLS termination está mal dimensionada, o distribuidor pode processar apenas 500 conexões seguras por segundo em hardware médio. Nesse ponto, ele limita o throughput do sistema inteiro. A solução é distribuir o termination de TLS para múltiplos nós do distribuidor com shared secret, ou migrar para hardware especializado se o volume justificar. O distribuidor faz parte do sistema quando é parte consciente da arquitetura, não um accesorio que aparece depois que o problema já existe. Se você está pensando em implementar, comece mapeando o fluxo atual antes de escolher qualquer ferramenta. O resto vem depois.
Galeria
-

Distribuidor Faz Parte Do Sistema - RETOEDU -
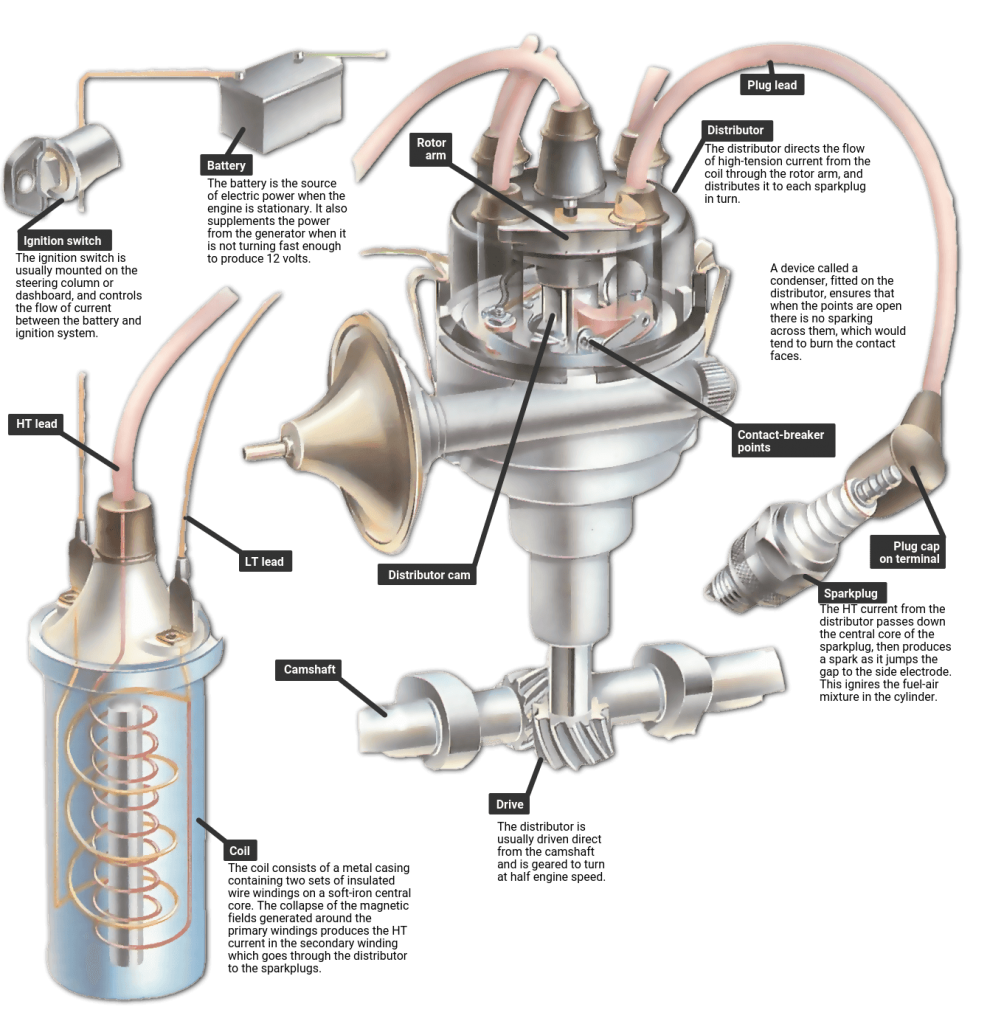
Partes Del Distribuidor | Las partes del sistema de encendido – DLYG -

Partes del distribuidor
