Durante A Produção De Um Software Defeitos Podem Ser Descobertos

O que acontece quando achamos que está tudo certo
A gente passa semanas desenvolvendo, testando, revisando código. Senta na frente do monitor, clica em rodar, e espera que o build passe limpo. De repente, uma falha aparece em produção que ninguém enxergou no ambiente de desenvolvimento. Isso é mais comum do que muita gente admite.
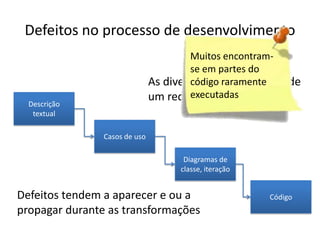
durante a produção de um software defeitos podem ser descobertos em cenários que não simulamos
O problema é que nosso ambiente de teste raramente espelha a realidade. Dados de produção têm volume diferente, latência de rede varia, configurações de servidores são distintas. Eu um projeto onde um método de paginação quebrava só quando o banco tinha mais de dois milhões de registros. Nosso banco de dados de homologação tinha 15 mil linhas. Rodamos os testes unitários, os de integração, tudo passava. Ninguém percebeu que a query carregava todos os registros antes de aplicar o filtro de paginação. O workaround que achei foi ativar o query logging em staging e comparar os tempos de execução com volumes de dados reais. A diferença era brutal: 40 milissegundos versus 8 segundos. Ajustamos a consulta para usar paginação no banco em vez de na memória e o problema desapareceu. O que muita gente não entende é que defeito descoberto em produção não é necessariamente sinal de código ruim. Pode ser sinal de que o ambiente de teste estava inadequado para detectar aquele problema específico.
Existem técnicas que ajudam a reduzir esse gap. Deploy gradativo com feature flags permite liberar para um subconjunto de usuários e monitorar comportamento antes de expandir. Observabilidade bem implementada — logs estruturados, métricas de negócio, traces distribuídos — mostra o que realmente acontece quando o sistema é usado no mundo real. O problema é que essas práticas têm custos. Feature flags acumuladas viram débito técnico. Observabilidade mal configurada gera ruído suficiente para esconder o sinal importante. Métricas de negócio que não refletem a realidade criam uma falsa sensação de segurança. Uma coisa que aprendi na prática é que testes automatizados sozinhos não resolvem. Testes de carga, testes de chaos engineering, revisões de código com foco em edge cases específicos do domínio ajudaram mais do que aumentar cobertura de testes unitários de 85 para 95 por cento. O ganho marginal é pequeno quando o problema real está em como o sistema interage com infraestrutura e dados reais.
Não existe solução perfeita aqui. Qualquer estratégia tem tradeoffs. O importante é entender onde estão os pontos cegos e criar mecanismos para encontrá-los antes que afetem usuários em produção.

Galeria
-

Um Estudo de Caso Sobre Teste de Software » ACerT - Academia Brasileira ... -

Descubra o segredo de como identificar defeitos antes do software estar ... -
Teste de Software | PPTX -
No complexo universo do desenvolvimento de software, termos como erro ...

