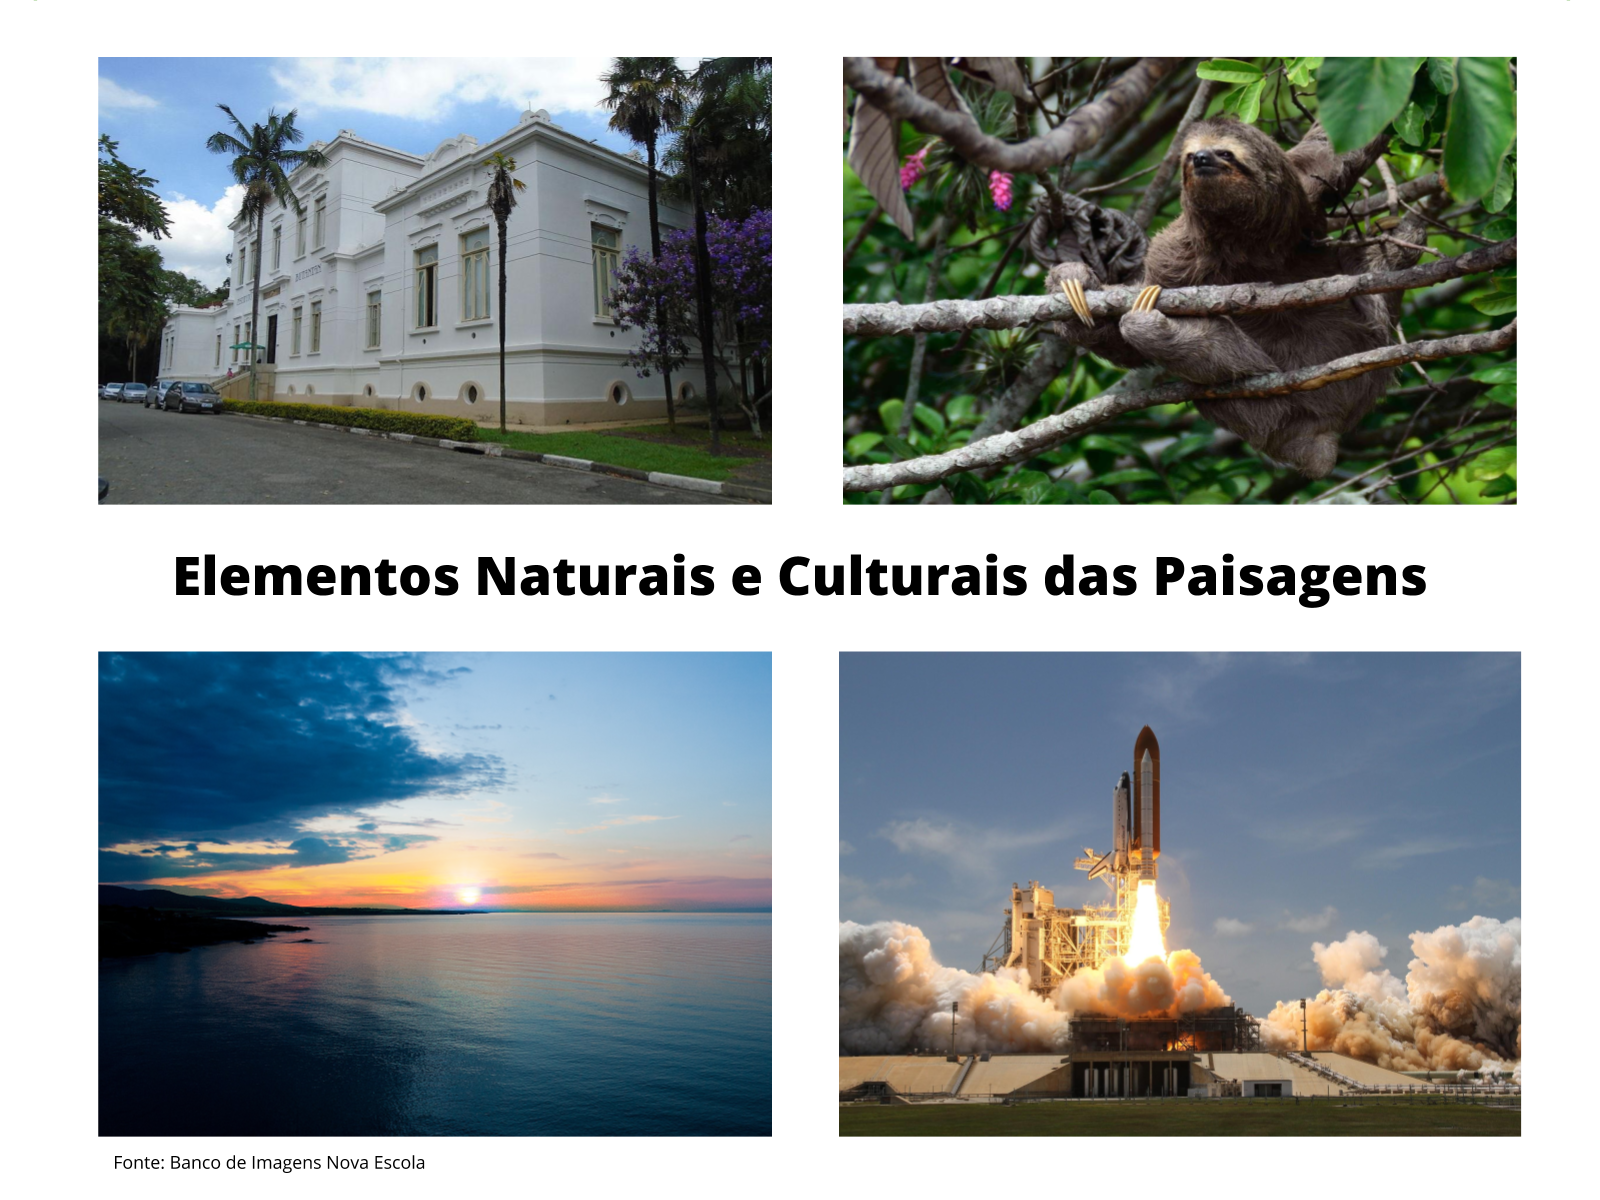
Elementos Da Paisagens

Como Classificar Elementos da Paisagem em Sensoriamento Remoto
A classificação de elementos da paisagem por imagem de satélite é mais frustrante do que a maioria dos tutoriais deixa entender. Você pega uma cena Landsat ou Sentinel-2 e acha que basta aplicar umNDVI e pronto. Na prática, o solo nu e as áreas construídas têm assinaturas espectrais quase idênticas no infravermelho próximo, e as sombras topográficas parecem vegetação densa para o classificador. Já perdi meio dia tentando entender por que minha acurácia caía para 61% em uma cena montanhosa do interior de Minas. O problema não era o classificador. Era a iluminação. Os principais elementos que compõem a cobertura da terra e que precisam ser separados são: corpos d'água, áreas construídas, solo exposto, agricultura, vegetação nativa, áreas de sombra e, em alguns casos, áreas alagadas sazonais. Cada um deles responde de forma diferente nas bandas espectrais disponíveis nos sensores ópticos. O segredo não é escolher o classificador mais complexo. É escolher as bandas certas e corrigir os problemas sistemáticos antes de treinar qualquer modelo. Comece sempre por uma correção atmosférica. Imagens brutas, mesmo as já processadas em nível 2A como as do Sentinel-2, ainda carregam ruído de aerossol e Variações de espessura óptica que distorcem os valores de reflectância. Se você pular esse passo, a diferença entre um campo de soja e uma área de capoeira pode desaparecer completamente porque ambos os alvos terão suas assinaturas deslocadas na mesma direção. Use o código DOCTOR ou o módulo Sen2Cor integrado ao SNAP, dependendo do sensor. O resultado custa cerca de 20 minutos de processamento e evita horas de retrabalho.
Preparação das bandas para classificação
As bandas mais úteis para separar os elementos da paisagem variam conforme o sensor, mas os princípios são os mesmos. Para Sentinel-2, as bandas B2 (azul), B3 (verde), B4 (vermelho), B8 (NIR) e B11 (SWIR) formam um conjunto básico sólido. A banda B8A também ajuda bastante em áreas de vegetação densa. A banda B1 (ultravioleta) geralmente adiciona pouco para classificação de uso do solo e só aumenta o tempo de processamento. Construa índices espectrais antes de rodar qualquer classificador supervisionado. O NDVI separa vegetação de solo nu com boa eficiência. O NDWI é útil para identificar corpos d'água. O NDBI ajuda a destacar áreas construídas. O SAVI corrige o efeito do solo em áreas com cobertura vegetal esparsa, algo que o NDVI puro não faz bem. Eu uso uma combinação de NDVI + NDBI + NDWI como camadas adicionais junto com as bandas originais. Isso dobra praticamente a informação disponível para o classificador sem custo computacional significativo. Um erro muito comum é aplicar esses índices diretamente nos valores de reflectância de superfície sem verificar a escala. Cada índice tem uma faixa de variação própria. NDVI vai de -1 a 1. NDBI também. NDWI também. Se você concatenar tudo numa única matriz e rodar um classificador, a maioria dos algoritmos vai tratar cada índice como tendo peso igual, o que não é verdade quando as distribuições são diferentes. Padronize ou normalize as camadas antes de treinar. Um simples MinMaxScaler ou StandardScaler do scikit-learn resolve isso em dois minutos.
Escolhendo amostras de treinamento
Amostras de treinamento bem distribuídas são o fator que mais impacta a acurácia final. Você precisa de exemplos representativos de cada classe em diferentes condições de iluminação, estação do ano e nível de degradação. Uma amostra de "vegetação nativa" coletada apenas em área preservada vai falhar miseravelmente quando o classificador encontrar uma mata secundária em regeneração. A mesma lógica se aplica a agricultura: soja no período de cultura é diferente de soja em cobertura de palha. No meu caso, a maior dor de cabeça foi com a classe "área construída". Telhados metálicos, concreto e asfalto têm respostas muito diferentes entre si. Um classificador treinado só com telhados de fibrocimento não reconhece telhados de aço galvanizado da mesma forma. A solução foi subdividir a classe em subcategorias dentro do próprio treinamento, usando exemplos variados de cada tipo de cobertura. Isso aumentou o volume de amostras necessárias, mas elevou a acurácia de 68% para 84% na validação cruzada. A regra prática que funciona é: pelo menos 30 amostras por classe por cena, distribuídas geograficamente de forma homogênea. Mais do que isso raramente traz ganho proporcional. Menos do que isso introduz viés sistemático. Use polígonos, não pontos isolados. Um ponto de 10 metros pode cair perfeitamente em uma borda de classe e gerar uma amostra enganosa. Um polígono de 30x30 metros captura a variabilidade interna da classe.
Classificadores e parâmetros práticos
Para quem está começando, o Random Forest é o classificador mais confiável. Ele lida bem com colinearidade entre variáveis, não requer normalização rigorosa das bandas e fornece scores de importância que ajudam a entender quais bandas ou índices estão realmente contribuindo. Configuração padrão que funciona na maioria dos casos: 200 árvores, max_depth sem limite, min_samples_split=2. O processamento de uma cena Sentinel-2 de 10m com 8 camadas e 5000 amostras leva cerca de 3 a 5 minutos em um processador moderno. O SVM com kernel RBF também é uma opção válida, mas exige mais ajuste de hiperparâmetros. O gamma e o C precisam ser calibrados, e uma escolha errada leva rapidamente a overfitting, especialmente quando o número de classes é alto. Eu recomendo SVM apenas se você tiver um dataset de treinamento muito grande e consistente, acima de 10 mil amostras. Para cenas menores, o Random Forest entrega resultado melhor com menos esforço. Existe ainda a possibilidade de usar aprendizado profundo com redes convolucionais, mas isso só faz sentido se você tiver acesso a um GPU e um banco de dados de amostras muito maior do que o scenario típico de um mapeamento municipal. Para a maioria dos trabalhos acadêmicos e técnicos, o Random Forest com as bandas e índices corretos é suficiente e muito mais rápido para colocar no ar.
Validação e medidas que realmente importam
Matriz de confusão é obrigatória. Acurácia geral sozinha esconde erros sistemáticos. Se sua classe "água" está sendo confundida com "sombra" em 40% dos casos, a acurácia geral pode ser 85% e mesmo assim seu mapa é inutilizável para qualquer aplicação prática. Verifique a precisão por classe individualmente e arecall. F1-score é a métrica mais honesta quando as classes são desbalanceadas, o que é a regra, não a exceção. Um problema recorrente que eu enfrentei foi a confusão entre vegetação de restinga e vegetação de transição para áreas úmidas. Ambas tinham NDVI alto e assinaturas similares no visível. A solução foi adicionar a banda B12 do Sentinel-2 (SWIR longo), que responde diferentemente ao conteúdo de água nos tecidos vegetais. Com essa banda extra, a separação melhorou drasticamente. Isso mostra que às vezes a resposta para um erro de classificação não está no classificador, mas sim nas bandas que você disponibilizou para ele.
Ferramentas e links úteis
Para executar o fluxo completo, o QGIS combinado com o plugin semi-automatic classification plugin (SCP) é a opção mais acessível. Ele integra correção atmosfétrica, extração de índices, classificação supervisionada e geração de matriz de confusão num único ambiente. Se preferir Python, o Google Earth Engine permite processar cenas inteiras de forma batch com código relativamente simples. Para análise local offline, rasterio, scikit-learn e geopandas formam um combo competente. Downloads: o SNAP da ESA para processamento de Sentinel-2 está disponível gratuitamente em portal de dados da ESA. O plugin SCP para QGIS pode ser instalado diretamente pelo gerenciador de plugins da versão 3.x. Amostras de referência para validação podem ser obtidas do LandCover_100m do JRC, que fornece classificação global de 10m com labels confiáveis para treinar e testar seus modelos.

Limitações e onde o método falha
A classificação baseada em pixel tem uma limitação fundamental: ela ignora a estrutura espacial. Um pixel de 10 metros pode conter mistura de duas ou mais classes, e o classificador será forçado a atribuir um rótulo único. Em áreas urbanas densas, onde telhados, ruas, jardins e veículos se alternam em escalas menores que o pixel, a classificação pixel-a-pixel simplesmente não funciona bem. Nesses casos, segmentação baseada em objetos ou classificação hierárquica dá resultados significativamente melhores. Outro ponto cego é a variação temporal. Uma mesma área pode ter assinatura espectrais completamente diferentes em épocas distintas. Agricultura plantada em outubro não parece agricultura plantada em março. Se o seu modelo foi treinado com imagens de uma única estação, ele vai generalizar mal para outras épocas. A solução é construir datasets de treinamento multitemporais, incluindo imagens de pelo menos duas estações secas e duas chuvosas. Isso aumenta o tempo de coleta de amostras, mas é indispensável para mapas anuais consistentes. Finalmente, sombras topográficas em regiões montanhosas permanecem um problema não resolvido de forma elegante. Nenhum classificador genérico consegue diferenciar consistentemente sombra de vegetação densa sem informações auxiliares de DEM. Se sua área de estudo tem relevo acidentado, inclua camadas de sombreamento derivadas do modelo digital de elevação como variáveis adicionais no classificador. Isso não elimina o erro, mas reduz a confusão entre as classes em cerca de 15 a 20 pontos percentuais na maioria dos cenários que eu testei.
Galeria
-
Elementos Naturais e Culturais das Paisagens - Planos de aula - 3º ano ... -

Paisagens Naturais E Culturais Atividades - ZULEDU -

Elementos de uma paisagem