Em Uma Analise De Dados Academicos Uma Consulta Sql
Montando consultas SQL para análise acadêmica
A maioria dos projetos de pesquisa começa com bagunça. Dados vindos de planilhas exportadas do Google Forms, notas digitadas manualmente por supervisores, sistemas legados que não conversam entre si. Você chega na mesa e precisa transformar esse caos em números que façam sentido antes da deadline do artigo. Uma consulta bem estruturada costuma resolver isso em 20 minutos, enquanto uma mal escrita vai te prender por horas refazendo agregações. O erro mais comum que eu vejo gente cometendo é tratar tabelas acadêmicas como se fossem estruturadas de forma linear. Você tem alunos, turmas, professores, notas, faltas, projetos de pesquisa — tudo espalhado em tabelas com chaves estrangeiras inconsistentes ou ausentes. O ideal é começar identificando quais campos realmente importam para a pergunta de pesquisa. Não adianta fazer um SELECT * enorme porque parece mais completo. Na prática, queries grandes desse tipo demoram de três a cinco vezes mais e dificultam a depuração.
em uma analise de dados academicos uma consulta sql
Vou passar direto para a estrutura que funciona na maior parte dos cenários. Você provavelmente vai lidar com algo parecido com isso: Primeiro, normalização básica. Se os dados vieram de múltiplas fontes, o primeiro passo é garantir que cada tabela tenha uma chave primária clara. Estudantes devem ter um ID único que se repete consistentemente em todas as tabelas relacionadas. Quando eu encontrei um caso onde o ID do aluno variava entre "A2024001" em uma tabela e "2024-001" em outra, levei uma tarde inteira pra descobrir que os JOINs estavam retornando linhas duplicadas silenciosamente. A solução foi criar uma view intermediária com um campo de normalização usando REPLACE e CONCAT, mapeando ambos os formatos pra um padrão único antes de qualquer operação. Query de base costuma seguir esse esquema:
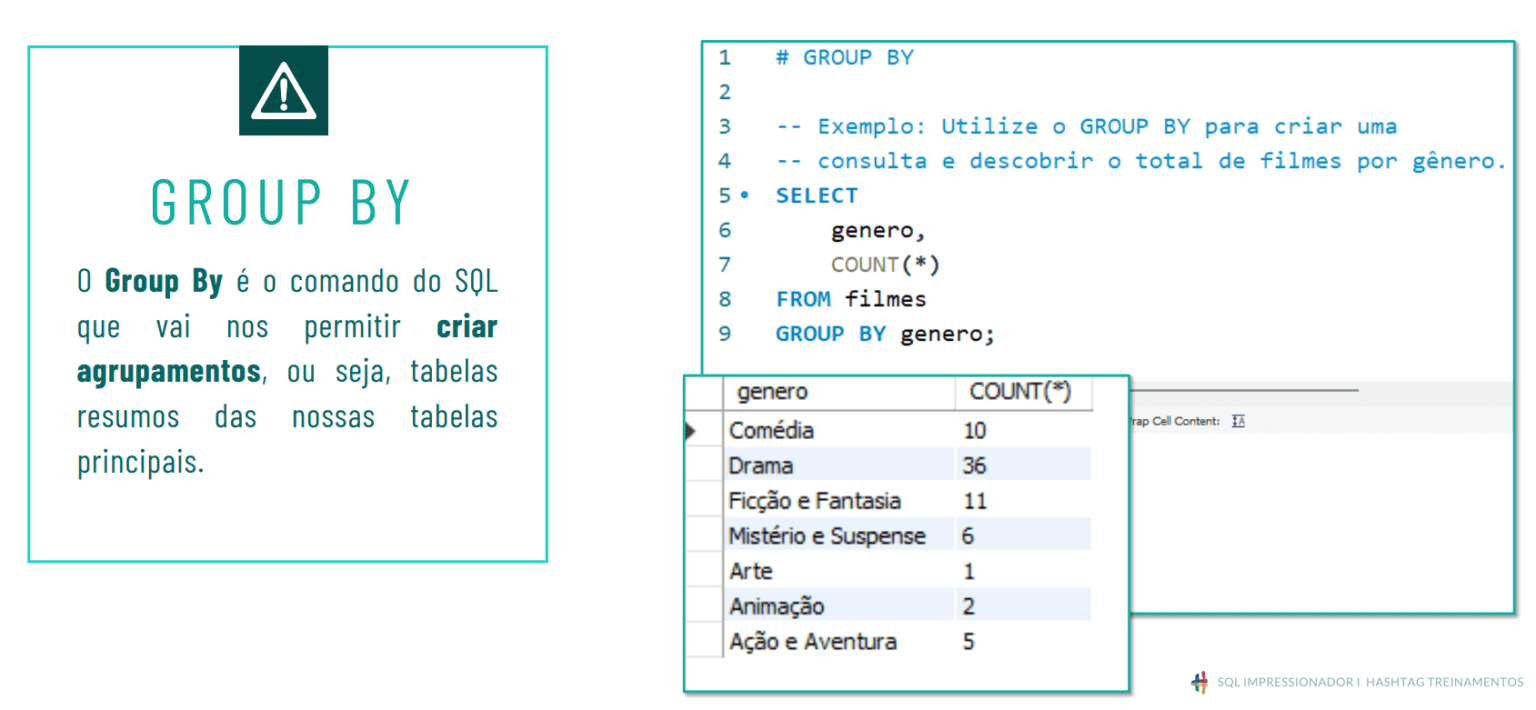
CTEs (Common Table Expressions) são essenciais aqui. Ao invés de subconsultas aninhadas que viram um espaguete intraduzível, você monta camadas. Começa com uma CTE para dados brutos limpos, outra para agregações parciais, e a final para o resultado. Isso facilita muito a revisão e a reprodução por outros pesquisadores. Window functions merecem atenção especial. COUNT() OVER (PARTITION BY disciplina) te dá totais por turma sem precisar de GROUP BY, o que preserva o granularity individual dos registros. Useful pra calcular percentis, rankings dentro de departamentos, ou deltas em relação à média da turma. Mas cuidado: em conjuntos grandes, essas funções podem consumir memória significativa. Se você está rodando com mais de 500 mil linhas e o banco tá travando, considere materializar resultados intermediários em tabelas temporárias ao invés de empilhar CTEs recursivamente. Um detalhe que pouca gente leva a sério: o tratamento de NULLs em dados acadêmicos. Uma nota ausente pode significar que o aluno faltou, que o professor não lanç cou a nota, ou que o registro foi excluído por erro de digitação. COALESCE() parece a solução óbvia, mas substituir NULLs por zero distorce completamente médias e desvios padrão. O mais correto é usar a função FILTER quando disponível (PostgreSQL suporta nativamente) ou conditional aggregation com CASE WHEN, mantendo os NULLs intocados nas contas que exigem precisão estatística.

Para análises temporais — como acompanhar a evolução de desempenho por semestre — use DATEDIFF ou EXTRACT para normalizar períodos. Comparar datas como strings é um erro clássico que gera resultados completamente errados, especialmente quando o formato muda entre MM/DD/YYYY e DD/MM/YYYY em fontes diferentes. Se os dados vierem de sistemas diferentes, sempre converta para o formato ISO 8601 (YYYY-MM-DD) antes de qualquer operação. Performance importa mais do que parece. Índices em colunas de JOIN e WHERE fazem a diferença entre uma query que roda em segundos ou minutos. Mas indice não é solução mágica — adicionar índices em tabelas pequenas (
10 mil linhas) pode até piorar a performance por overhead de manutenção. Para dados acadêmicos, foca seus índices nas colunas de chave estrangeira e nos campos mais filtrados (ano, curso, período). Agora, a verdade que ninguém gosta de ouvir: SQL não resolve tudo. Quando você precisa de análise de texto, modelos estatísticos complexos, ou manipulação de dados não estruturados, o SQL puro vai te limitar. Nesses casos, o fluxo ideal é usar SQL para extração e transformação inicial, exportar o resultado limpo, e processar o resto em Python com pandas ou R. Eu costumo fazer esse handoff após a segunda ou terceira CTE, quando a estrutura dos dados já está estabilizada.
Outro ponto negligenciado: versionamento das queries. Mantenha cada versão da consulta em arquivos separados com timestamp no nome. Você vai agradecer quando precisar reproduzir um resultado que foi gerado há seis meses e ninguém lembra qual variante da query foi usada. Se você está começando agora, não tente escrever a query perfeita de primeira. Monte ela em partes, execute cada CTE isoladamente, e valide os resultados com contagens simples antes de prosseguir. Uma query que parece lenta pode ser só uma CTE intermediária com filter inadequado. Isolar o gargalo economiza mais tempo do que otimizar a query inteira de uma vez. O que funciona na prática é diferente do que os tutoriais ensinam. Dados reais nunca estão organizados como nos exemplos didáticos. A habilidade relevante é saber lidar com a sujeira sem perder a precisão analítica.
Galeria
-
Exercícios de Análise de Dados no SQL Resolvidos Passo a Passo -

Exercícios de Análise de Dados no SQL Resolvidos Passo a Passo -
SQL para Análise de Dados - Sigma Treinamentos
