Embora Seja Um Conceito Fundamental Para A Biologia
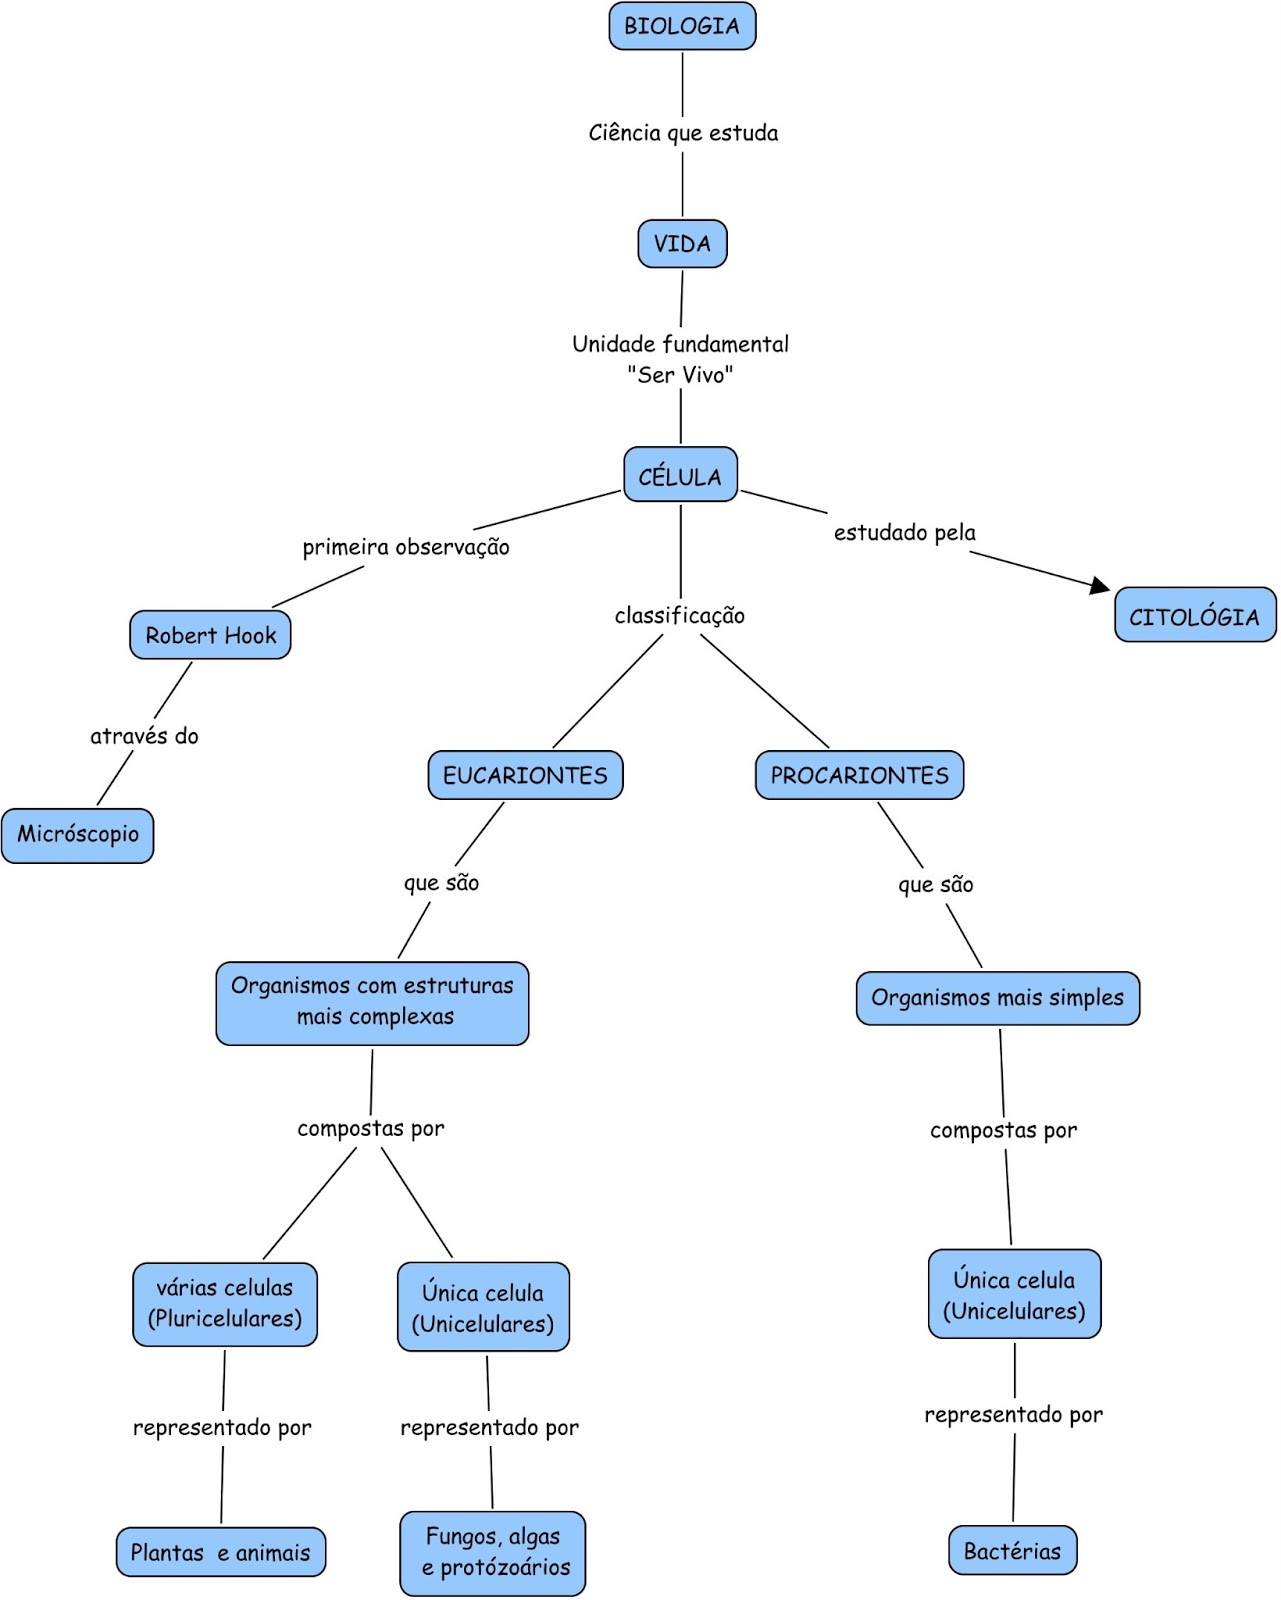
Análise filogenética molecular: o que acontece quando os dados não combinam
A construção de árvores filogenéticas parece simples na teoria. Você coleta sequências, alinha, escolhe um modelo de substituição e roda o programa. No entanto, o caminho entre o alinhamento bruto e uma árvore publicável costuma ser muito mais sujo do que qualquer manual académico admite. A maior parte dos erros não vem da metodologia em si, mas de decisões tomadas nos primeiros dez minutos que ninguém revisita depois. Antes de pensar em software ou em custo computacional, é preciso entender que embora seja um conceito fundamental para a biologia, a ideia de que genes têm histórias idênticas está simplesmente errada na maioria dos casos práticos. Genes se movem, se duplicam, se perdem, sofrem seleção diferenciada. Uma única árvore gênicas raramente reflete a história real do organismo. Isso não é um detalhe secundário. É o motivo principal pelo qual publicações inteiras precisam ser reinterpretadas anos depois.
Porque embora seja um conceito fundamental para a biologia, ele raramente se aplica de forma isolada
O erro mais frequente que eu vejo em revisão de artigos e em projetos iniciantes é a escolha cega do modelo de substituição nucleotídica ou aminoacidídica. Muitos pesquisadores rodando Maximum Likelihood usam o modelo padrão do programa sem testar alternativas. Isso geratopologias que parecem sólidas mas carregam viés sistemático, especialmente em dados com composições enviesadas ou taxas heterogêneas entre linhagens. O GTR+I+G é o modelo mais completo do RAxML e do IQ-TREE, mas completude não significa adequação. Em algumas minhas séries de dados filogenômicos com fungos, o LG+F+R5 mostrou suporte muito mais coerente com a literatura do que qualquer modelo nucleotídico complexo, simplesmente porque o alinhamento tinha saturação alta nos sítios sinônimos. Outro ponto que os tutoriais costumam pular é a questão do alinhamento. Um alinhamento ruim destrói qualquer método de inferência, não importa quão sofisticado seja o algoritmo. Ferramentas como MAFFT com ajustes de iterção e PRANK para regiões com inserções longas fazem diferença real. Eu costumo filtrar regiões mal alinhadas com trimAl usando o critério strict, e em muitos casos essa filtragem reduziu o tempo de análise de cerca de 4 horas para 45 minutos em clusters com restrições de memória, além de eliminar ramos atrativos artificiais que surgiam de homoplasia mascarada. A inferência em si merece atenção separada. Maximum Likelihood continua sendo o padrão-ouro para a maioria dos conjuntos de dados, mas o problema do tempo de execução não desaparece. Quando você trabalha com mais de duzentas sequências, o IQ-TREE com paralelização em múltiplos núcleos pode levar de meia hora a várias horas dependendo da profundidade do bootstrap aproximado. Bayesian inference com MrBayes ou PhyloBayes é ainda mais pesado. O trade-off é claro: métodos bayesianos dão distribuição posterior direta, mas a convergência das cadeias de Markov exige que você verifique o DPSF realmente abaixo de 0,01 antes de considerar os resultados válidos, e isso nem sempre acontece mesmo rodando por dias.
Existe um problema mais sutil que eu enfrentei recentemente com um conjunto de dados de protístas marinhos. O modelo de mistura de categorias de taxa resolvia parte do viés composicional, mas introduzia outro: os suportes de bootstrap para nós profundos caíram drasticamente quando comparados à análise com modelo fixo. A solução foi usar tanto a abordagem NJ+UFBoot quanto ML com teste de concordância topológica via SH-aLRT. Quando dois métodos independentes apontavam a mesma topologia com suporte alto, eu conseguia argumentar com muito mais segurança. Quando não concordavam, eu simplesmente não reportava aquele nó como confiável, mesmo que o programa mostrasse bootstrap de 95%. Isso evita a tentação de transformar incerteza em narrativa falsa. A validação final não deve ser tratada como passo opcional. Testes de concordância como o gene-tree contra species-tree, ou análises de coalescência com ASTRAL quando há duplicações gênicas, são essenciais para diferenciar ruído biológico de ruído analítico. Dados reais nunca se encaixam perfeitamente num único esquema, e reconhecer isso no manuscrito é mais honesto do que apresentar uma árvore única como se fosse a verdade consolidada. O trabalho vale a pena quando você entrega resultados que outros conseguem reproduzir exatamente, não quando você entrega a árvore mais bonita do pacote.
Galeria
-
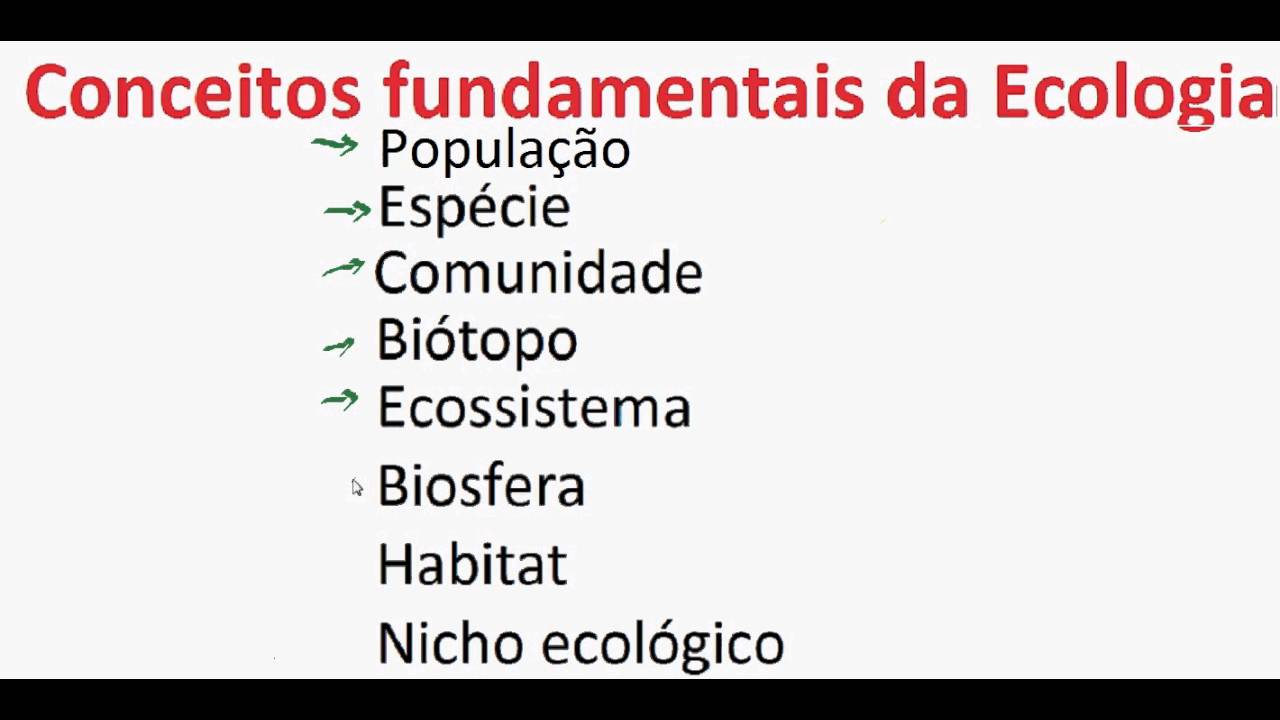
Embora Seja Um Conceito Fundamental Para A Biologia - RETOEDU -

Embora Seja Um Conceito Fundamental Para A Biologia - RETOEDU -
Conceito e importância da Biologia.pptx -
Conceitos Fundamentais de Biologia – Plataforma – Prof. Eriza
