Engenharia De Dados Ead

O que você precisa saber antes de começar com engenharia de dados
A maioria dos cursos de ensino a distância enche a cabeça do aluno com definições bonitas e diagrams coloridos em slides. A realidade é bem diferente. Quando você vai colocar a mão na massa, descobre que o pipeline que funcionou no exercício do curso quebra com cinco linhas de dados extras e uma conexão de rede instável. Isso é normal. Todo mundo passa por isso. Eu comecei meu caminho nessa área assistindo aulas gravadas e tentando replicar os exemplos em casa. O problema era simples na teoria e complicado na execução. Os exercícios usavam datasets limpos de 50 MB. O mundo real te joga arquivos de 2 GB corrompidos pelo meio, com colunas que mudam de nome todo dia e encoding que não faz sentido. Um caso específico que marca muito: eu estava construindo um pipeline de ingestão para um sistema de logs e descobri que os arquivos vinham compactados em formato que misturava GZIP com texto puro de forma inconsistente. Alguns dias era tudo GZIP, outros dias tinha arquivo solto dentro do mesmo diretório. O código que funcionava na segunda-feira quebrava na quarta-feira sem aviso. A solução foi adicionar uma função de detectão automática que verificava o magic number do arquivo e tratava cada caso separadamente. Isso economizava cerca de 4 horas de debugging todo final de semana.
As ferramentas que realmente importam
Existem dezenas de opções no mercado e a tentação é tentar aprender todas. A verdade é que você não precisa de tudo. Um bom engenheiro de dados usa poucas ferramentas, mas usa bem. As mais comuns são Python com Pandas para prototipagem rápida, SQL para manipulação estruturada, e alguma ferramenta de orquestração como Airflow ou Prefect para agendar e monitorar pipelines. O que pouca gente explica nos cursos é que a parte mais importante do trabalho não é escrever código complexo. É fazer código que sobreviva quando você sair de férias. Pipeline que depende de variáveis de ambiente configuradas manualmente no servidor da empresa é um pedido de demissão disfarçado. Documentação mínima, comentários claros no código, e tratamento de erro em todos os pontos de falha conhecidos. Isso transforma um projeto que leva 15 minutos para debugar em um pesadelo de 3 horas para outra pessoa entender.
Pitfalls comuns que ninguém avisa
O primeiro grande erro é subestimar a limpeza de dados. Nos exercícios do curso, os dados sempre vêm prontos. Na vida real, você recebe planilhas com datas no formato americano misturado com datas no formato brasileiro, valores numéricos escritos como texto, e linhas inteiras duplicadas que só aparecem em certo período do mês. Gastar 20% do tempo entendendo a estrutura real dos dados evita semanas de retrabalho depois. Outro problema sério é a falta de testes. Eu vi engenheiro júnior construir um pipeline inteiro sem nenhum teste unitário. Quando a fonte de dados mudou o schema overnight, o pipeline processou 48 horas de dados errados antes de alguém perceber. Testes de integração simples, que verificam se o número de linhas saiu igual ao esperado e se as colunas existem, economizam muito tempo. Isso geralmente leva menos de uma hora para implementar e protege contra erros que custariam dias para corrigir.

Como lidar com problemas reais
Quando algo quebra, a primeira reação é entrar em pânico e começar a modificar tudo ao mesmo tempo. Isso nunca funciona. Anote o que mudou, isole o problema em etapas menores, e teste cada mudança individualmente. Eu tenho um hábito ruim de tentar resolver tudo de uma vez e depois fico duas horas rastreando qual das dez modificações quebrei algo que estava funcionando. Uma técnica que me salvou várias vezes é manter logs detalhados desde o primeiro momento. Não logs genéricos de "erro na linha 50", mas informações específicas sobre o estado do dado naquele ponto: tamanho do batch, schema detectado, número de linhas processadas, tempo de execução. Quando o problema aparece, esses logs são a única coisa que permite reconstruir a cadeia de eventos em minutos em vez de horas. Outro aspecto importante é entender os limites das ferramentas. Python com Pandas funciona bem para datasets que cabem na memória. Quando o volume cresce, você precisa migra para Spark ou DuckDB. Airflow é poderoso mas tem curva de aprendizado íngreme para equipes pequenas. Prefect ou Dagster oferecem flexibilidade maior com menos configuração inicial. Escolher a ferramenta errada para o tamanho do problema pode duplicar o tempo de desenvolvimento ou criar gargalos difíceis de diagnosticar depois.
Galeria
-
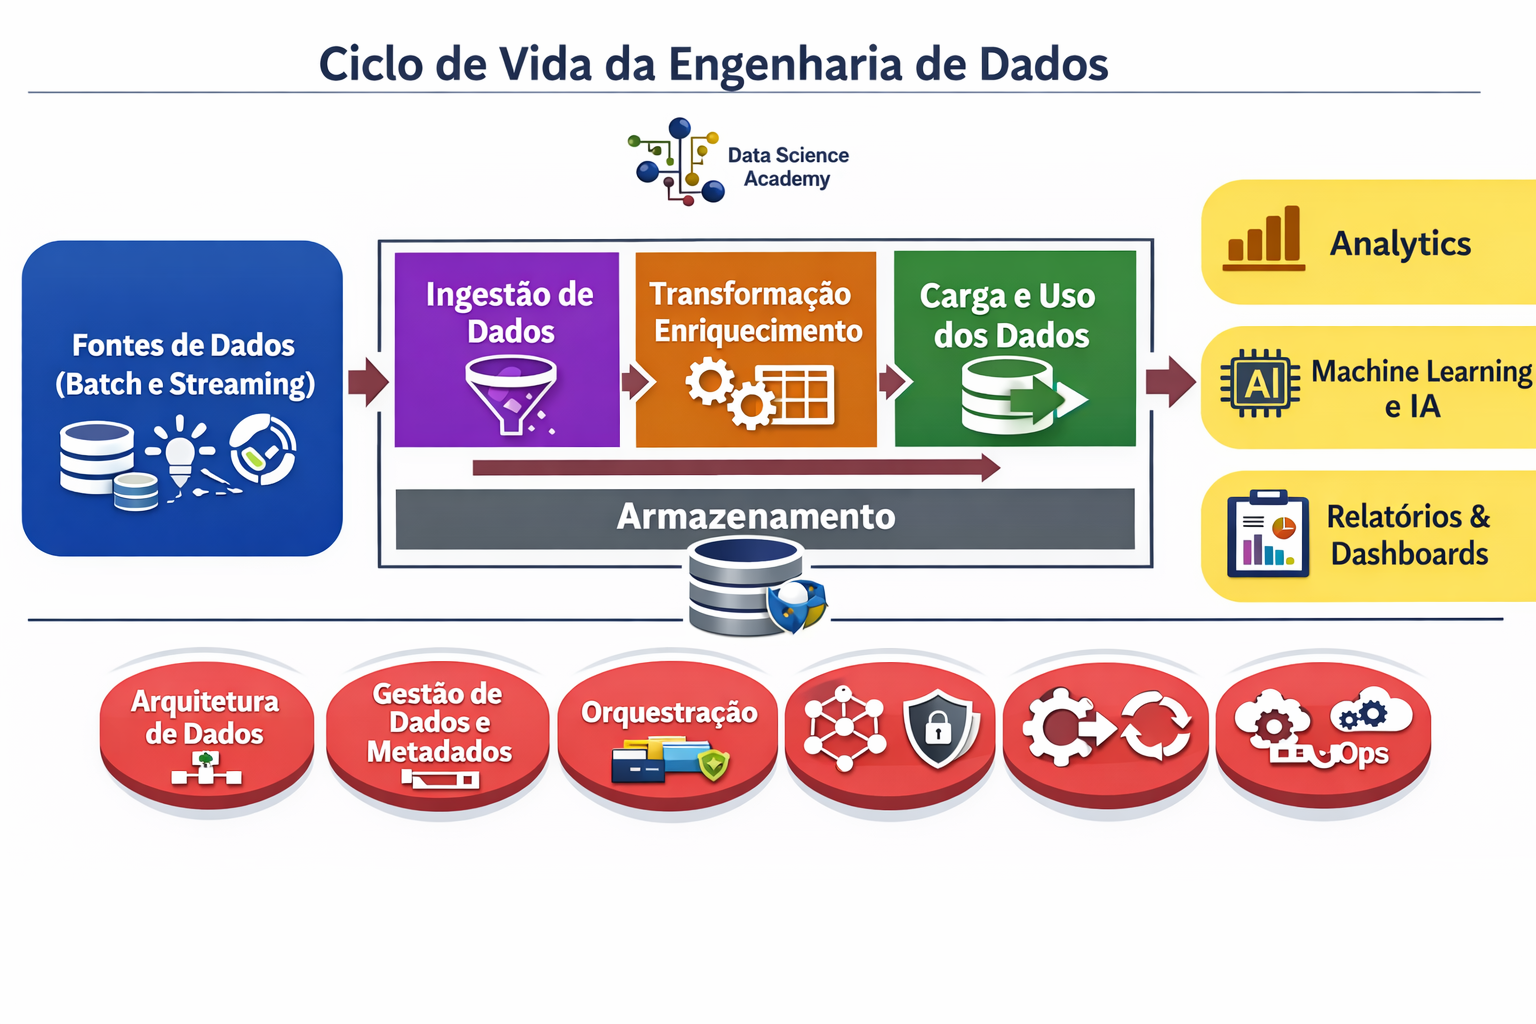
Ciclo de vida da Engenharia de Dados | Professor Rogerão Araújo -
Graduação em Banco de Dados - EAD | Faculdade Impacta -
Desvendando a Engenharia de Dados: Fundamentos e Aplicações -
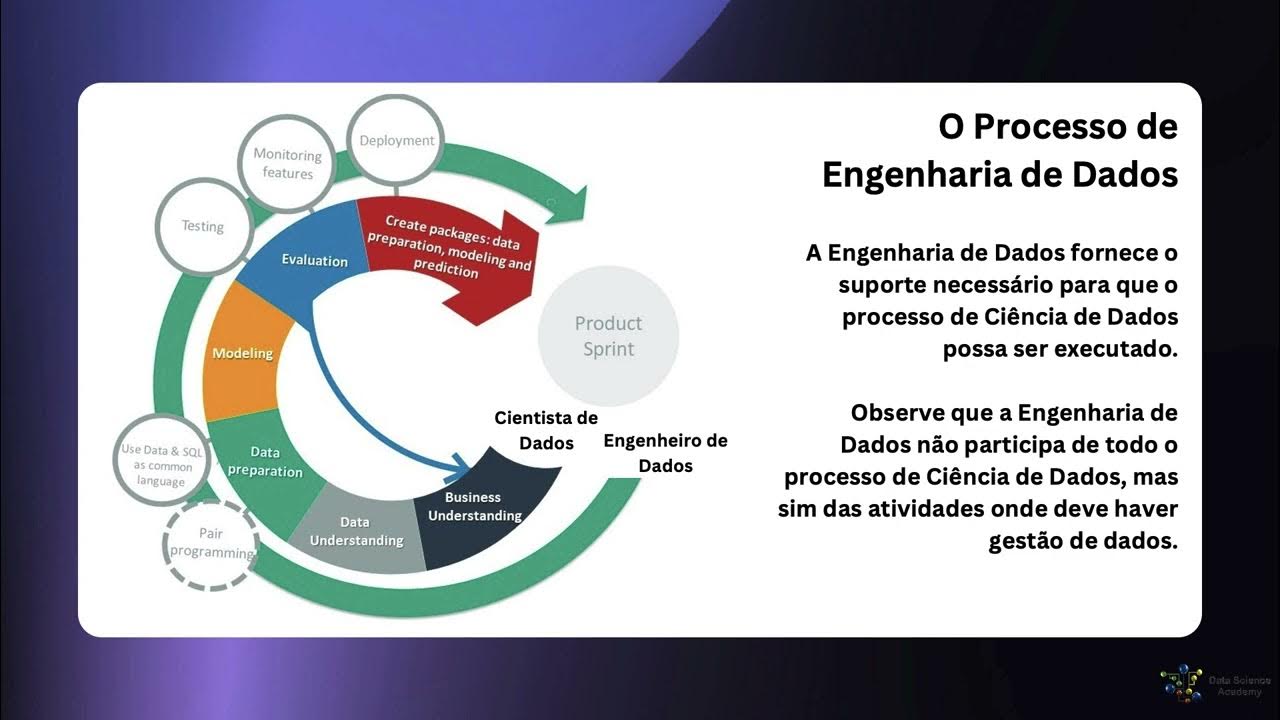
O Processo de Engenharia de Dados - Data Science Framework - YouTube

