Entropia Informacion

Entropia da informação: o que realmente significa na prática
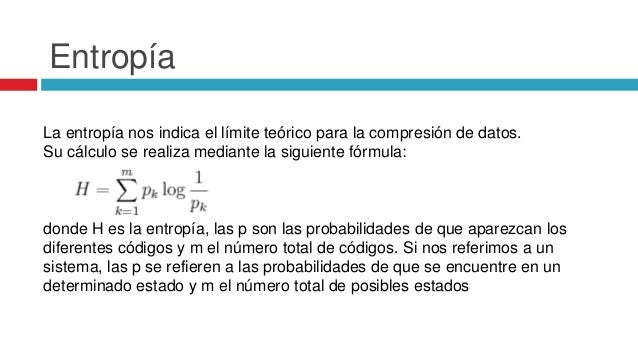
A entropia informacional é uma medida da incerteza ou irregularidade nos dados. Desenvolvida por Claude Shannon em 1948, ela quantifica quão imprevisível é o conteúdo de um conjunto de informação. Quanto mais homogêeno for o conjunto, menor a entropia. Quanto mais uniforme ou caótico, maior. A fórmula básica é H = - p(x) · log(p(x)), onde p(x) é a probabilidade de cada símbolo ou evento ocorrer. O resultado é expresso em bits. Um arquivo com apenas zeros tem entropia zero, enquanto um arquivo verdadeiramente aleatório tende ao máximo teórico de entropia para seu alfabeto.
Como calcular entropia informacion em um conjunto real
Pegue uma string qualquer, conte a frequência de cada caractere, calcule a probabilidade de cada um e aplique a fórmula. Vamos usar um exemplo simples: "banana". Os caracteres são a(3), b(1), n(2), total 6 ocorrências. As probabilidades são 0.5, 0.167, 0.333. Aplicando: -[0.5·log(0.5) + 0.167·log(0.167) + 0.333·log(0.333)] 1.459 bits. O valor máximo para 3 símbolos seria log(3) 1.585 bits, então "banana" está perto do máximo, mas não é perfeitamente uniforme. Um texto como "abcdef" teria entropia mais alta ainda, porque cada símbolo aparece com frequência idêntica. Na prática, você raramente calcula isso manualmente. Linguagens como Python oferecem bibliotecas como numpy e scipy para esse cálculo, ou você pode usar a função sklearn.feature_selection.mutual_info_classif para entropia condicionada em classificação.
Aplicações no dia a dia
A entropia informacion aparece em compressão de dados, onde arquivos de alta entropia não compressíveis indicam que a informação já está na forma mais compacta possível. Em criptografia, um bom gerador de números aleatórios produz saída com entropia próxima do máximo. Em machine learning, é usada para calcular ganho de informação em árvores de decisão — o ID3 e o C4.5 dependem diretamente desse conceito para decidir onde dividir os dados. Outra aplicação comum é a detecção de anomalias. Sequências com entropia drasticamente diferente do padrão podem indicar malware, intrusion ou dados corrompidos. Ferramentas como o Entropy Analyzer do Wireshark fazem exatamente isso, comparando a entropia de pacotes de rede em tempo real.
Um problema real que eu tive com entropia informacion
Estava construindo um modelo de detecção de fraude com milhares de variáveis, e decidi usar entropia como filtro inicial para selecionar features. A lógica parecia sólida: features de alta entropia teriam mais informação discriminativa. O problema é que features com entropia altíssima podiam ser simplesmente ruído aleatório — uma coluna de timestamps com nanosegundos variados, por exemplo. Ela tinha entropia máxima, mas zero valor preditivo real. O workaround que encontrei foi combinar a entropia com a proporção de valores únicos e com o ganho de informação relativo à variável alvo. Assim, filters que tinham alta entropia mas também alta cardinalidade sem correlação com o target eram descartados. O processo inteiro, que antes levava cerca de 40 minutos rodando em paralelo com 16 threads, caiu para uns 8 minutos com esse filtro duplo. A precisão do modelo também melhorou ligeiramente porque menos features irrelevantes entravam no treinamento.
Pegadinhas que ninguém conta
Primeiro: a entropia assume que os símbolos são independentes. Em textos naturais, há dependência entre caracteres adjacentes — o "q" quase sempre é seguido de "u". Isso significa que a entropia de primeira ordem (shannon entropy simples) superestima a quantidade real de informação em dados estruturados como linguagem natural. A entropia condicional ou a entropia de ordem superior corrige isso, mas exigem mais dados e computação. Segundo: a entropia é sensível ao tamanho da amostra. Com poucos exemplos, as probabilidades estimadas são enviesadas, e a entropia calculada tende a ser subestimada. Para correção, existem estimadores como o de Jackknife ou o de Miller-Madow, que adicionam um termo de correção baseado no número de categorias observadas e no total de amostras. Terceiro: não confunda alta entropia com alta utilidade. Um dataset totalmente aleatório tem entropia máxima, mas é inútil para prever qualquer coisa. O que você geralmente quer é entropia alta na variável alvo combinada com baixa entropia condicional nas features — ou seja, incerteza no que você quer prever, mas redução dessa incerteza quando você observa os dados de entrada.
Quando a entropia informacion não resolve
Se seus dados são predominantemente contínuos e têm distribuições muito concentradas (como a maioria dos dados financeiros reais, onde 80% das observações ficam em um intervalo estreito), a entropia pode não ser a métrica mais indicada. Nesse cenário, testar a entropia de Renyi de ordem superior ou usar divergência de Kullback-Leibler para comparar distribuições pode ser mais informativo. Se você está lidando com dados sequenciais complexos — como séries temporais financeiras ou textos longos — a entropia de Shannon pura captura pouca estrutura. Nesse caso, considere entropia aproximada (apEn) ou entropia amostral (sEnt), que levam em conta a similaridade entre vetores consecutivos, não apenas a frequência marginal dos símbolos. Para implementação prática, o código mais direto em Python usa numpy para calcular histogramas e math.log2 para o logaritmo. Uma função simples leva menos de 10 linhas. Se precisar de algo mais robusto com correções de viés, o pacote entropypy já implementa Miller-Madow e Jackknife, mas exige instalação separada. Para a maioria dos casos de uso rotineiro, a implementação própria com numpy é suficiente e mais transparente.

O custo computacional varia conforme o tamanho do vocabulário. Para strings curtas com alfabeto pequeno, o cálculo é praticamente instantâneo. Para datasets com milhares de features e milhões de linhas, o gargalo costuma ser a estimação das probabilidades, não o logaritmo em si. Parallelizar o cálculo por feature usando joblib ou multiprocessing reduz o tempo de forma previsível, mas a Lei de Amdahl aplica-se — a parte sequencial do código limita o speedup máximo em cerca de 60-70% em hardware comum.
Galeria
-

Fórmula De Teoría De La Información. Entropía Shannon. Ilustración del ... -
Entropia Comunicaciones | PDF | Entropía | Información -
De Sistemas a Entropía: El Flujo de Información al Estilo Shannon - YouTube

