Enviando Dados Para Spool

Como funciona o envio de dados para spool na prática
O spool é basicamente a fila de impressão e processamento do SAP. Quando você gera um relatório, uma lista ou um job em lote, tudo passa por lá antes de chegar ao destino final. A maioria das pessoas vê o spool apenas como algo que aparece no SM37 ou no SP01, mas o funcionamento real é mais complexo do que parece. Quando uma transação ou um relatório emite output, o sistema cria um request de spool com um identificador único. Esse request carrega os dados brutos, as configurações de formatação e o parâmetro de destino. Se o relatório for gerado via ABAP, você pode controlar isso diretamente pelo comando WRITE ou CALL FUNCTION que direciona a saída para a fila. É simples até você perceber que existem várias colunas no request que definem onde e como aquele dado será processado. O parâmetro SPOOL_DEST define o dispositivo de saída. O SPOOL_LINENO controla a quantidade de linhas. E o SPOOL_PAGESIZE determina o tamanho da página. Essas variáveis parecem óbvias, mas a maior parte dos desenvolvimentos que eu já vi ignora completamente a configuração delas e confia no padrão do sistema. Isso gera problema depois.
Passo a passo para enviar dados para spool via ABAP
Se você precisa criar um request de spool programaticamente, o caminho mais direto é usar a função RSPO_RETURN_SPOOLJOB para consultar dados já existentes ou construir o request do zero com RSTS_ALLOCATE. A função RSTS_ALLOCATE é antiga, mas ainda é a base de tudo. Ela recebe o nome do programa, o layout, o dispositivo de saída e vários parâmetros opcionais que definem o comportamento. Veja um exemplo prático: CALL FUNCTION 'RSTS_ALLOCATE'
EXPORTING
ACTIVITY = 'A'
DEVICE = 'PRINTER'
LAYOUT = 'X_65_255'
NO_DIALOG = 'X'
TITLELINE = 'Meu Relatório'
IMPORTING
SPOOLLID = lw_spoolid
EXCEPTIONS
CANT_ALLOCATE = 1
OTHERS = 2.
Depois que o request é criado, você popula com WRITE statements ou envia dados via dataset. O sistema vai acumulando tudo no buffer de spool até que o job seja finalizado. Quando você fecha a lista com ULINE ou encerra o processamento, o request fica disponível no SP01 para visualização, impressão ou download.

Pegadinhas que ninguém conta
Aqui está algo que eu aprendi na prática e que raramente aparece em documentação. O spool não é um sistema de arquivo. Ele é um banco de dados específico dentro do SAP, tabelas como TSP01 e TSP02 guardam os registros. Isso significa que operações de DELETE ou atualização direta nessas tabelas podem corromper a fila inteira se você não tiver cuidado. Eu já vi um desenvolvedor tentar limpar requests antigos com um DELETE direto e o sistema parar de gerar spools novos por horas até o basis identificar o problema. Outro ponto importante: o spool tem tempo de retenção configurável. Se o seu job configura um retention period curto, os dados somem mais rápido do que você espera. Configure isso com SPOPLIFETIME no momento da alocação. O padrão costuma ser 30 dias, mas em ambientes com carga alta isso pode ser reduzido para poucos dias pelo basis. Limitações reais: Spool não escala bem para volumes grandes. Se você precisa enviar milhões de linhas, o request de spool vai travar ou levar tempo demais. Nesses casos, o ideal é usar exportação direta para arquivo (GUI_DOWNLOAD, SAP Gateway, ou mesmo HTTP call) e deixar o spool apenas para relatórios de tamanho razoável. O spool também não suporta formatação avançada como PDF nativo sem funções adicionais — você precisa de conversão explícita com CONVERT_ABAPSPOOLJOB_2_PDF se precisar disso.
Alternativas quando o spool não é a melhor opção
Se o seu cenário envolve transmissão de dados para sistemas externos, integração com parceiros ou geração de arquivos em larga escala, considere usar SAP Connector (RFC), IDoc, ou APIs REST via SAP Gateway. O spool foi projetado para impressão e listagem interna, não para movimentação de dados entre sistemas. Usá-lo para outra coisa é como usar um martelo para abrir uma garrafa — funciona, mas não é o jeito certo. Para envio de dados massivos entre sistemas, o padrão do mercado é IDoc com ALE/EDI ou então SOAP/REST via SICF. São opções mais trabalhosas de implementar, mas evitam os gargalos clássicos do spool e dão muito mais controle sobre o que acontece com os dados depois de enviados.
Resumo rápido do que fazer
Crie o request com RSTS_ALLOCATE. Popule com os dados corretos. Verifique o spool no SP01. Não mexa nas tabelas TSP01/TSP02 diretamente. Use retenção adequada. E se o volume for grande, pense em outra abordagem antes de insistir no spool.

Galeria
-

ABAP Junior: Mandando Spool para Emails -
RH - Linha Datasul - MFP - Diretório spool para geração de arquivos ... -
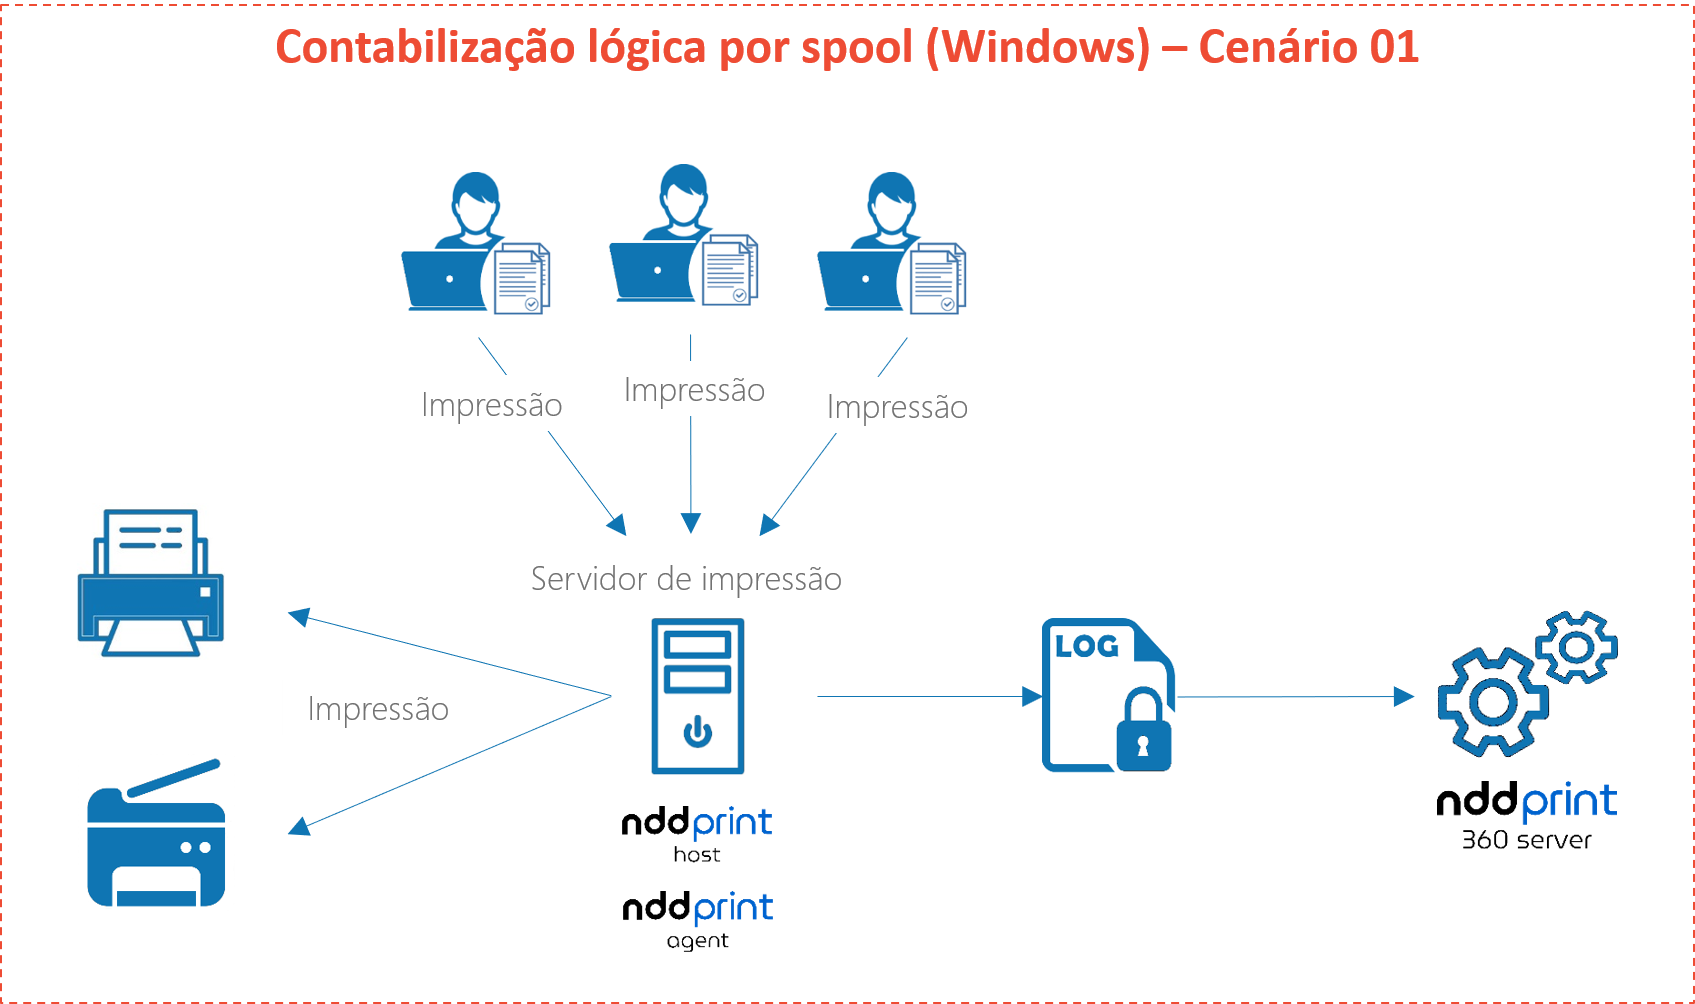
Contabilização lógica por spool e/ou CUPS | Help Center | NDD Print
