Erro Padrao Da Media

O que é e como calcular na prática
O erro padrão da média é uma medida de dispersão que quantifica o quão precisa é a média amostral como estimativa da média populacional. A fórmula é simples: pega o desvio padrão da amostra, divide pela raiz quadrada do tamanho da amostra. EM = DP / n. Pronto. O resto da confusão acontece depois. Eu já vi gente confundir isso com desvio padrão e gastar horas corrigindo resultado de pesquisa porque achava que a análise estava errada quando, na verdade, só tinha interpretado o número errado. O desvio padrão te diz quão espalhados são os dados. O erro padrão te diz o quão confiável é a média que você calculou. São coisas diferentes que parecem iguais porque usam a mesma notação na cabeça de quem tá apressado.
Erros comuns ao calcular o erro padrao da media
O erro mais frequente que eu encontro é alguém pegar um dataset grande, calcular a média e o desvio padrão, mas esquecer de dividir pelo raiz de n. O resultado sai maior do que deveria e a pessoa acha que os dados são muito heterogêneos, quando na verdade o problema era só o cálculo. Outro erro comum é usar o desvio padrão populacional quando se tem apenas a amostra. Se você usa em vez de s, o erro padrão fica subestimado, e aí seus intervalos de confiança ficam apertados demais, dando uma falsa sensação de precisão. Uma vez, num projeto de pesquisa clínica, a equipe tinha uma amostra de 47 participantes. O software que eles usavam já vinha com o cálculo pronto, mas a planilha que montaram por fora puxava o erro padrão dividindo pelo n em vez de n. Isso inflou o erro padrão em cerca de 47 6,86 vezes. O intervalo de confiança ficou tão largo que a conclusão foi "não há diferença significativa", quando na verdade, com o cálculo correto, o efeito era claramente relevante. Levei dois dias inteiros pra rastrear isso, só pra descobrir que a fonte do erro era uma célula da planilha com uma fórmula errada há três semanas.
Quando o erro padrão é útil e quando não é
O erro padrão da média funciona bem quando a amostra é aleatória e representativa, e quando a população de origem não tem uma distribuição extremamente enviesada. Para amostras acima de 30, o Teorema Central do Limite já faz seu trabalho e o erro padrão tende a ser confiável. Abaixo disso, a coisa começa a ficar instável, especialmente se os dados não forem aproximadamente normais. Um ponto que poucos destacam: o erro padrão diminui conforme a amostra cresce, mas não linearmente. Para reduzir o erro padrão pela metade, você precisa quadruplicar o tamanho da amostra. Isso significa que sair coletando dados até o número que você quer é um jogo caro e lento. Em muitos casos, é mais eficiente melhorar o desenho do estudo do que simplesmente aumentar n. Outro problema prático: o erro padrão assume independência entre as observações. Se você tem dados agrupados — alunos em turmas, pacientes em hospitais, respostas repetidas no mesmo indivíduo —, o erro padrão convencional vai subestimar a variabilidade real. Nesses casos, o correto é usar modelos multinível ou calcular erros padrão robustos agrupados por cluster. Eu já vi relatórios sendo rejeitados em revistas porque o erro padrão não levou em conta a estrutura de clustered data, e o revisor mandou refazer a análise com erros padrão clusterizados. A diferença foi significativa, às vezes dobrando o erro padrão.

Como calcular passo a passo
Se você quer fazer manualmente, o processo é direto. Primeiro, calcule a média dos seus dados. Depois, calcule o desvio padrão da amostra usando a fórmula com n-1 no denominador. Some os quadrados das diferenças entre cada observação e a média, divida por n-1 e tire a raiz quadrada. Por fim, divida esse desvio padrão pela raiz quadrada de n. Se sua amostra tem 100 observações e o desvio padrão é 12, o erro padrão será 12 / 100 = 1,2. Se estiver usando Excel ou Google Sheets, a função é ERRP.AD (para desvio padrão populacional) ou ERRP.PARA (para desvio padrão amostral). No R, use a fórmula diretamente: sd(x) / sqrt(length(x)). No Python, com pandas e numpy, é x.std(ddof=1) / np.sqrt(len(x)). Cada linguagem tem sua particularidade, então preste atenção ao grau de liberdade.
Limitações que todo mundo ignora
O erro padrão da média não te diz nada sobre a variabilidade individual dos dados. Pode ter uma média perfeitamente estimada com erro padrão baixo, mas os dados podem estar tão dispersos que a média em si não representa ninguém. Isso acontece bastante em distribuições bimodais, onde a média fica no vale entre dois picos e o erro padrão é pequeno só porque a amostra é grande, não porque o fenômeno seja homogêneo. Também é importante saber que o erro padrão não é uma medida de viés. Um estimador pode ter erro padrão baixíssimo e ser sistematicamente enviesado. Ou seja, você vai estar muito certo de estar errado. Se seu método de coleta tem viés de seleção, reduzir o erro padrão com mais dados só vai consolidar o erro, não eliminá-lo. Para distribuições com caudas muito pesadas ou outliers extremos, o erro padrão convencional perde a utilidade. Nesses casos, um intervalo de confiança bootstrap ou o uso de métodos robustos como o winsorized standard error costuma ser mais adequado. Eu recomendo isso sempre que o coeficiente de assimetria (skewness) for maior que 2, o que indica uma distribuição longe da normalidade.
Erros comuns ao interpretar resultados com erro padrao da media
A interpretação mais errada que eu vejo é tratar o erro padrão como se fosse um intervalo de confiança. O erro padrão é apenas o desvio padrão da distribuição amostral da média. Para construir um intervalo de confiança de 95%, você multiplica o erro padrão por aproximadamente 1,96 (para amostras grandes). Um intervalo de confiança de 95% não significa que 95% dos dados estão contidos ali. Significa que, se você repetisse o estudo infinitas vezes, 95% dos intervalos construídos conteriam a verdadeira média populacional. A nuance é importante porque afeta diretamente como você comunica resultados. Outro erro grave é comparar erro padrão de grupos com tamanhos amostrais diferentes sem normalizar. Um grupo com n=500 vai ter erro padrão menor que um grupo com n=50 mesmo que a variabilidade relativa seja idêntica. Comparar os números crus aí é armadilha. Se você está escrevendo um relatório ou artigo, o recomendável é reportar sempre a média, o desvio padrão, o tamanho da amostra e o erro padrão. Assim, quem ler tem todas as informações para fazer suas próprias contas se precisar. Depender só do erro padrão apresentado é pedir para cometer erro de interpretação.

Galeria
-

Desvio Padrão versus Erro Padrão - Blog da Prof. Fernanda Maciel -
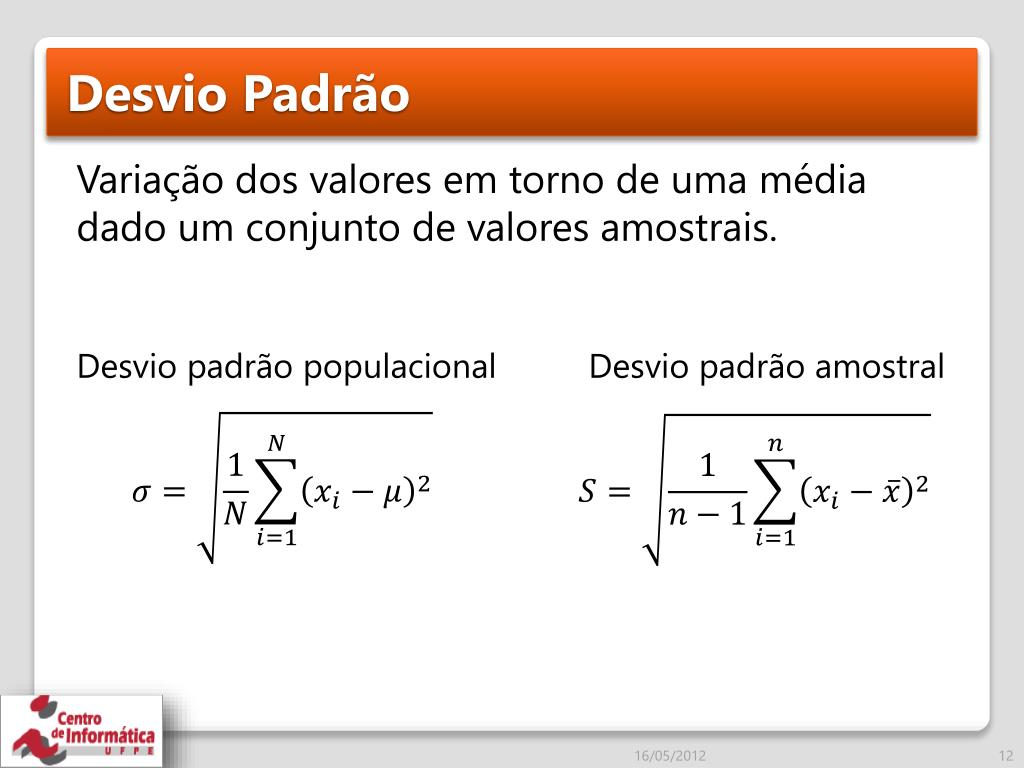
Desvio Padrão Da Média | Desvio-padrão: o que é e como calcular – VHKTX -

Desvio Padrão versus Erro Padrão - Blog da Prof. Fernanda Maciel
