Estatistica Amostra E População

O problema que ninguém te conta sobre amostragem
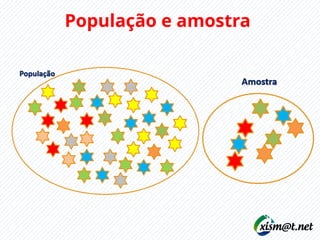
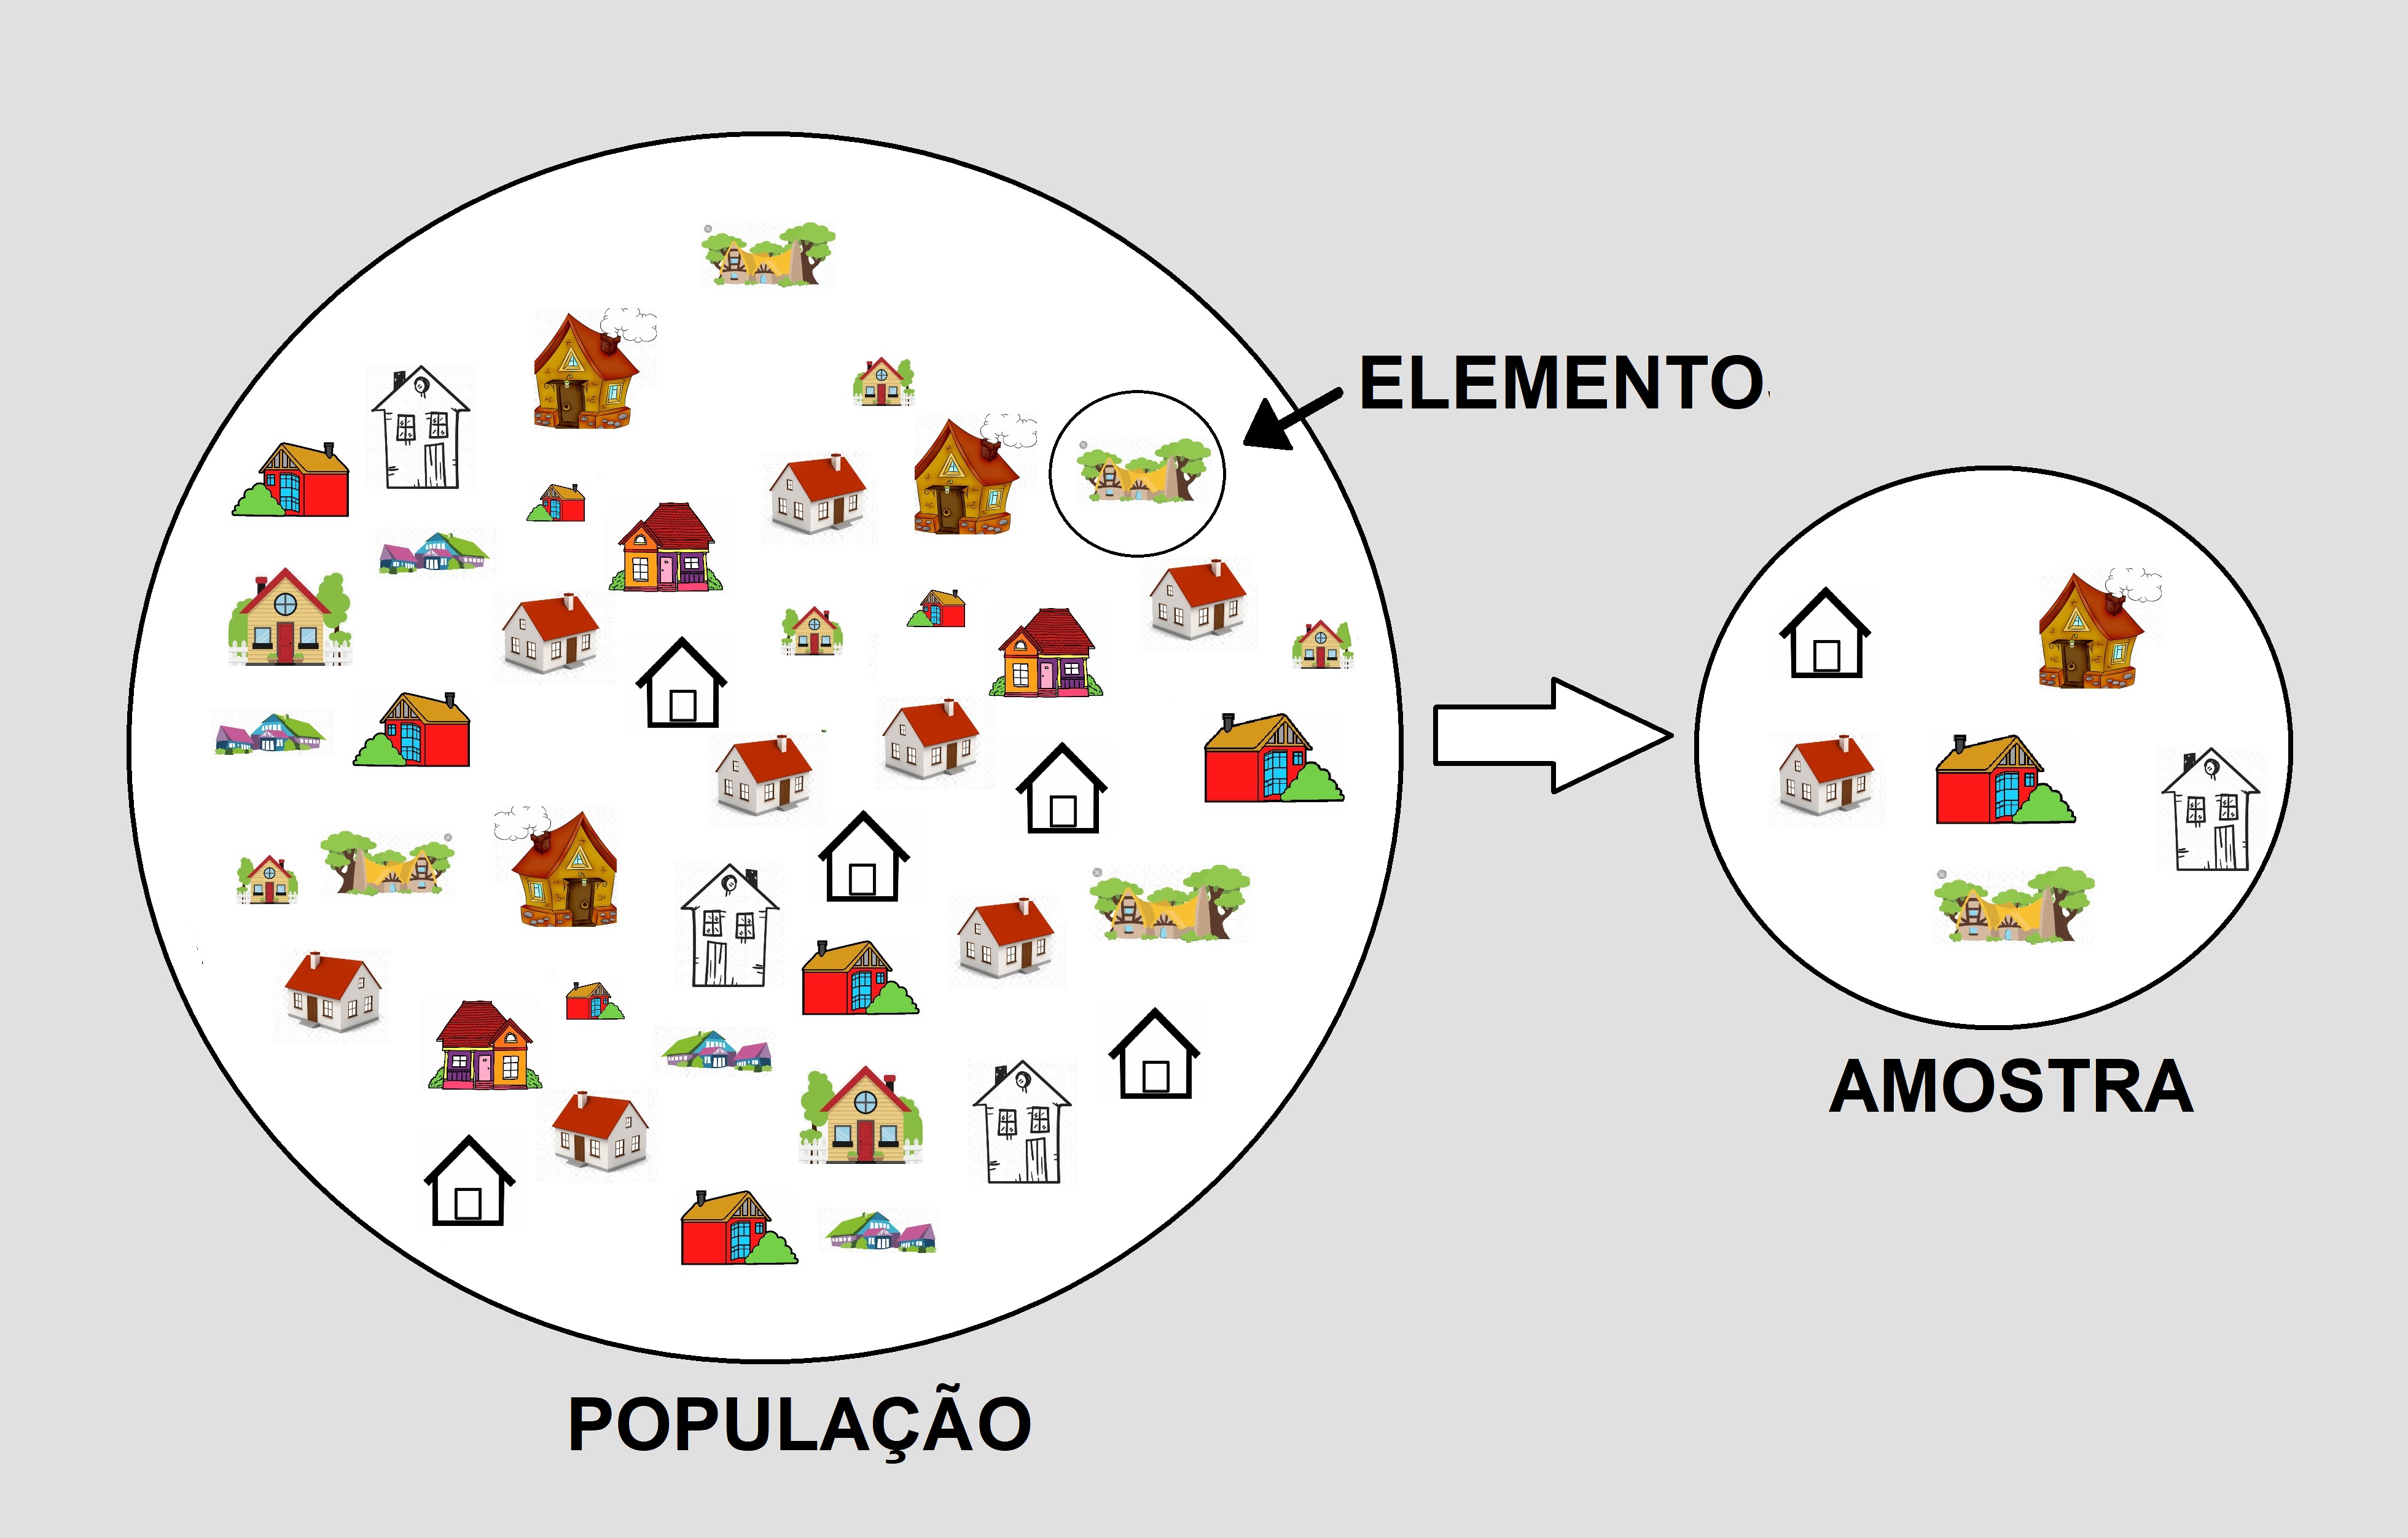
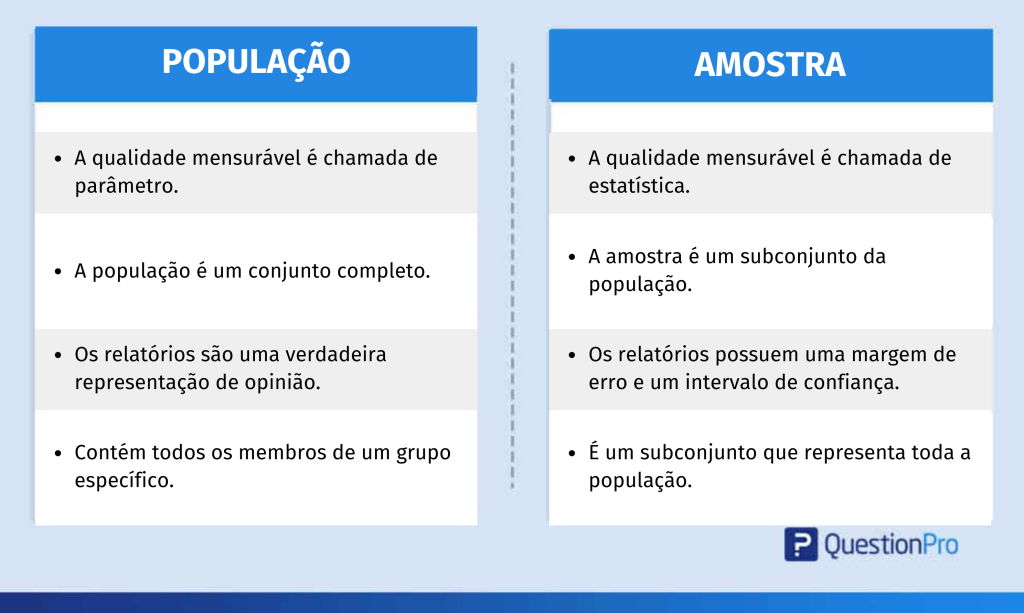
Você já precisou estimar algo sobre um grupo grande sem medir todo mundo. Talvez seja o tempo médio de atendimento num call center com 4.000 funcionários, ou a taxa de defeito num lote de produção que sai em milhões de unidades. O conceito por trás disso é o que chamamos de estatistica amostra e população, e a prática costuma ser bem mais chata do que a teoria ensina. População é o conjunto completo de elementos que você quer estudar. Amostra é o pedaço que você realmente consegue coletar dados. A ideia é usar esse pedaço pra inferir algo sobre o todo. Parece simples até você tentar aplicar num problema real e descobrir que os pressupostos do livro didático não se sustentam.
Como escolher estatistica amostra e população no dia a dia
O primeiro passo que a maioria das pessoas pula é definir claramente o parâmetro de interesse. Você quer estimar uma média? Uma proporção? Um desvio padrão? O tamanho da amostra e o método de recolhimento variam drasticamente dependendo disso. Se o objetivo é uma média com margem de erro de 5%, você precisa de um cálculo diferente de quando o foco é proporção num cenário de prevalência baixa, digamos, menos de 2%. Para amostragem aleatória simples, a fórmula do tamanho amostral para estimar uma média com intervalo de confiança de 95% é: n = (Z × / E)²
Onde Z é aproximadamente 1,96, é o desvio padrão da população (ou um estimateiro seu) e E é a margem de erro desejada. Quando é desconhecido, como acontece na maioria das vezes, você usa um estudo piloto ou um valor baseado em literatura anterior. Fazer isso de cabeça é receita para erro. Pra proporções, a fórmula fica: n = (Z² × p × (1-p)) / E²

Onde p é a proporção esperada. O pior caso, que maximiza o tamanho amostral, é quando p = 0,5. Se você acha que a proporção real é perto de 0,1 ou 0,9, a amostra necessária cai consideravelmente. Eu trabalhei numa pesquisa de satisfação onde o cliente insistia em amostra de conveniência por questões de custo. A amostra tinha 340 respondentes, o que, pela fórmula acima, daria margem de erro aceitável se a amostra fosse probabilística. Não era. O viés de autoseleção distorcia os resultados de forma sistemática e silenciosa. A média parecia boa, o desvio padrão estava normal. Mas a população de verdade tinha um perfil demográfico completamente diferente do que aparecia nos dados. Eu sugeri uma amostragem estratificada por região e faixa etária, o que aumentou o trabalho de campo em cerca de 40%, mas reduziu o viés de forma mensurável. O resultado final teve uma precisão real muito superior ao que a amostra de conveniência prometia de forma ilusória.
Vieses que destroem amostras sem aviso
A amostragem probabilística garante que cada elemento tenha uma chance conhecida e não nula de ser selecionado. Isso permite calcular intervalos de confiança com fundamentação teórica. Fora disso, você tá medindo algo, mas não conseguequantificar o erro de forma rigorosa. Isso não significa que amostras não probabilísticas sejam inúteis. Significa que as conclusões têm limites claros que muitas pessoas ignoram. Um viés comum é o de não resposta. Digamos que você envia um survey por email para 2.000 pessoas e só 400 respondem. Os 1.600 que não responderam podem ter opiniões sistematicamente diferentes. Esse gap é uma fonte de viés que não aparece em nenhum resumo estatístico automático. A solução prática é comparar quem respondeu com quem não respondeu usando variáveis demográficas disponíveis, e aplicar pesos de correção quando possível. Amostragem cluster é útil quando a população está geograficamente dispersa. Você sorteia bairros inteiros em vez de endereços individuais. O custo cai, mas a precisão também cai porque unidades dentro do mesmo cluster tendem a ser mais semelhantes entre si do que com o restante da população. O fator de efeito de desenho (deff) quantifica essa perda. Em clusters bem homogêneos, o deff pode ser 1,5 ou 2, o que significa que sua amostra precisa ser 50% a 100% maior pra atingir a mesma precisão de uma amostragem aleatória simples.
Outro ponto que quase ninguém leva a sério é a normalidade da distribuição amostral. O teorema central do limite diz que a média amostral converge pra normalidade conforme n cresce, mas "cresce" depende da distribuição original. Se a distribuição é fortemente assimétrica ou tem caudas pesadas, você pode precisar de amostras acima de 100 ou 200 antes que a aproximação normal seja razoável. Para dados com assimetria extrema, transformações logarítmicas ou métodos bootstrap são alternativas práticas.
Ferramentas e fluxo prático
Na prática, a maioria das pessoas usa Excel, R ou Python. O R tem pacotes como survey e sampling que lidam com complexidades de desenho amostral diretamente. No Python, o statsmodels e o pandas fazem o trabalho básico, mas para amostragem complexa com pesos e clustering, o pacote pingou ou a função svydesign do R são mais adequados. Um fluxo típico funciona assim: defina o parâmetro, estime o desvio padrão ou proporção com base em dados anteriores ou piloto, calcule o tamanho amostral, escolha o desenho de amostragem, colete os dados, aplique pesos se necessário, estime o parâmetro e construa o intervalo de confiança. Cada etapa tem armadilhas. O cálculo do tamanho amostral muitas vezes ignora a fração de correção quando a amostra representa uma fatia significativa da população. Se você amostreia 10% de uma população de 500 elementos, o tamanho efetivo da amostra é maior do que a fórmula simples indica porque há menos variabilidade residual. A correção é multiplicar o denominador por (N-n)/(N-1), onde N é o tamanho populacional e n o tamanho amostral. Em populações finitas pequenas, isso pode reduzir a amostra necessária em 20% ou mais.
Se você precisa de uma ferramenta pronta, o G*Power é gratuito e cobre a maioria dos cálculos de tamanho amostral para testes t, ANOVA, correlação e regressão. Pra amostragem descritiva simples, calculadoras online como a do SurveyMonkey ou do Qualtrics funcionam, mas verifique sempre os pressupostos por trás delas. Muitas assumem população infinita e proporção de 50%, o que gera tamanhos amostrais desnecessariamente grandes quando não se aplica ao seu caso.
Limitações honestas
Nenhuma amostra elimina o viés de seleção por completo. Nenhum tamanho amostral grande corrige uma população mal definida. Se você não consegue descrever com precisão quem compõe a população-alvo, nenhum número mágico de respondentes vai salvar a análise. A amostra mais bem planejada do mundo só é tão boa quanto a definição da população. Métodos Bayesianos oferecem uma alternativa interessante quando a amostra é pequena ou os dados são escassos. Em vez de depender exclusivamente da amostra atual, você incorpora informação anterior por meio de distribuições a priori. Isso é especialmente útil em contextos onde coletar uma amostra grande é proibitivamente caro ou impossivelmente demorado. A contrapartida é que os resultados dependem das escolhas de prior, o que exige transparência e sensibilidade. A regra prática que eu sigo é: quanto mais caro for errar a decisão baseada nos dados, mais rigoroso preciso ser com o desenho amostral e a análise de sensibilidade. Decisões operacionais simples permitem amostras menores e métodos mais simples. Decisões estratégicas ou regulatórias merecem o esforço de um desenho robusto desde o início.
O que separa uma análise útil de uma análise que parece bonita mas engana é a honestidade sobre o que os dados conseguem e não conseguem dizer. Amostra e população não são conceitos abstratos. São decisões diárias que determinam se suas conclusões aguentam qualquer questionamento sérico ou desbambam no primeiro olhar crítico.
Galeria
-

A Partir Do Conceito De População E Amostra - FDPLEARN -
População e amostra: qual a diferença? Saiba aqui!
