Estatistica Inferencial E Descritiva

Trabalhando com dados reais: um guia prático
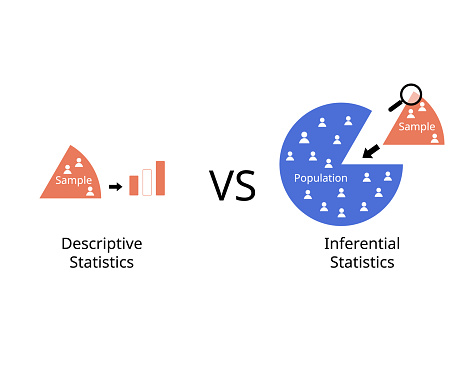
Você já abriu um arquivo CSV com milhares de linhas e não fez ideia do que estava olhando. Isso é comum no começo. A estatística descritiva serve exatamente para isso — tirar essa bagunça e transformar em algo que você consiga ler sem precisar de um coquetel. Já a inferencial entra quando você quer dar o próximo passo e dizer algo sobre uma população inteira baseada apenas nos dados que coletou. São coisas diferentes que, na prática, quase sempre andam juntas. A descrição é mais simples. Você calcula média, mediana, desvio padrão, variância, quartis, amplitude. É basicamente resumir o que os dados mostram. Ferramentas como Excel, R, Python com pandas ou mesmo SPSS fazem isso em segundos. O problema é que muita gente trava na hora de interpretar. Uma média de 45 pode parecer alta, mas se o desvio padrão for 30, essa média praticamente não diz nada sobre a dispersão real dos valores. O quartil 1 e o quartil 3 contam mais do que a média isolada, especialmente quando a distribuição não é normal.
O que saber sobre estatistica inferencial e descritiva na prática
A parte inferencial é onde as coisas ficam interessantes e também onde eu costumo perder tempo. Teste de hipótese, intervalos de confiança, regressão, ANOVA, qui-quadrado. Cada um tem suas premissas. Se você pular a verificação dessas premissas, o resultado é lixo organizado com nível de significância bonito. Nunca subestime isso. Um dos erros mais frequentes é aplicar um teste paramétrico em dados que claramente não seguem distribuição normal. O teste t de Student é resistente a desvios moderados de normalidade, mas se a assimetria for extrema — coisa que acontece com dados de receita, tempo de resposta ou concentração de mercado — os resultados distorcem. Nesses casos, eu uso transformações como logarítmica ou raiz quadrada antes, ou simplesmente parto para testes não-paramétricos como o Mann-Whitney ou Kruskal-Wallis. Funciona melhor na maioria das situações do que forçar o modelo. Outro ponto que poucas pessoas levam a sério é o poder estatístico. Rodar um teste com 15 observações por grupo e achar que "não houve diferença significativa" não significa que não existe diferença. Pode ser que seu estudo simplesmente não tinha poder para detectar o efeito. Antes de planejar qualquer análise, faça um cálculo de power. O G*Power é gratuito e leva dois minutos. Sem isso, você está navegando no escuro.
Eu lembro de um projeto em que fiz uma regressão linear múltipla com variáveis bastante correlacionadas. O R² ficou bom, os coeficientes pareciam sólidos, mas os erros padrão estavam inflados. VIF acima de 10 em três variáveis. Multicolinearidade escondida. O modelo parecia bom mas as interpretações individuais eram inconsistentes. A solução foi usar uma análise de componentes principais para reduzir a dimensionalidade e depois rodar a regressão com os componentes extraídos. Os resultados mudaram completamente.

Quando usar cada abordagem
Descritiva responde perguntas como: qual é a tendência central dos dados? Qual a dispersão? Qual a forma da distribuição? É útil para relatórios, dashboards e para qualquer pessoa que precise entender o cenário antes de tomar uma decisão. Não exige suposições pesadas. Só pede dados organizados e limpos. Inferencial responde perguntas como: essa diferença entre dois grupos é real ou provável sorteio? Esse relacionamento entre variáveis se mantém na população? Posso generalizar o que observei na amostra? Exige suposições sobre a população e sobre a amostra. Se essas suposições não forem verificadas, a inferência perde o sentido. Na minha experiência, o fluxo mais eficiente é: limpar os dados primeiro, fazer a análise descritiva completa — incluindo visualizações como histogramas e boxplots — verificar as premissas dos testes que você pretende aplicar, escolher o teste adequado com base nas características dos dados, executar e só então interpretar. Pular alguma dessas etapas gera retrabalho e, na pior das hipóteses, conclusões erradas.
Uma dica prática que economiza tempo: use o Python com a biblioteca seaborn para gerar visualizações descritivas rapidamente. Sete linhas de código e você já tem histogramas, diagramsas de caixa, matrizes de correlação e gráficos de densidade. Fica pronto enquanto toma um café. O gasto médio de tempo entre fazer isso manualmente no Excel e fazer com o script costuma ficar em torno de dez minutos contra quarenta minutos. Sobre softwares, a escolha depende do volume de dados e da familiaridade. Para análises pontuais com poucos milhares de linhas, o Excel com o suplemento Analysis ToolPak resolve. Para datasets maiores ou análises repetitivas, o R com o pacote tidyverse ou o Python com pandas e statsmodels são mais adequados. O JASP é uma opção intermediária boa para quem quer interface gráfica com testes bayesianos incluídos, mas perde flexibilidade quando a análise sale da caixa padrão. Uma limitação que precisa ficar clara: nenhum desses métodos corrige dados mal coletados. Amostragem enviesada, variáveis mal definidas, respostas consistentemente incompletas — nada de descrição ou inferência elegante conserta isso. O famoso garbage in, garbage out se aplica integralmente aqui. Antes de any análise avançada, invista tempo na qualidade da coleta.
Se você está começando agora, o caminho mais direto é: domine a descrição básica no Excel ou Google Sheets, entenda o conceito de distribuição e como ler um histograma, aprenda a diferença entre parâmetros e estatísticas de amostra, depois avance para os testes t e qui-quadrado. Só depois disso entre em regressões e modelos mais complexos. A ordem importa.
Galeria
-
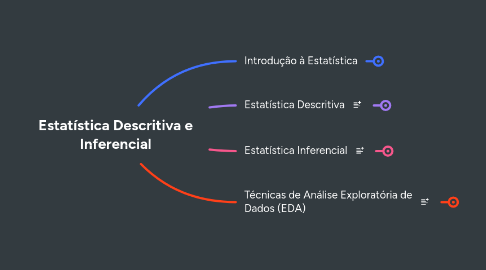
Estatística Descritiva e Inferencial | MindMeister Mapa Mental -

Estatística Descritiva E Inferencial: Diferenças E Usos – HZVAJ -
Estatística Descritiva e Inferencial | MindMeister Mapa Mental

