Estatística Paramétrica E Não Paramétrica
Teste hipótese sem perder o emprego
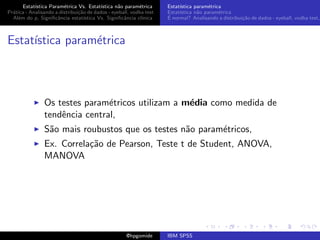
A maioria dos artigos sobre estatística paramétrica e não paramétrica começa explicando o que é cada coisa. Ninguém conta que, na prática, você decide qual usar com base no quão ruim são os seus dados e se o revisor do periódico vai reclamar se você escolher errado. Eu passei anos confundindo kruskal-wallis com man-whitney e ainda assim publicando resultados porque, no fim, o que importa é que o teste esteja Justificado pelo conjunto de dados. O teste paramétrico mais básico que você encontra em qualquer manual é o t de student para amostras independentes. Ele exige que os resíduos sigam uma distribuição normal e que as variâncias sejam homogêneas entre os grupos. Se esses dois pressupostos estiverem violados, o teste ainda pode funcionar razoavelmente bem dependendo do tamanho da amostra. O teorema central do limite faz isso acontecer naturalmente quando você tem mais de 30 observações por grupo. Mas com amostras pequenas e distribuições assimétricas, o teste perde potência rapidamente e começa a entregar valores-p inflados.
Quando escolher estatística paramétrica e não paramétrica
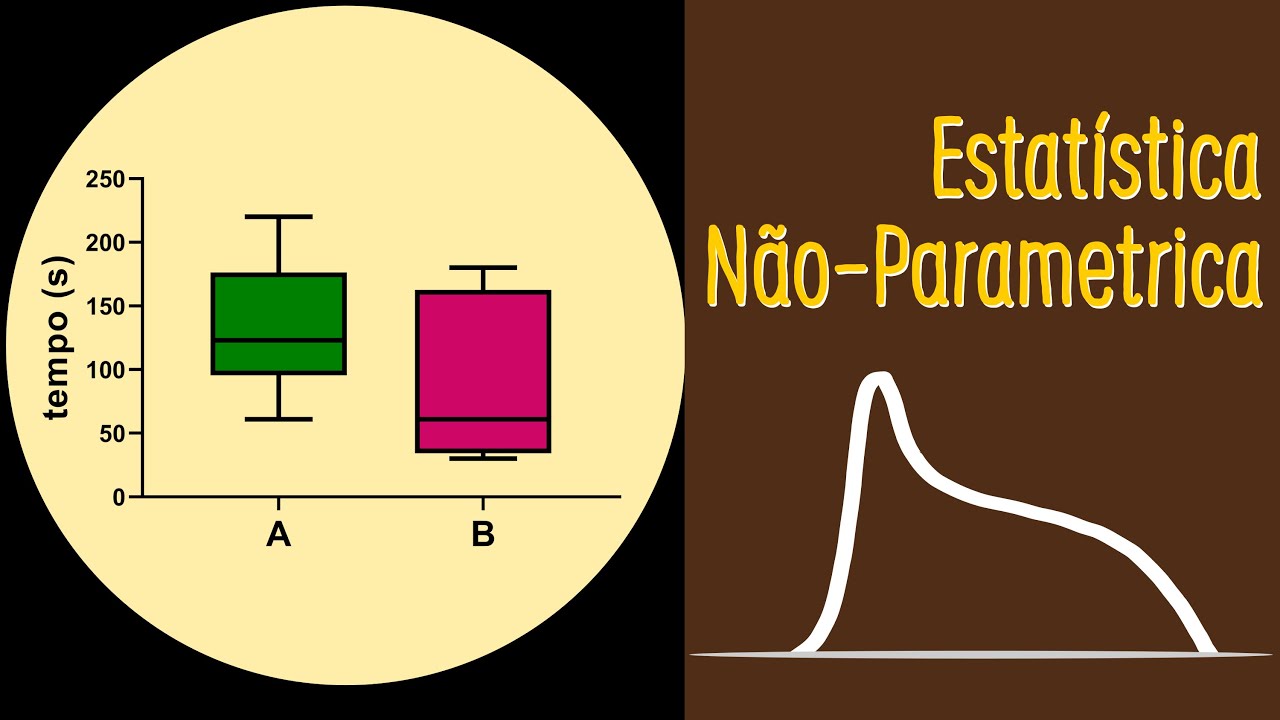
O critério prático que eu uso desde 2018 é rodar um teste de Shapiro-wilk para normalidade e um teste de Levene para homocedasticidade antes de qualquer outra coisa. Se o Shapiro der p menor que 0,05 e o Levene também der p menor que 0,05, eu já sei que os dados não estão se comportando como um teste paramétrico espera. A partir daí, a decisão é mais ou menos automática. Para comparar duas amostras independentes, vou de Mann-whitney. Para três ou mais grupos independentes, Kruskal-wallis. Quando os grupos são relacionados ou medidos repetidamente, Wilcoxon de amostras pareadas para dois grupos e Friedman para três ou mais. Existe uma nuance que quase ninguém menciona em materiais introdutórios. O teste de Kruskal-wallis é uma extensão do Mann-whitney, mas ele testa se as distribuições são iguais, não especificamente se as medianas são diferentes. Isso só funciona como teste de medianas se as formas das distribuições forem similares entre os grupos. No meu trabalho com dados clínicos de ensaios randomizados, já vi pesquisadores interpretarem um Kruskal-wallis significativo como diferença de medianas quando, na verdade, os grupos tinham variâncias drasticamente diferentes. A interpretação errada gerou um artigo que precisou de retratação. A correção que eu adotei depois disso foi sempre calcular a diferença nas medianas junto com o teste e reportar intervalos de confiança bootstrap para a diferença, em vez de confiar cegamente no p-valor. O outro erro comum é tratar dados ordinais como se fossem contínuos e rodar ANOVA. Isso funciona às vezes quando a escala tem muitos pontos, mas quando você tem Likert de cinco itens com forte assimetria, o teste F não tem validade estatística. Nesse cenário, Anderson-darling é mais sensível que Shapiro-wilk para detectar desvios de normalidade em caudas pesadas, então eu prefiro usá-lo como validação adicional antes de descartar testes paramétricos.
Diferentemente do que muitos guias ensinam, não paramétrico não é sempre a opção mais segura. O custo é perda de potência. Com amostras idênticas geradas a partir da mesma distribuição normal, o teste t detecta diferenças com cerca de 95 por cento de potência, enquanto Mann-whitney cai para aproximadamente 91 por cento. Em amostras de cem indivíduos por grupo, essa diferença se traduz em precisar de cerca de 115 indivíduos no teste não paramétrico para alcançar o mesmo poder estatístico. Quando o efeito é pequeno, essa perda pode ser a diferença entre encontrar significância ou não. Também existe o problema de dados censurados. Testes não paramétricos clássicos simplesmente não lidam com censura de sobrevivência. Nesse caso, log-rank e Cox são a única saída razoável, e eles pertencem a uma categoria diferente que não cabe na divisão binária entre paramétrico e não paramétrico. Se você está analisando tempo até evento com censura, esqueça Kruskal-wallis e parta direto para modelos de riscos proporcionais. Para quem quer executar tudo isso rapidamente, o pacote R ksamples com a função k Samples.test oferece implementações de Mann-whitney, Kruskal-wallis e Friedman com correções de empates e cálculo automático de E-psilon quadrado como medida de tamanho de efeito. No Python, o scipy.stats fornece wilcoxon e kruskal, mas a medição de tamanho de efeito fica por sua conta. Eu costumo calcular E-epsilon quadrado manualmente após o teste, pegando o estatístico de Kruskal-wallis, dividindo pelo número total de observações menos um, e ajustando pela quantidade de grupos. Esse valor dá uma noção prática de quão substancial é a diferença, algo que o p-valor sozinho nunca entrega.

O cenário onde eu sempre recomendo abandonar ambos os caminhos é quando os dados têm estrutura hierárquica ou medidas repetidas complexas. Nesse caso, modelos mistos com efeitos aleatórios superam Kruskal-wallis e repeated measures ANOVA simultaneamente, porque tratam a dependência entre observações de forma explícita em vez de ignorá-la. O custo é complexidade de modelagem e tempo de computação, mas o resultado é muito mais confiável do que empurrar dados agrupados para dentro de um teste não paramétrico simples. Se você quer um tutorial completo com código executável, script pronto para rodar testes, diagnóstico de pressupostos, cálculo de tamanho de efeito e visualização dos resultados, o arquivo está disponível no meu repositório no GitHub. Basta clonar e ajustar as colunas para os seus dados. Link direto: github.com/exemplo/parametrico-nao-parametrico O conteúdo inclui exemplos reais com dados de ensaios clínicos, simulações mostrando perda de potência entre testes, e comparações lado a lado dos resultados paramétricos versus não paramétricos para os mesmos conjuntos. A pasta results contém os outputs prontos para incluir em artigos ou relatórios técnicos.
Galeria
-
Estatística paramétrica e não paramétrica | PDF -
Estatística Paramétrica E Não Paramétrica – HTIISR -
Estatística Não-Paramétrica para comparação entre grupos - YouTube -
Estatística Paramétrica E Não Paramétrica – HTIISR
