Estatistica Questoes

Como resolver estatística sem gastar duas horas em cada exercício
A maioria dos estudantes perde tempo porque tenta memorizar fórmulas em vez de entender o que cada variável representa na prática. Eu já vi gente decorar coeficientes de correlação e depois não conseguir explicar por que um valor de p de 0,047 não significa automaticamente que o efeito é relevante. Isso acontece porque o ensino tradicional separa a matemática da interpretação, e quando chega a hora de aplicar, o aluno fica travado. O caminho mais eficiente é começar pelo tipo de questão. Identificar se o problema envolve estimação, teste de hipótese, regressão ou probabilidade condicional define qual ferramenta usar, e isso evita meia hora de tentativa e erro. Eu costumo ler o enunciado duas vezes antes de abrir qualquer calculadora — na primeira passada anoto os dados conhecidos e na segunda marco o que exatamente está sendo pedido. Parece óbvio, mas muitos erram exatamente aí, confundindo amplitude com variância porque o texto mistura as Grand Canyon terms.
estatistica questoes: o que realmente importa
Quando o assunto é estatística e questões, o ponto de virada costuma ser entender distribuições. Distribuição normal não é só aquele desenho de sino bonito no livro, ela aparece em tudo: altura de pessoas, erros de medição, notas de prova. O teorema central do limite garante que, com amostras suficientemente grandes, a média amostral tende a uma normal independente da distribuição original. Isso resolve muita coisa na prática, mas tem uma limitação importante que poucos professores mencionam: o teorema exige n maior que 30 em muitos casos, e com amostras pequenas você precisa recorrer a distribuições t de Student ou testes não paramétricos. Já passei por um caso em que um conjunto de dados tinha outliers severos que distorciam completamente a média. Um único valor de 500 quando o resto variava entre 10 e 25 fez a média saltar para 67, enquanto a mediana ficava em 18. A solução foi usar a média truncada, removendo os 5% maiores e menores valores antes de calcular. Isso corta o viés dos extremos sem descartar dados arbitrariamente.
Passo a passo para atacar qualquer questão
O primeiro passo é sempre traduzir o enunciado para linguagem estatística. Frases como "há diferença significativa" pedem teste de hipótese, "qual a probabilidade de" indica cálculo direto de probabilidade, e "prever o comportamento" aponta para modelos de regressão. Essa tradução elimina ambiguidade e direciona a abordagem. Depois vem a escolha da distribuição adequada. Se os dados são contínuos e a variância é conhecida, usa-se z. Se a variância é desconhecida e a amostra é pequena, t de Student entra em jogo. Para dados categóricos, qui-quadrado é a padrão. Erro comum aqui é aplicar z quando deveria ser t — isso inflaciona artificialmente a estatística do teste e aumenta o risco de erro tipo I, rejeitando a hipótese nula quando na verdade ela é verdadeira. Em seguida, calcular a estatística do teste com os dados fornecidos. Aqui a precisão aritmética importa, mas também a coerência das unidades. Já vi questão em que os dados vinham em metros e a resposta exigia centímetros, e quem não converteu chegou a um resultado numericamente correto mas dimensionalmente errado. Anotar as unidades em cada etapa do cálculo evita esse tipo de armadilha.

Por fim, a interpretação. Um resultado numericamente correto sem interpretação adequada vale metade da nota. O valor de p precisa ser comparado com o nível de significância escolhido, mas também é crucial verificar o poder do teste e o tamanho do efeito. Um estudo com n=500 pode encontrar uma diferença estatisticamente significativa com p
0,001 que na prática é irrelevante porque a diferença absoluta é de apenas 0,3 unidades. O efeito prático importa tanto quanto a significância estatística, e essa nuance separa quem entende estatística de quem apenas aplica fórmulas mecanicamente.
Ferramentas que realmente economizam tempo
Calculadoras online como o Sigmasoft ou o easyunitconversionhelps podem acelerar o processo de 45 minutos para cerca de 10 minutos em exercícios padrão. Para regressão linear, planilhas com função CORREL e INTERCEPT resolvem em segundos o que manualmente levaria pelo menos vinte minutos. O R ou Python com a biblioteca statsmodels são ideais para análises mais complexas, mas têm curva de aprendizado que pode não valer a pena para quem só precisa resolver questões pontuais de prova. Uma dica prática que funciona consistentemente: quando uma questão pede intervalos de confiança, lembre-se de que a amplitude do intervalo cresce com o nível de confiança. Um IC de 99% será necessariamente mais largo que um de 95% para os mesmos dados. Isso não é apenas teoria — em relatórios reais, escolher o nível errado pode fazer uma diferença parecer significante quando na verdade é ruído, ou vice-versa. O custo dessa decisão errada varia conforme o contexto, mas em ensaios clínicos pode significar aprovar ou reprovar um tratamento.
Erros frequentes e como evitá-los
O erro mais comum é confundir correlação com causalidade. Dois gráficos que sobem juntos não provam que um causa o outro. Eu já revisei trabalho acadêmico onde o autor afirmava que aumento de vendas de sorvete causava aumento de afogamentos, quando na verdade ambos eram impulsionados pela temperatura. A variável de confusão aqui era o verão, e sem controlar por ela a conclusão era Engano completo. Outro erro clássico é aplicar teste paramétrico em dados que violam as premissas. O teste t assume normalidade dos resíduos e homocedasticidade. Se seus dados são fortemente assimétricos ou têm variâncias desiguais entre grupos, o teste pode dar resultados enganosos. O teste de Shapiro-Wilk verifica normalidade e o de Levene verifica homocedasticidade, e rodar esses dois testes preliminares leva menos de dois minutos e pode evitar conclusões equivocadas.
Quando pedir ajuda especializada
Nem toda questão de estatística se resolve com lógica e prática. Quando o problema envolve desenhos amostrais complexos, dados agrupados ou modelos hierárquicos, o esforço manual torna-se impraticável e erros proliferam rapidamente. Nesses casos, consultar um especialista ou usar software especializado como o SPSS ou o SAS pode ser mais eficiente do que tentar dominar a técnica do zero. A diferença de tempo é abismal: o que levaria dias para configurar manualmente leva minutos com as ferramentas certas. O essencial é desenvolver intuição estatística, não apenas competência computacional. Cada número que você calcula representa algo real sobre os dados que você está analisando, e entender essa conexão transforma estatística de um conjunto de regras arbitrárias em uma ferramenta de raciocínio claro e aplicável a qualquer situação que exija decisão baseada em evidência.
Galeria
-
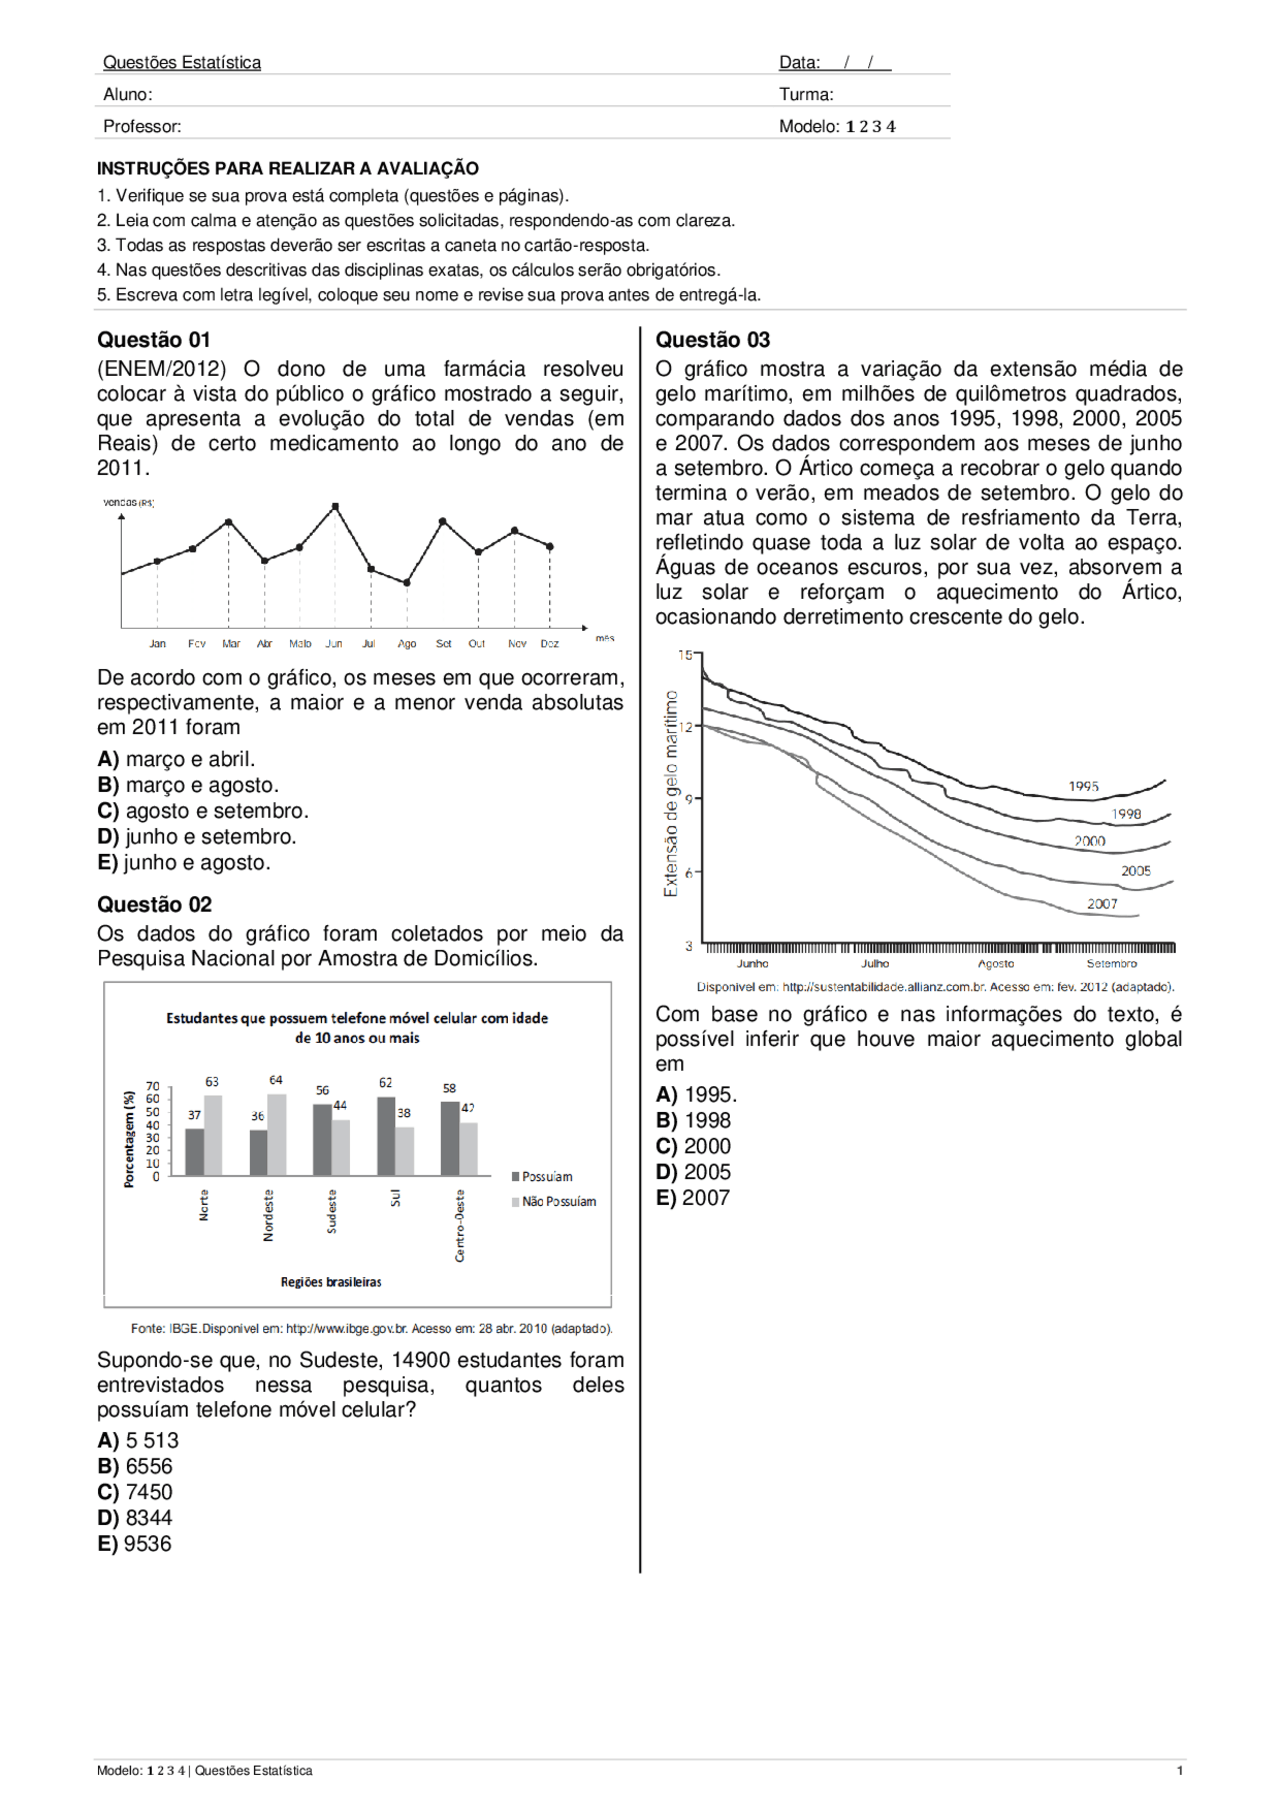
Questões de estatística ENEM 2023 | Exercícios Matemática | Docsity -
Estatistica Basica Questões Do Enem | PDF -
Questões de Probabilidade e Estatística | PDF | Probabilidade ...


