Estrutura Secundária Da Proteína

Predizer estrutura secundária de proteínas não é o que parece
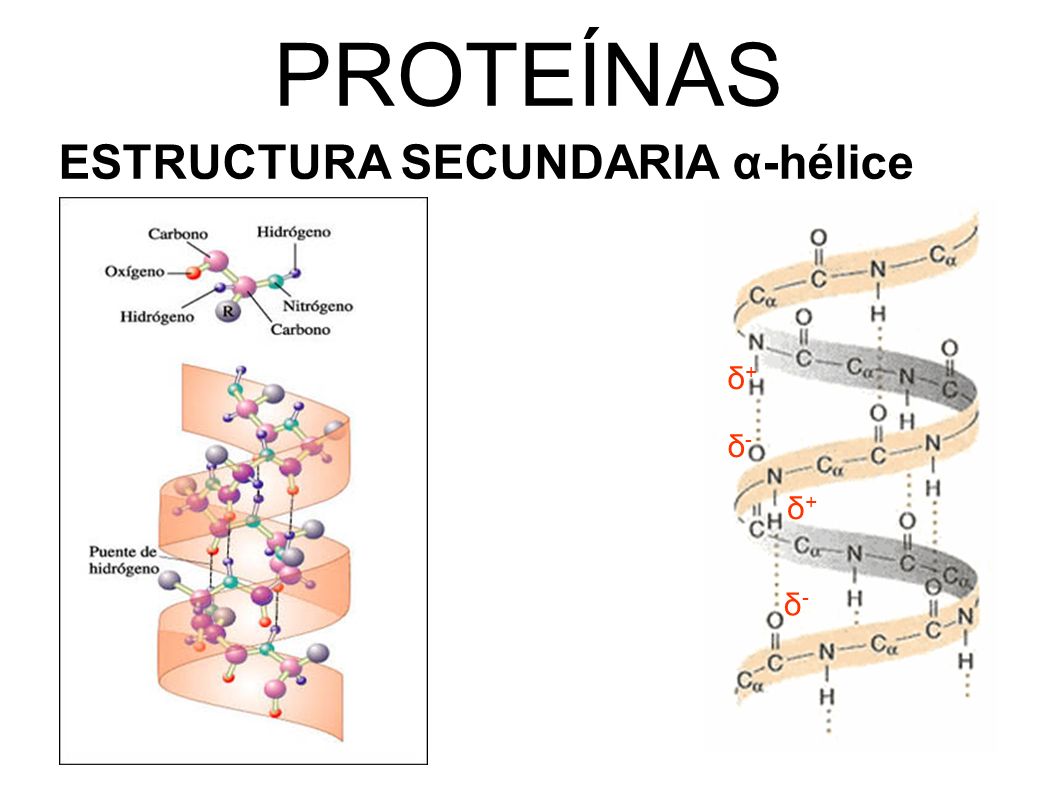
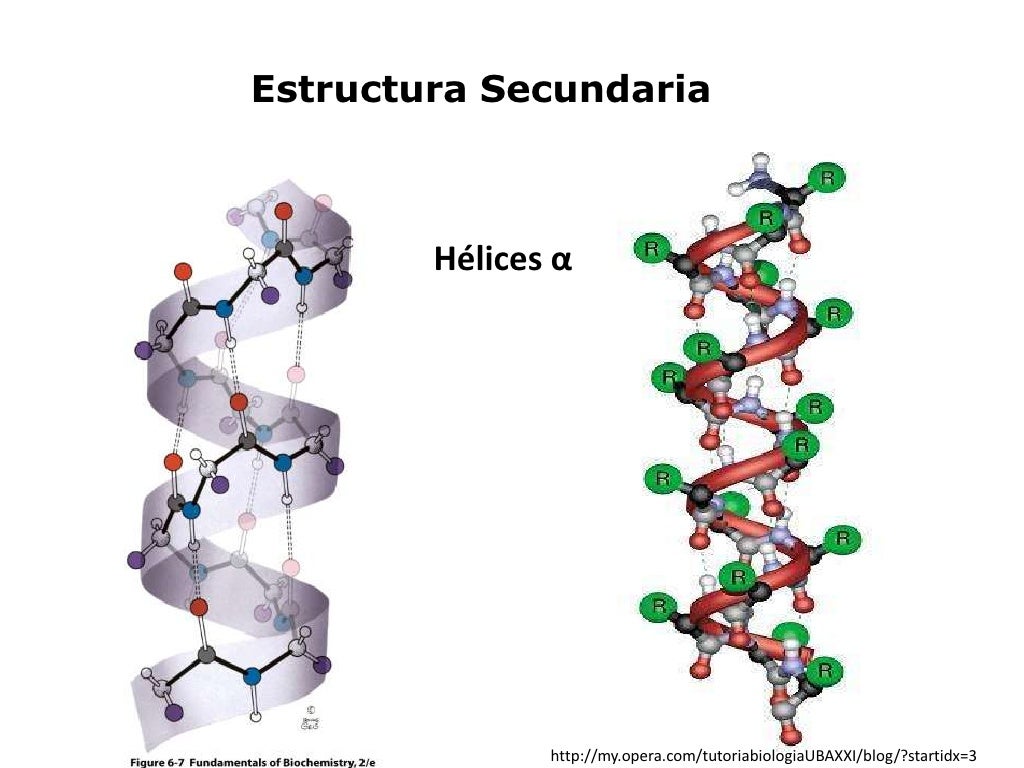
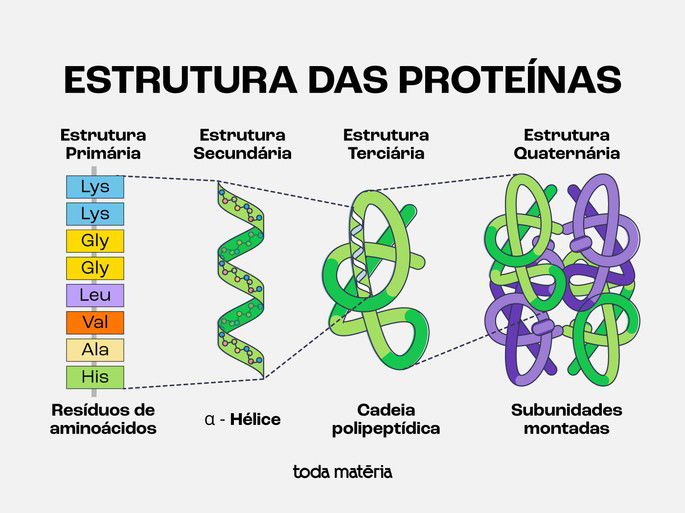
A estrutura secundária da proteína se refere aos padrões locais de enrolamento da cadeia polipeptídica, estabilizados por pontes de hidrogênio entre os grupos da espinha dorsal. Os dois mais conhecidos são a hélice alfa e a folha beta, mas existem dezenas de classificadores geométricos diferentes usados na prática. A teoria de Pauling e Corey de 1951 ainda é o fundamento, mas quem trabalha com isso todo dia sabe que a realidade é muito menos limpa do que os livros mostram. O método padrão para determinar estrutura secundária experimentalmente é espectroscopia de dicroísmo circular (CD). Um espectro de CD típico mostra um mínimo duplo em torno de 208 e 222 nanômetros para hélices alpha, e um único mínimo em cerca de 216 nanômetros para folhas beta. A interpretação quantitativa depende de algoritmos como CDSSTR ou CONTIN/LL, que decompõem o espectro em contribuições fractionárias. Esses métodos têm margem de erro de mais ou menos 3 a 5 por cento em amostras bem comportadas, mas pioram drasticamente com proteínas desordenadas ou membranares.
O que realmente define a estrutura secundária da proteína na prática
A classificação mais usada no campo é o esquema DSSP, desenvolvido por Bucher e Kabsh. Ele mapeia padrões específicos de pontes de hidrogênio da espinha dorsal em oito estados: H para hélice alfa, E para folha beta estendida, T para volta tipo turning, S para curva rígida, G para hélice 3-10, I para hélice pi, B para resíduo isolado em ponte beta, e coil para o resto. Existem variações como o STRAND e o DEFINE que fazem classificações ligeiramente diferentes, e ocasionalmente eles discordam entre si nos resíduos de fronteira entre elementos estruturais. O que muita gente não considera é que a estrutura secundária não é uma propriedade fixa. Uma mesma sequência pode adotar conformações secundárias diferentes dependendo das condições. Encontrei esse problema na prática quando estava analisando uma proteína de fusão que eu esperava conter uma região desordenada extensa. O DSSP aplicado à estrutura cristalina indicava coil, mas o espectro de CD mostrava sinais claros de hélice. A explicação era simples: na cristalização, a proteína formava empacotamentos cristalograficos que induziam um enrolamento local que não existia em solução. Mudei a abordagem e usei predição baseada em sequência com PSIPRED combinada com dados de SAXS, o que me deu uma imagem muito mais precisa do comportamento em solução.
Métodos computacionais de predição
A predição de estrutura secundária por computador evoluiu bastante. Métodos baseados em alinhamento de sequências múltiplas, como PSIPRED e Jpred, usam redes neurais alimentadas por perfis PSI-BLAST e atingem acurácia do tipo Q3 de cerca de 80 a 84 por cento. Isso significa que acertam o estado primário (hélice, folha ou coil) em roughly 8 em cada 10 resíduos. Métodos mais recentes como RaptorX-Property e DeepCSP usam redes convolucionais profundas e chegam a marcas de 86 a 88 por cento em benchmarks padrão. O ponto que ninguém conta é que Q3 não é um número muito informativo por si só. Uma predição pode atingir 85 por cento de Q3 sendo completamente errada nos resíduos que importam, como sítios ativos ou regiões de reconhecimento molecular. A métrica SS% é mais rigorosa porque considera apenas os resíduos classificados como hélice ou folha e mede a acurácia dentro desse subconjunto. Valores de SS% acima de 75 por cento já são considerados bons na literatura. Outro problema comum é que os benchmarks usam conjuntos de dados com baixa similaridade de sequência, mas na prática você frequentemente trabalha com famílias proteicas onde a conservação estrutural é alta e a predição é mais confiável do que o número geral sugere. Aqui vai algo contra-intuitivo que aprendi na marra: previsores de estrutura secundária Performam melhor em regiões regulares do que em transições. A hélice alfa é predita com alta confiança porque tem padrões de propensão aminoacídica bem definidos. A folha beta é mais difícil porque depende de contexto de longo alcance. E o coil é praticamente impossível de diferenciar de turns e loops com confiabilidade. Quando você vê um resíduo rotulado como coil, na verdade pode ser qualquer coisa que não seja hélice nem folha. Isso importa porque muitos pesquisadores tratam coil como sinônimo de desordem, o que é uma categoria errada.
Ferramentas acessíveis
Para análise rápida, o DSSP roda localmente a partir de estruturas PDB e é gratuito. A instalação leva uns cinco minutos e não tem dependências complicadas. Para predição a partir de sequência, o PSIPRED tem servidor web gratuito em psipred.biochem.ucl.ac.uk, e o Jpred em jpred.org. Ambos aceitam FASTA e retornam classificações por resíduo com escores de confiança. Se você precisa processar centenas de sequências, o NetSurfP-3.0 oferece API online e prediz estrutura secundária junto com acessibilidade de superfície e colunas de desordem em uma única chamada, economizando tempo de pipeline. Existe também a opção de rodar métodos locais com Biopython e o módulo DSSP embutido. Um script simples que aplica DSSP a um diretório inteiro de arquivos PDB leva aproximadamente 0,2 segundos por estrutura em hardware padrão. Isso é significativamente mais rápido do que submeter cada arquivo manualmente ao servidor web, que tem limitações de taxa e fila de espera.
Problemas comuns e onde os métodos falham
A principal limitação dos métodos atuais é que eles não capturam mudanças conformacionais induzidas por ligação. A estrutura secundária de uma proteína livre pode ser radicalmente diferente da mesma proteína com ligante. Isso é particularmente problemático para proteínas intrinsecamente desordenadas, que podem adotar estrutura secundária apenas após interação com um parceiro. Nenhum preditor atual lida bem com esse cenário sem dados experimentais adicionais. Outro problema prático é que a qualidade da entrada determina tudo. Se você está usando uma modelo homológico com identidade de sequência abaixo de 30 por cento, a estrutura secundária predita pode ter erros sistemáticos nas regiões de inserto e delet. Recomendo sempre validar com pelo menos dois métodos diferentes antes de tomar decisões experimentais baseadas na predição. Eu já perdi dias otimizando condições de cristalização para uma região que eu acreditava ser hélice baseada em uma única ferramenta, quando na verdade era um turno irregular. Dois preditores discordantes são um sinal vermelho que não deve ser ignorado. A estrutura secundária é um conceito útil, mas é uma simplificação. A realidade biofísica é contínua e os estados intermediários são mais comuns do que a classificação discreta sugere. Trate as previsões como hipóteses a serem testadas, não como verdades estabelecidas.
Galeria
-
Estrutura Secundaria Da Proteina Apresentação Do PowerPoint -
Estrutura E Funcao Da Proteina Nova Função De Proteína Do Cérebro -

Folha Alfa Helice Beta Estrutura Secundária Das Proteínas Cena 3D -

Níveis Da Estrutura Proteica Do ácido Amino à Alfa-hélice, Folha Beta ...
