Eventos Dependentes E Independentes

Entendendo o que realmente importa antes de aplicar fórmulas
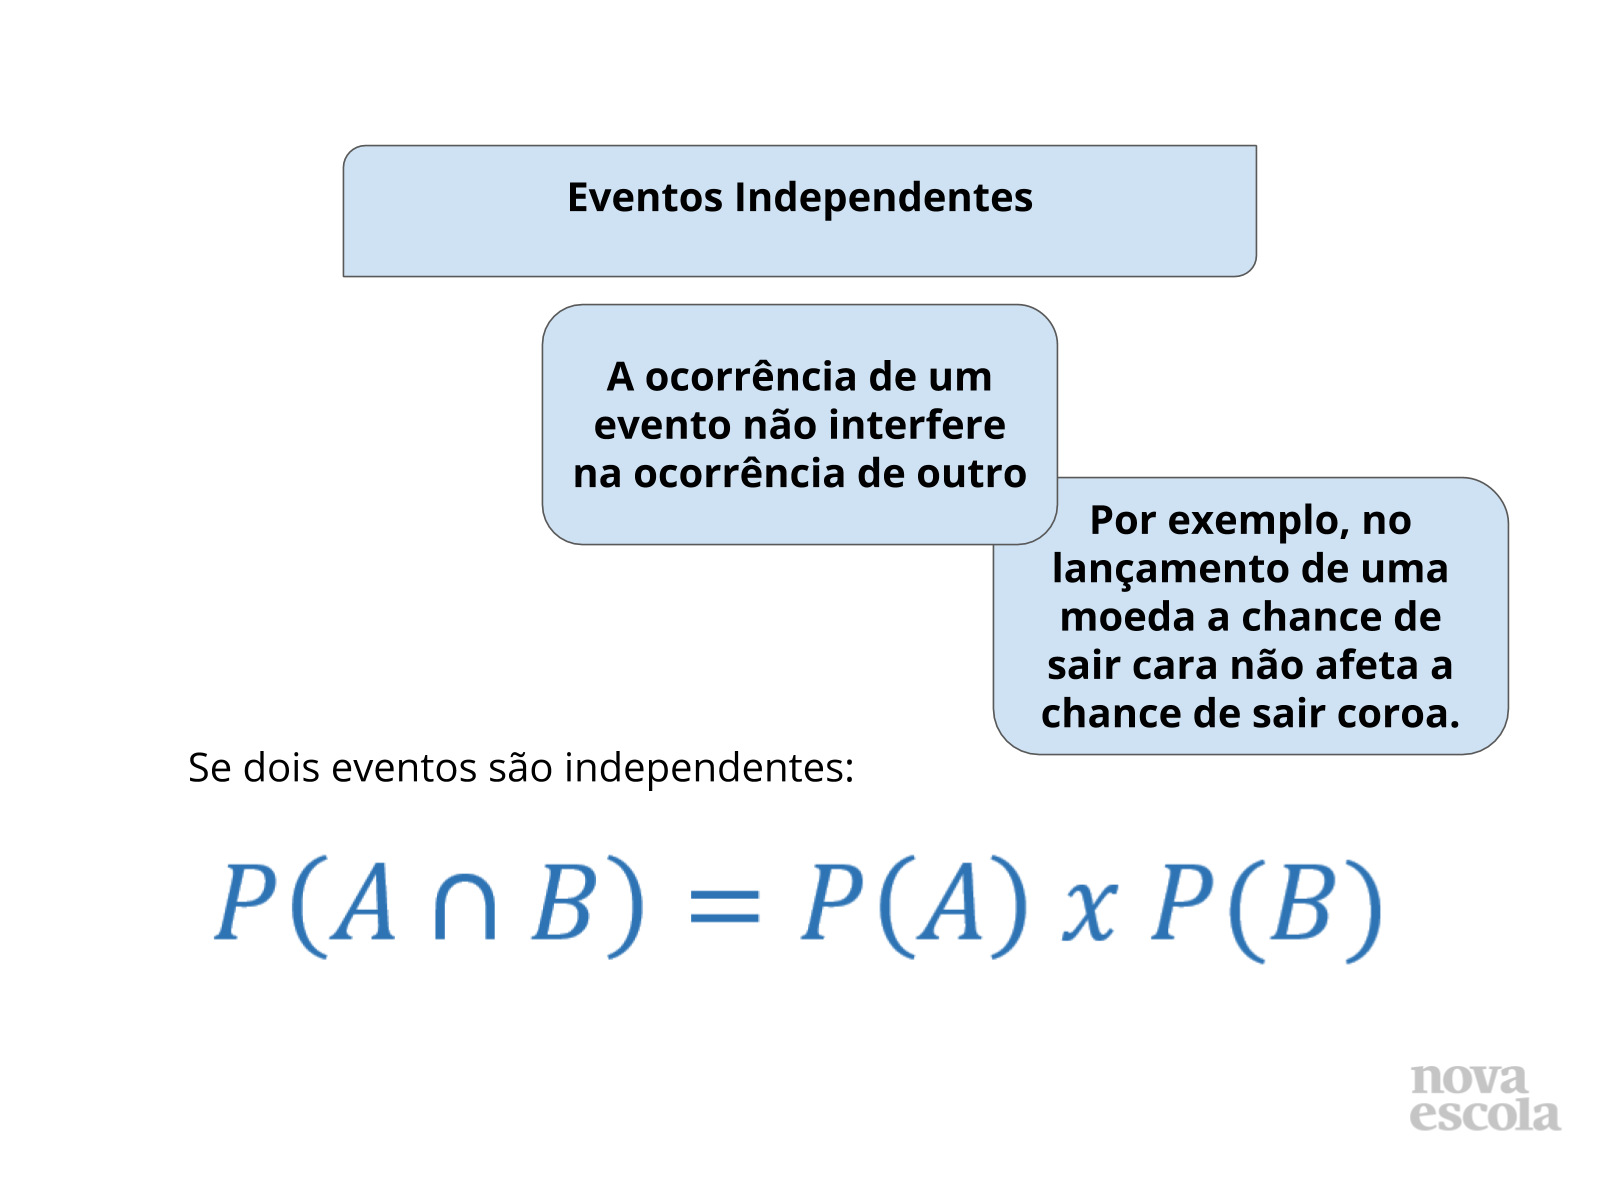
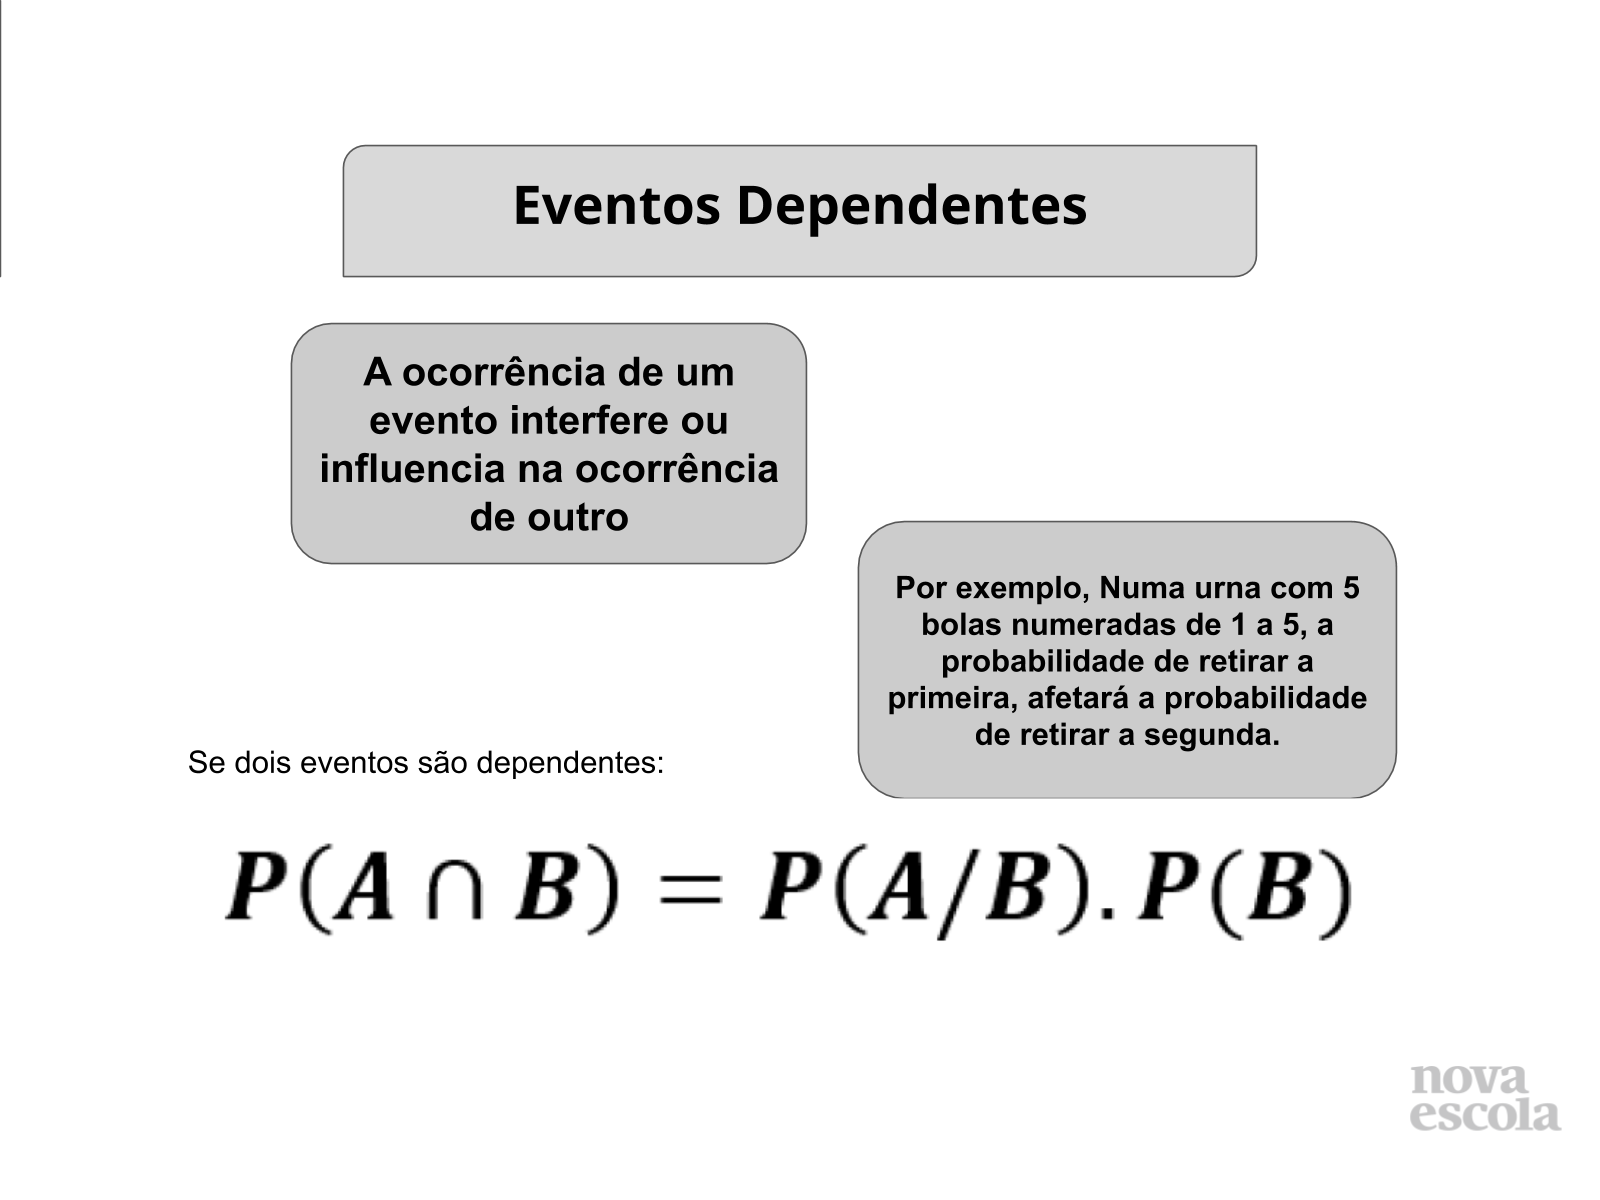
Muita gente aprende a diferença entre eventos dependentes e independentes decorando uma definição e pulando direto para os exercícios. O problema é que, na prática, identificar qual dos dois você está lidando é onde a maioria erra. Eu vi gente passar meia hora num problema achando que era independência, quando na verdade havia uma dependência oculta que mudava todo o resultado final. Dois eventos são independentes quando o resultado de um não altera a probabilidade do outro. Formalmente, isso significa que P(A|B) = P(A). Se você sabe que B aconteceu, nada muda na sua avaliação sobre A. Isso é tudo. Na prática, isso aparece quando os eventos operam em camadas completamente separadas — tipo lançar uma moeda e depois extrair uma carta de um baralho. Um não toca no outro. Eventos dependentes são o oposto. A ocorrência de um modifica a probabilidade do outro. O exemplo clássico é extrair cartas sem reposição. Se você tira um ás do baralho e não devolve, a probabilidade de tirar outro ás sobe de 4/52 para 4/51. Sim, a mudança é pequena, mas ela existe e todo cálculo que ignorar isso vai dar errado.
A forma mais segura de verificar se há dependência é olhar para a estrutura do experimento, não para os números. Pergunte-se: o espaço amostral do segundo evento é o mesmo do primeiro, ou mudou por causa do primeiro? Se mudou, você tem dependência. Se não mudou, é independência. Eu tenho um caso concreto que ilustra bem onde as pessoas tropeçam. Tinha um exercício em que pedia para calcular a probabilidade de tirar duas bolas vermelhas de uma urna com 5 vermelhas e 3 azuis, mas o enunciado não deixava claro se a primeira bola era ou não devolvida antes da segunda extração. A maioria dos alunos assumiu independência porque os números pareciam pequenos demais pra importar. O problema é que, sem reposição, a probabilidade real é (5/8) × (4/7) = 20/56 0,357. Assumindo independência, alguém faria (5/8) × (5/8) = 25/64 0,391. A diferença entre 35,7% e 39,1% parece boba até você ver a questão valer ponto numa prova e o gabarito ser o outro. Minha solução prática foi simples: sempre que o enunciado não especifica reposição, eu trato como sem reposição por padrão. Em estatística aplicada, a convenção natural é que extrações sucessivas de um mesmo conjunto alteram o conjunto. Se quisessem independência, tinham que escrever explicitamente "com reposição". Inverter essa lógica te protege de armadilhas.
Outro ponto que poucas pessoas mencionam: independência não significa ausência de relação causal. Dois eventos podem ser dependentes estatisticamente sem que um cause o outro. Por exemplo, a probabilidade de chover em São Paulo e a probabilidade de você levar guarda-chuva são dependentes — saber que levei guarda-chuva atualiza minha crença sobre se está chovendo — mas um não causa o outro diretamente. O que liga os dois é uma variável de confusão: o estado do tempo. Esse tipo de dependência condicional é frequente em modelos Bayesianos e costuma ser subestimado. Quando trabalhamos com probabilidades compostas, a regra do produto é o que separa os dois casos. Para eventos independentes, P(A e B) = P(A) × P(B). Para dependentes, P(A e B) = P(A) × P(B|A). A notação P(B|A) lê-se "probabilidade de B dado A", e é aqui que mora a diferença. Se você esquece o condicional, o cálculo já nasceu errado. Um erro muito comum é confundir eventos mutuamente exclusivos com eventos independentes. Mutuamente exclusivos significa que os dois não podem acontecer ao mesmo tempo — P(A e B) = 0. Independent means they can coexist and one doesn't affect the other. Se dois eventos têm probabilidade positiva e são mutuamente exclusivos, eles são necessariamente dependentes, porque saber que um aconteceu zera a probabilidade do outro. Essa contradição aparente gera confusão constante em salas de aula.

Na hora de implementar isso em código, a diferença também importa. Se você está simulando eventos independentes, basta gerar cada resultado de forma isolada. Para dependentes, precisa passar o estado atualizado de um para o próximo. Eu já perdi tempo debuggando simulações porque tratei uma sequência dependente como independente e o histograma de resultados nunca batia com a teoria. O fix foi adicionar um parâmetro de estado que era atualizado a cada iteração — custou dez minutos, mas a diferença entre um modelo funcional e um quebrado foi exatamente essa decisão. Se você quer ir além do básico, preste atenção em independência condicional. Às vezes dois eventos parecem dependentes quando olhados isoladamente, mas se tornam independentes quando você condiciona a uma terceira variável. Esse conceito é a base de redes bayesianas e modelagem causal, e entender ele te coloca à frente de muita gente que ainda está presa na definição de livro didático. A ideia é que P(A e B | C) = P(A | C) × P(B | C) para certo C, mesmo que P(A e B) P(A) × P(B). O limitante mais importante que precisa ficar claro: a suposição de independência é frequentemente errada em problemas reais. Modelos que tratam observações como independentes quando na verdade há correlação — seja por agrupamento, séries temporais ou variáveis latentes — produzem intervalos de confiança muito apertados e conclusões falsamente precisas. Em finanças, isso já causou modelos de risco que subestimaram drasticamente a probabilidade de crises porque assumiram independência entre ativos que na verdade se movem juntos em momentos de estresse. Se for aplicar isso fora do contexto acadêmico, teste a suposição antes de confiar no resultado.
Para quem tá começando e quer praticar, recomendo pegar problemas de livros como "Introduction to Probability" do Blitzstein e Hwang, que tratam o assunto com a profundidade certa sem enrolação. Também tem exercícios bons no OpenStax Statistics, gratuitos, focados em identificação prática de dependência versus independência.
Galeria
-
Canal da Educação Brasileira: Eventos dependentes e independentes na ... -

PROBABILIDADE DE EVENTOS DEPENDENTES E INDEPENDENTES - 9° ANO - YouTube -
Eventos Independentes: Definição, Fórmula E Exemplos – VKHVL -
Eventos dependentes - Planos de aula - 8º ano