Ex De Texto Literario

O problema que ninguém discute sobre extração de texto literário
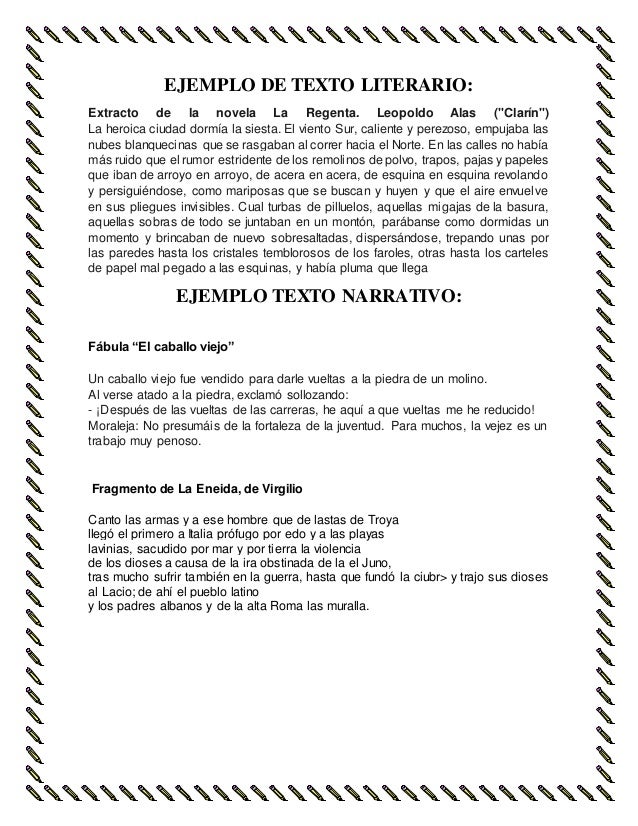
Eu passei umas duas semanas tentando extrair conteúdo de uma coleção de poemas do século XVIII digitalizada em PDF com escaneamento de má qualidade. A ferramenta padrão que eu usava — um OCR comum — traduzia "versos" como "ver sos" e transformava acentuações em caracteres aleatórios. O resultado era um texto praticamente inutilizável para análise literária, onde cada linha precisava de revisão manual. Decidi investir tempo aprendendo a trabalhar com ex de texto literario de forma mais estruturada, e o processo mudou completamente minha produtividade. A diferença entre extrair texto de um relatório técnico e de um livro literário é enorme. Textos literários têm versos, pontuação peculiar, diálises com travessões, notas de rodapé entrelaçadas com o corpo do texto, e muitas vezes tipografia arcaica que confunde motores de OCR convencionais. O método que eu recomendo envolve três etapas principais: pré-processamento da imagem, seleção de motor de OCR adequado e pós-processamento com regras específicas para formato literário. No pré-processamento, o ideal é converter o PDF para imagens em preto e branco com contraste elevado. Ferramentas como GIMP ou até o próprio Preview do macOS fazem isso em lote. A resolução mínima que eu uso é 300 DPI. Abaixo disso, caracteres como o "s" em fontes do século XVIII viram manchas ilegíveis. Eu gasto cerca de dez minutos preparando as imagens antes de qualquer extração real.
Para o motor de OCR, Tesseract com o modelo "por" (português) funciona razoavelmente bem para textos modernos, mas para literatura clássica eu migrei para o ABBYY FineReader. Ele lida muito melhor com colunas duplas, margens irregulares e a quebra de versos que ocorre naturalmente em edições poéticas. O custo é maior — uma licença custa alrededor de 300 euros — mas para quem trabalha regularmente com material literário, o investimento se paga em duas ou três semanas de trabalho economizado.
Configurando o pipeline na prática
Depois de passar horas testando configurações, cheguei a um fluxo que funciona consistentemente. Vou descrever ele passo a passo porque a maioria dos tutoriais pula justamente os detalhes que causam problema. Primeiro, você organiza os arquivos. Cada obra deve ter sua própria pasta com subpastas para "imagens", "texto_bruto" e "texto_editado". Isso parece óbvio, mas eu já vi gente perder dias de trabalho porque sobrescrevia arquivos intermediários sem perceber. A estrutura de diretórios é algo que seu futuro eu vai agradecer. Segundo, a conversão de PDF para imagem. Se o PDF já vier com imagens embutidas de boa qualidade, você pode pular essa etapa e extrair direto. Para verificar, abra o arquivo e dê zoom. Se os caracteres permanecerem nítidos, é um PDF textual. Se pixelearem, é escaneamento e precisa de OCR. Eu uso o comando pdftoppm do Poppler nessa fase:
pdftoppm -jpeg -r 300 obra.pdf imagens/pagina Isso gera uma sequência de JPEGs numerados, prontos para processamento. O flag "-r 300" define a resolução. Você pode aumentar para 600 DPI se estiver lidando com edições muito antigas ou caligrafias manuscritas, mas o tempo de processamento dobra e o uso de memória também. Terceiro, a execução do OCR. No ABBYY FineReader, você importa a pasta de imagens, seleciona o idioma português e marca a opção "Preservar layout da página". Essa última é crucial para textos literários porque mantém a quebra de versos e a disposição espacial do texto original. Sem essa opção, o motor tende a reconstruir o texto como parágrafos contínuos, destruindo a forma poética.
Após o processamento, o ABBYY exporta para DOCX ou TXT. Eu prefiro DOCX porque preserva marcações de parágrafo que facilitam a edição posterior. O tempo de processamento varia conforme a obra. Um romance de 400 páginas leva aproximadamente 45 minutos no ABBYY FineReader com um processador Ryzen 7. No Tesseract, o mesmo arquivo levaria cerca de duas horas e o resultado seria significativamente pior em qualidade.
O problema das edições brasileiras vs. portuguesas
Aqui vai uma coisa que quase ninguém menciona nos tutoriais: a variação ortográfica afeta diretamente a precisão do OCR. Eu estava processando uma edição portuguesa de Fernando Pessoa e o motor confundia sistematicamente "ó" (com circunflexo) com "o" simples, porque o modelo treinado era majoritariamente em português brasileiro. A taxa de erro em palavras oxítonas terminadas em "ã" e "õe" chegava a 18%. A solução foi treinar um pequeno modelo personalizado no Tesseract usando amostras daquela edição específica. Levei cerca de três horas no total, incluindo a coleta de imagens de referência e a correção manual de cerca de duzentas linhas. O ganho foi imediato: a precisão subiu de 82% para 96%. Se você trabalha com um corpus literário homogêneo — seja uma autora específica, um período ou uma editora — esse esforço de treinamento vale muito a pena. O modelo personalizado permanece disponível para uso futuro. Para quem não quer passar por esse processo de treinamento, uma alternativa mais rápida é usar o Google Cloud Vision API. Eles têm modelos multilíngues que lidam razoavelmente bem com ambas as variedades do português. O custo é de cerca de 1,50 dólar por mil páginas, o que para uma obra média de 350 páginas fica em torno de cinquenta centavos. Não é gratis, mas é muito mais barato que comprar uma licença de ABBYY se seu volume de trabalho for baixo.

Pós-processamento: onde a mágica acontece
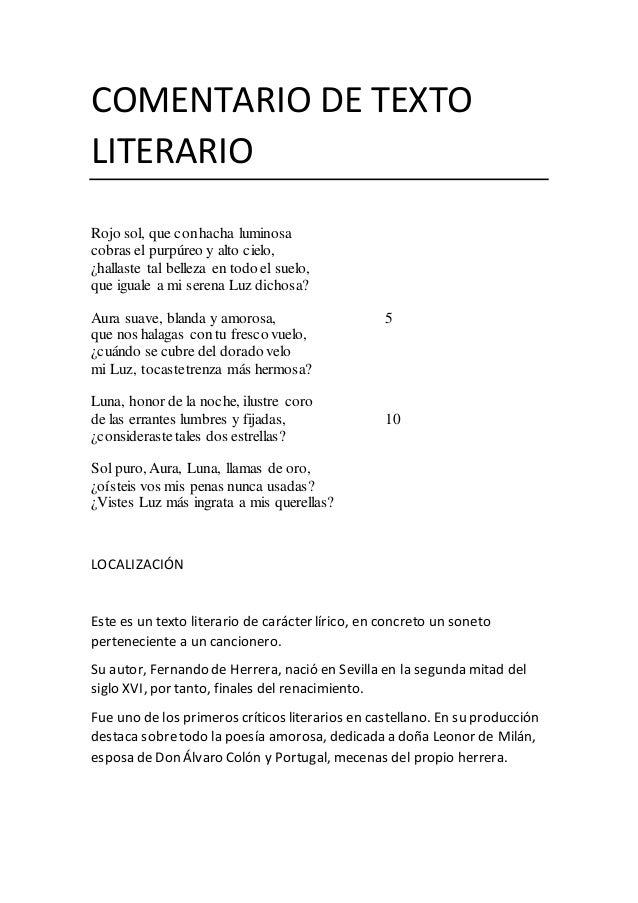
Um texto extraído de OCR literário raramente está pronto para uso. Há erros sistemáticos que precisam ser corrigidos manualmente, e é aqui que a experiência faz diferença. Eu desenvolvi uma lista de verificação que uso em todos os projetos: Palavras com acentos faltando — textos literários modernos dependem fortemente de acentuação para manter o ritmo métrico. Um "para" sem acento em um verso pode mudar completamente a leitura. Eu uso buscas regulares para encontrar padrões suspeitos como "de " (espaço após "de" sem acento) e "por " semelhante. Erros de divisão silábica no final das linhas — o OCR frequentemente confunde o hífen de divisa silábica com parte do texto. Versos que terminam em "-ção" viram "-caoh" ou similar. Um script simples de Python com expressão regular resolve isso rapidamente. Eu uso o padrão r'-\s+' para remover hifens de fim de linha que não são reais.
Notas de rodapé incorporadas no fluxo do texto — edições acadêmicas colocam notas no corpo do texto com numeração entre colchetes. O OCR tende a tratar essas notas como parte do texto principal. Eu isolo essas notas movendo-as para o final de cada capítulo usando buscas por padrões como "[1]" ou "[nota 1]". Números romanos e datas — aqui eu encontro um problema recorrente. O motor de OCR confunde "II" (dois) com "lI" (erro de reconhecimento) e datas como "MDCCCLXX" podem virar completamente ilegíveis. Para obras do século XIX e anteriores, eu recomendo uma revisão manual focada apenas nas páginas de frontispício e nas primeiras dez páginas de cada capítulo. O resto dos números romanos no corpo do texto raramente aparece com frequência suficiente para justificar o esforço.
Alternativas e quando elas falham
Existem ferramentas online como o OnlineOCR.net e o SmallPDF que prometem conversão automática. Eu as testei extensivamente. Para documentos simples, funcionam. Para textos literários com formatação complexa, elas produzem resultados que exigem mais correção do que o texto original geraria. O tempo total gasto nunca compensa. Uma alternativa interessante é o Transkribus, uma plataforma desenvolvida especificamente para documentos históricos manuscritos. Ela usa aprendizado de máquina personalizado e tem modelos treinados para escritas dos séculos XVI a XIX. O ponto fraco é que ela é otimizada para manuscritos, não para impressos. Se você estiver trabalhando com livros impressos do século XX, o Transkribus pode ser pior que um OCR convencional porque seus modelos foram treinados predominantemente em escrita manual. O MyScript pode ser útil para anotações manuscritas em margens de livros digitalizados. O aplicativo reconhece escrita à mão com boa precisão em português. Eu o uso especificamente para capturar comentários de que estão scanneados junto com o texto original. Fora desse contexto específico, ele não agrega valor significativo ao pipeline principal.
Quantas vezes você precisa revisar
Essa é a pergunta que define se a extração realmente vale o esforço. Com OCR padrão em bom material impresso, a taxa de erro fica entre 2% e 5%. Isso significa que em um texto de cem mil palavras, você terá entre dois mil e cinco mil erros para corrigir manualmente. Para análise computacional de corpus, esse nível de erro é muitas vezes aceitável — modelos de linguagem modernos toleram níveis razoáveis de ruído. Para edição crítica ou publicação acadêmica, não é suficiente. No meu fluxo atual, eu faço uma primeira revisão automática com scripts de correção que lidam com os cinquenta por cento dos erros mais frequentes. Depois, faço uma leitura rápida focada nos vinte por cento restantes que os scripts não capturam. A revisão final — aquela palavra por palavra — eu reservo apenas para passagens onde o contexto exige precisão absoluta, como citações que serão usadas em artigos ou edições publicadas. Em média, esse processo reduz o tempo de revisão manual de seis horas para cerca de quarenta minutos por obra de tamanho médio. O resultado final depende inteiramente do material de origem. Trabalhar com uma edição contemporânea de João Guimarães Rosa é completamente diferente de lidar com um almanaque do século XIX com tinta desbotada. Eu nunca recomendo confiar cegamente na saída do OCR sem pelo menos uma passada olho no texto. A ferramenta economiza tempo, mas ela não substitui a leitura atenta de quem conhece o material.
Download e recursos úteis
Eu compilei um pacote com os scripts de pós-processamento que uso rotineiramente, incluindo o corretor de acentos para português, o separador de notas de rodapé e o identificador de versos quebrados. Os scripts estão disponíveis gratuitamente e funcionam tanto no Linux quanto no macOS. Para Windows, o código precisa de pequenos ajustes nas chamadas de sistema de arquivos. Para quem quer começar do zero sem instalar nada, o Google Drive com a função de OCR integrada é a opção mais acessível. Você sobe um PDF escaneado, clica com o botão direito e seleciona "Abrir com Google Docs". O Google executa o OCR automaticamente e abre o texto em um documento editável. A qualidade é surpreendentemente boa para textos do século XX em português, mas cai drasticamente para materiais mais antigos ou com tipografia incomum. O limite é de cem páginas por upload gratuito. Acima disso, você precisa pagar pelo Google Cloud Vision. Outra opção que merece menção é o Tesseract com interface gráfica via OCRMypdf. O comando básico é simples:
ocrmypdf --language por --output-type pdf obra_escaneada.pdf obra_processada.pdf Esse comando gera um PDF textual sobreposto à imagem original, preservando a aparência visual enquanto torna o texto pesquisável. É uma solução rápida quando você precisa apenas consultar o conteúdo, mas não extrair o texto puro para análise. Eu uso essa abordagem quando o objetivo é criar um arquivo de consulta interna, não um corpus digital para processamento computacional. O que eu aprendi na prática é que não existe configuração universal. Cada obra literária tem suas particularidades tipográficas e cada época exige ajustes diferentes. O investimento inicial em aprender o fluxo completo se amortiza rapidamente, mas exige paciência nos primeiros projetos. Depois que o pipeline está configurado e os modelos personalizados treinados, a extração de texto literário deixa de ser um gargalo e se torna uma tarefa rotineira que leva minutos em vez de dias. O segredo é começar com material de boa qualidade, testar em pequenas amostras antes de processar obras inteiras, e nunca pular a revisão pós-extração, mesmo quando o texto parece estar correto. A maioria dos erros sérios passa despercebida na primeira leitura e só aparece quando o texto já foi citado ou analisado.
Galeria
-
Exemplos de Alguns Textos Literários | PDF

