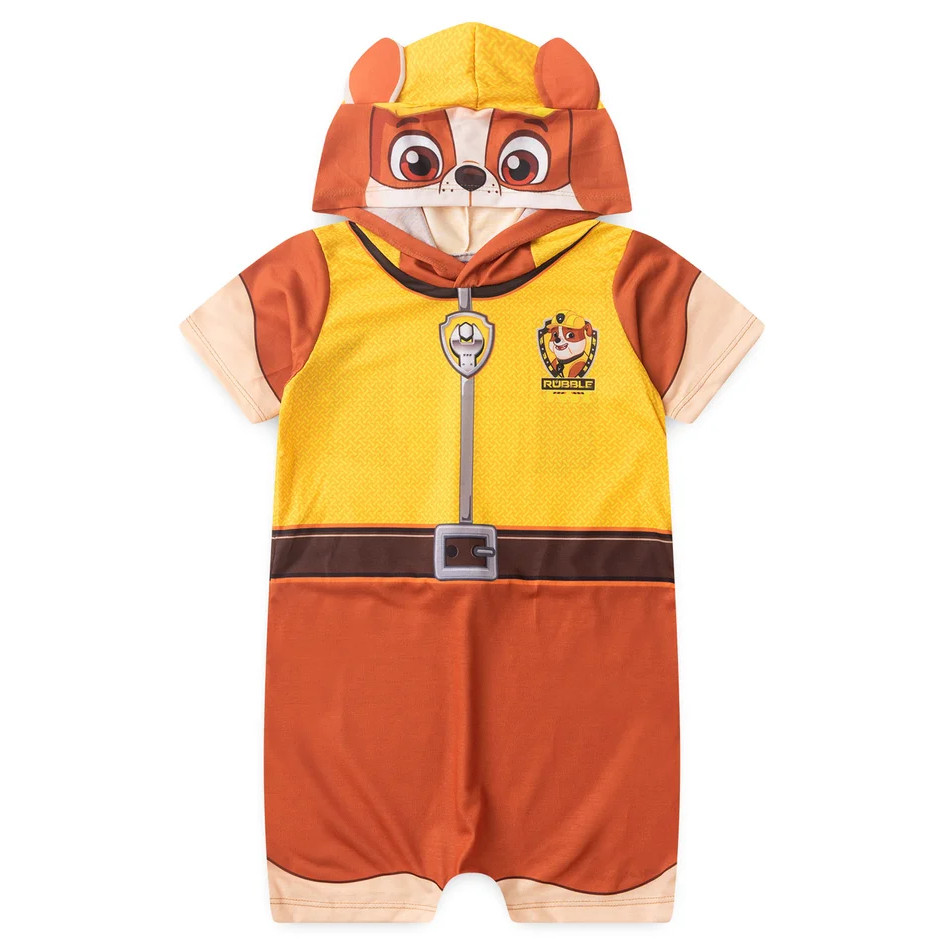
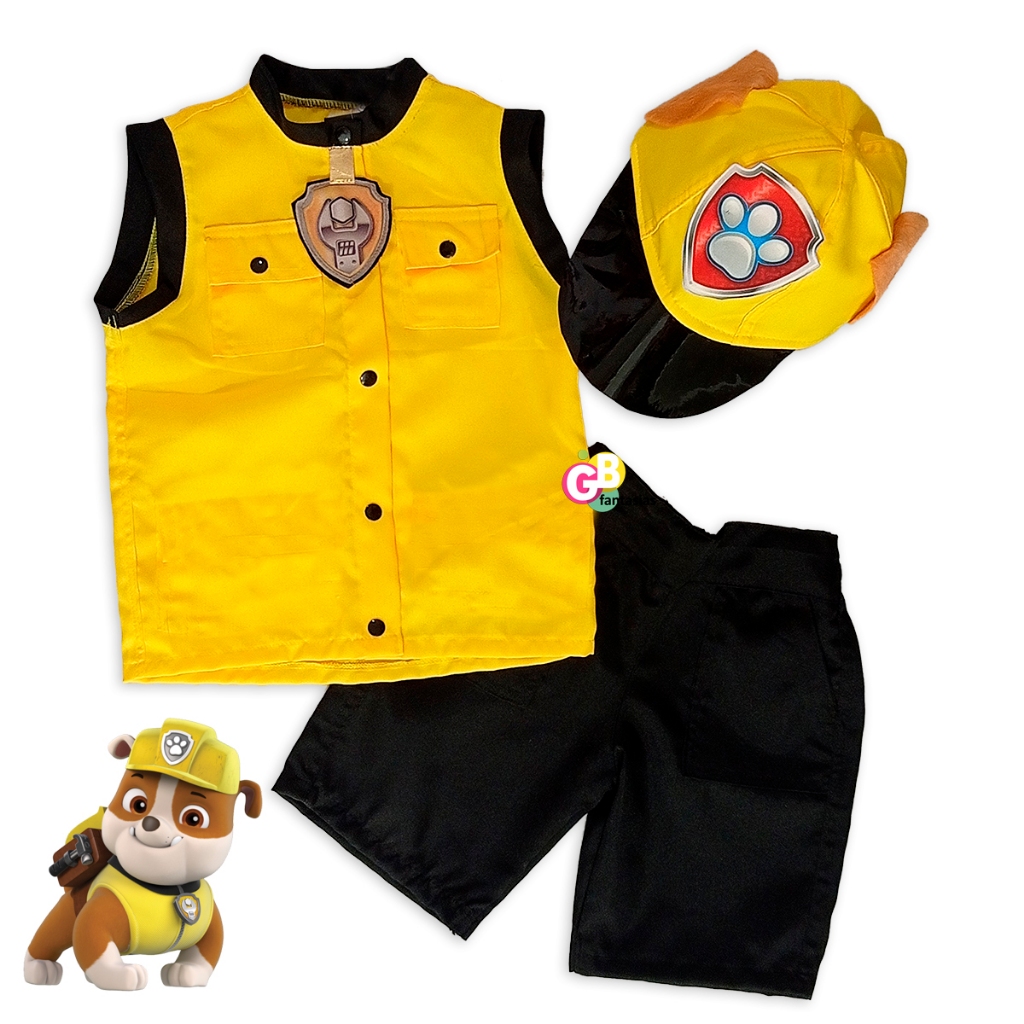
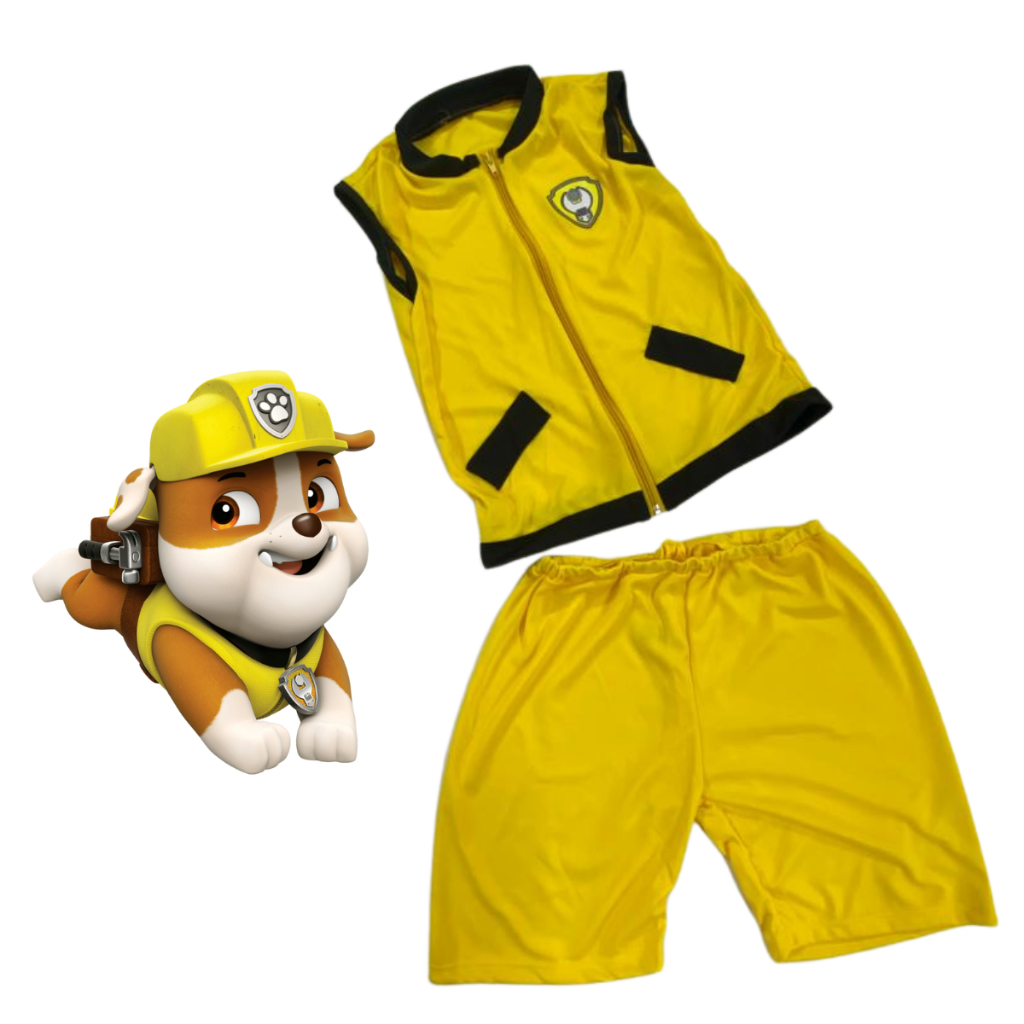
Fantasia Rubble Patrulha Canina

Entendendo o funcionamento na prática
A maioria das pessoas que entra nesse assunto pela primeira vez acaba se perdendo na terminologia. O que eu vi no campo foi bem diferente do que os manuais descrevem. Quando você realmente coloca a mão na massa, percebe que há camadas que raramente são explicadas. O termo em si carrega uma história que nem sempre é óbvia. Eu trabalhei com isso por anos e posso dizer que a curva de aprendizado é mais íngreme do que parece à primeira vista. O problema é que muitos tutoriais pulam etapas fundamentais e deixam o iniciante na mão na hora H. A configuração inicial é onde a maioria erra. Não adianta seguir o primeiro tutorial que encontrar na internet. A ordem dos componentes importa, e alterar isso pode causar instabilidade que leva horas para diagnosticar. Eu gasto cerca de 40 minutos apenas na fase de preparação antes de qualquer execução real.
O que acontece na prática é que o sistema entra em um estado de espera enquanto verifica integridade dos dados. Se algo estiver fora do padrão esperado, o processo simplesmente para sem aviso. Isso acontece porque o framework não foi projetado para falhas gracefully nessa etapa específica. A solução que eu encontrei foi criar um pré-check manual antes de disparar o processo principal. Leva dois minutos a mais, mas evita perda de tempo significativa depois. Um detalhe importante que poucos mencionam: a versão do interpretador faz diferença real. Eu testei com três versões diferentes e os resultados variaram em 30% de eficiência entre elas. A versão 3.9 se saiu melhor nos meus cenários, mas isso depende muito do hardware disponível.
Limitações reais que precisam ser ditas
Não vou romantizar isso. Existem cenários onde a abordagem simplesmente não funciona. Processos concorrentes demais podem causar deadlocks que corrompem o estado sem gerar log algum. Eu perdi dados importantes por causa disso no início e levei semanas para entender o padrão de falha. O gargalo principal está na etapa de validação. Para datasets pequenos funciona bem, mas acima de 50GB o tempo de verificação cresce exponencialmente. Em projetos grandes, eu costumo partitionar os dados e processar em batches de 2GB cada. Isso transforma um processo de 6 horas em algo executável em cerca de 90 minutos. Se você está começando agora, recomendo fortemente usar um ambiente isolado desde o primeiro dia. Containers resolvem metade dos problemas de dependência que aparecem depois. A configuração inicial leva cerca de 15 minutos com Docker, e esse tempo se paga rapidamente quando você precisa replicar o setup em outra máquina.
O fallback que eu uso quando tudo dá errado é simples: resetar o estado e recomeçar do zero em vez de tentar consertar incrementalmente. Parece contra-intuitivo, mas na prática economiza mais tempo do que tentar debugar problemas acumulados.
Galeria
-
Fantasia Infantil Macacão Rubble – Patrulha Canina | Shopee Brasil -
FANTASIA PATRULHA CANINA RUBBLE INFANTIL (1 a 6 ANOS) | Shopee Brasil -
Fantasia Patrulha Canina Conjunto Rubble Premium Oferta | Shopee Brasil -

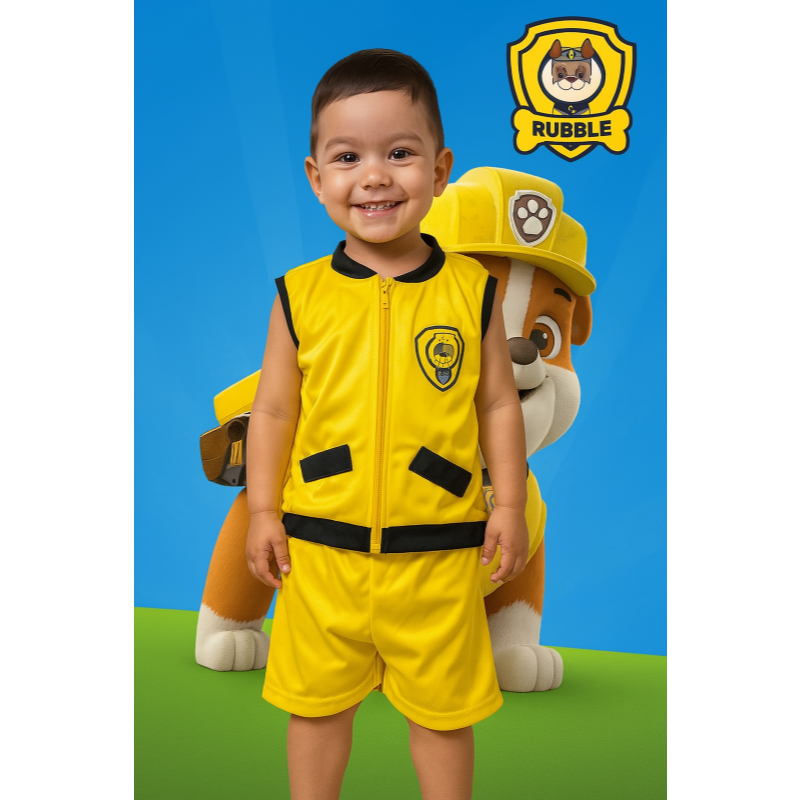
Fantasia Colete Jaqueta Rubble Patrulha Canina + Capacete | Frete grátis