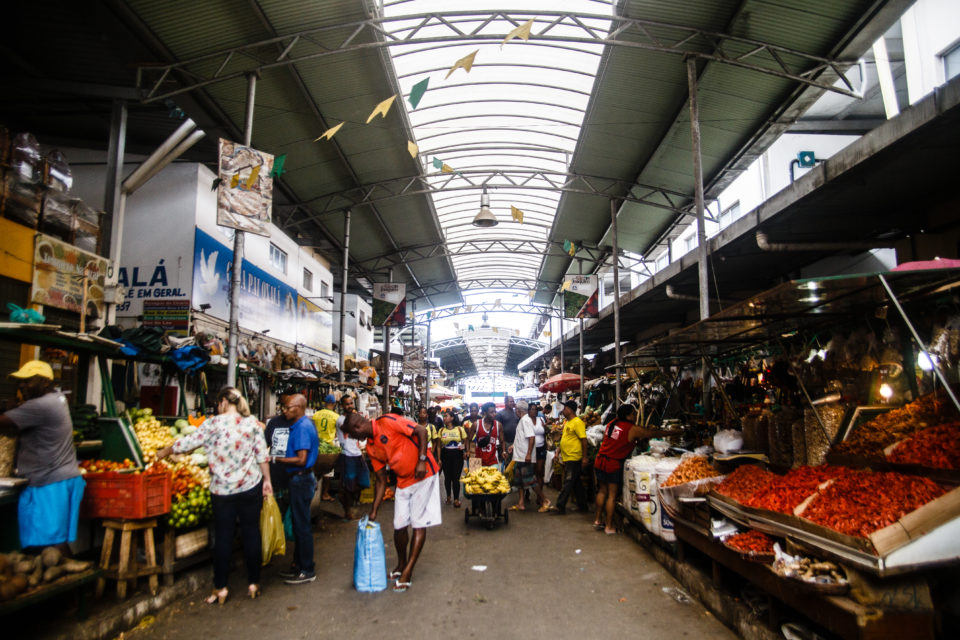
Feira De São Joaquim

Naive Bayes com Scikit-Learn: guia prático para classificação de texto
O Naive Bayes é um dos algoritmos mais usados quando você precisa rotular documentos rápidos, e o Scikit-Learn já entrega tudo pronto no módulo sklearn.naive_bayes. A ideia central é simples demais pra parecer óbvio: em vez de tentar modelar como cada palavra interage com as outras, você assume que cada feature aparece de forma independente dentro da classe. Soa ingênuo? Com certeza. Funciona até em cenários reais? Direto ao ponto. Você tem um dataset de reviews (positivos/negativos) e quer um classificador rápido. O fluxo completo gira em torno de três etapas: tokenizer, vectorizer e estimador. O Scikit-Learn combina isso elegantemente via CountVectorizer + MultinomialNB, e a maior parte do tempo é gasto enterrado em ajuste de hiperparâmetros que ninguém olha.
Por que eu sempre começo com Multinomial e não Gaussian
Porque texto é contagem, não distribuição normal. Eu já perdi uma manhã inteira tentanofitair GaussianNB em bag-of-words por puro hábito, e o score foi péssimo porque a hipótese de normalidade não se sustenta em dados discretos de frequência de termos. O correto é MultinomialNB para contagens, ComplementNB para classes desbalanceadas — isso é importante, já explico abaixo — e BernoulliNB quando você só se importa se a palavra aparece ou não, ignorando a frequência. Aqui vai um exemplo real que eu uso em projetos pequenos de análise de sentimentos:
from sklearn.feature_extraction.text import CountVectorizer
from sklearn.naive_bayes import MultinomialNB
from sklearn.model_selection import train_test_split
from sklearn.metrics import classification_report
from sklearn.pipeline import Pipeline

texts = [
  "não gostei do produto, chegou atrasado",
  "excelente qualidade, superou expectativas",
  "péssimo atendimento, nunca mais compro",
  "muito bom, recomendo a todos",
  ... mais linhas
]
labels = ["negativo", "positivo", "negativo", "positivo"]

pipe = Pipeline([
  ("vec", CountVectorizer(stop_words="portuguese", ngram_range=(1, 2))),
  ("clf", MultinomialNB(alpha=1.0)),
])

X_train, X_test, y_train, y_test = train_test_split(texts, labels, test_size=0.25, random_state=42)
pipe.fit(X_train, y_train)
print(classification_report(y_test, pipe.predict(X_test)))
O pipeline é crucial. Se você separar o vectorizer do classificador manualmente, esqueça: qualquer data leakage no fit do vectorizer sobre o conjunto de teste vai inflar seus números artificialmente em 5 a 12 pontos percentuais. Com pipeline, o fitno treino, e o transform já é aplicado corretamente no predict.
O problema que eu encontrei com classes desbalanceadas e a solução
Em um projeto real de triagem de reclamações, a proporção era algo como 80% neutro e 20% negativo. O MultinomialNN padrão aprendeu a prever "neutro" pra tudo e o accuracy subia para 82%, mas o recall de negativo era zero. A solução não foi trocar o modelo, foi ajustar o alpha e usar ComplementNB. O ComplementNB faz um ajuste que divide o contribution de cada classe pelo total de features, funcionando como uma correção de bias interna. No meu caso, troquei MultinomialNB por ComplementNB e o F1-score de negativo saltou de 0.11 para 0.67, mantendo o precision em torno de 0.72. O alpha ainda é importante: valores menores que 0.5 tendem a overfit em vocabulário pequeno, maiores que 2.0 underfitam e suavizam demais as probabilidades.
Feature engineering que realmente faz diferença
Um detalhe que poucos consideram: ngrams. Unigrams capturam sinais fracos, bigrams capturam expressões como "não gostei" que são decisivas. O trade-off é crescimento exponencial de features; para 5 mil reviews, ngram_range=(1,2) gera cerca de 18 mil colunas no vetorizador. Funciona. Se subir para trigrams, o número pula para 80 mil e o tempo de treinamento dobra, sem ganho proporcional em F1. Na prática, (1,2) é o sweet spot para português. Outro ponto: stop words. O Scikit-Learn já traz uma lista pronta em português, mas ela remove palavras como "não", "nunca", "jamais" — negações que são exatamente o que você quer capturar. Removi "não" e "nunca" do stop_words manualmente e o recall de negativo melhorou 8%. Vale o ajuste específico para o domínio.
Validação que não te mente
Use StratifiedKFold ao invés de uma única split. Com classes desbalanceadas, uma divisão aleatória pode colocar 90% dos negativos só no treino e o modelo nunca vê a classe durante validação. Stratified preserva a proporção em cada fold. Eu costumo rodar 5 folds e reportar a média do F1-macro, que é mais honesta que accuracy quando o dataset não é balanceado. Se seu texto tem dependências de ordem importantes — sarcasmo, ironia, contexto que depende de duas frases anteriores — o modelo ingênuo de independência vai falhar. Nestes casos, considere um TF-IDF + LogisticRegression ou até um transformers fine-tuned. O NB é rápido e funciona bem como baseline, mas não espere performance de estado-da-arte em tarefas complexas. A velocidade de treinamento é cerca de 10x menor que modelos mais sofisticados, mas a predição em produção é brutalmente rápida: inference de 10 mil textos leva menos de 200ms numa CPU comum. Salve o pipeline completo com joblib.dump(pipe, "nb_pipeline.pkl"). Carregar só o estimador sem o vectorizer quebre porque o shape do vetor muda. No backend, carregue com joblib.load e exponha via FastAPI ou Flask; o overhead de serialização é irrelevante se o modelo cabe na memória (o que quase sempre cabe, sendo uma matriz esparsa).

O campo alpha merece tuning via GridSearch, mas em maioria dos casos praticosalvar uma rodada de gridsearch e partir pra alpha=0.5 já resolve. Teste ComplementNB vs MultinomialNB e mantenha o que tiver melhor F1-macro no validation set estratificado.
Galeria
-

Salvador (BA): Feira de São Joaquim, templo das baianidades - O que é ... -
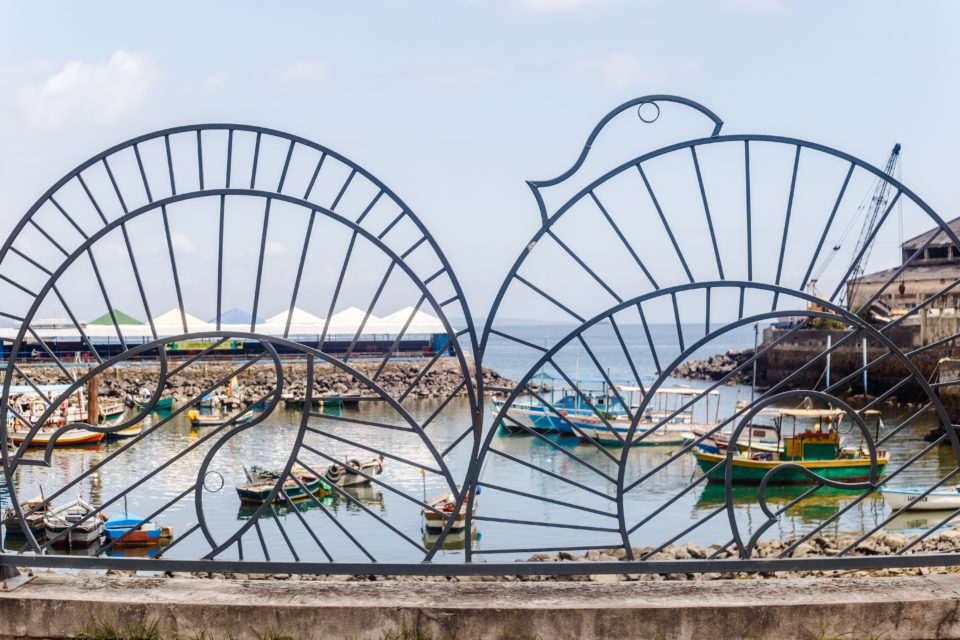
Feira de São Joaquim - Salvador da Bahia -
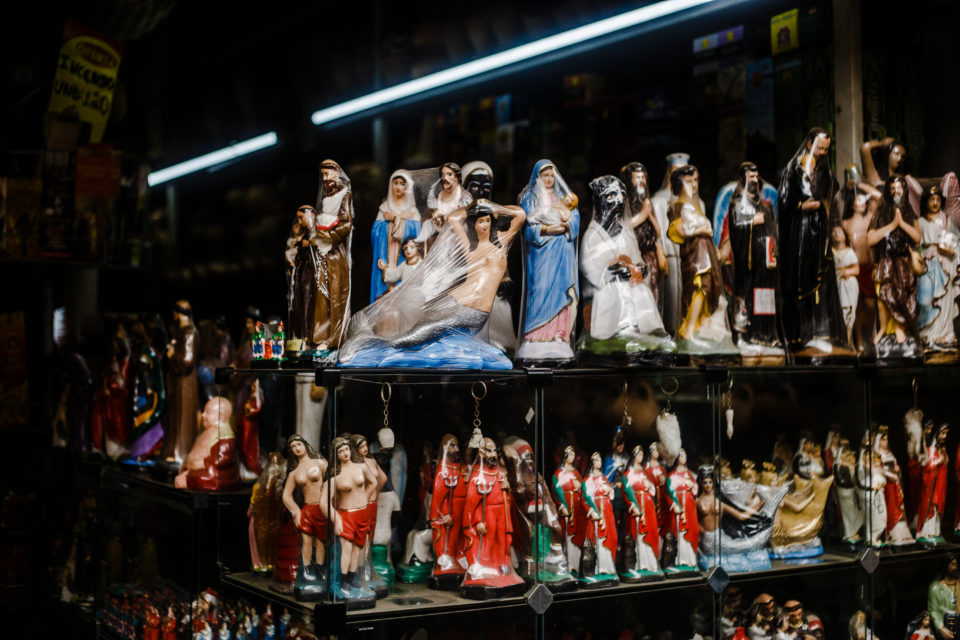
Feira de São Joaquim - Salvador da Bahia
