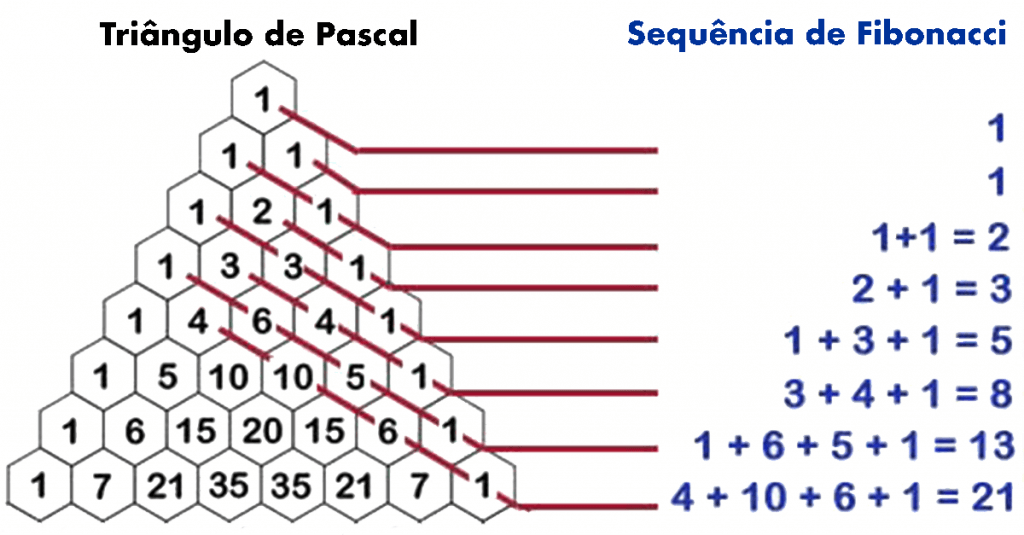
O primeiro erro que todo mundo comete é tentar calcular os termos manualmente até chegar num número razoável. A sequência começa em 0 e 1, cada termo seguinte é a soma dos dois anteriores. Ponto. Mas isso é só a definição de livro didático, e quem precisa disso pra valer logo percebe que a coisa desanda rápido. O décimo quinto termo já passa de setecentos, e o quinquagésimo tem mais de doze dígitos. Fazer isso de cabeça é convite pro esquecimento e pra dor de cabeça. fibonacci sequencia em Python é uma questão de três linhas se você usar recursão com memoização ou um loop simples. A versão recursiva pura é bonita pra mostrar num quadro negro, mas é uma armadilha prática. Sem memoização, calcular o vigésimo termo já exige mais de mil chamadas de função, e o trigésimo entra na casa das centenas de milhares. O tempo de execução cresce exponencialmente, então se você tem um deadline, esquece. A abordagem iterativa resolve isso em tempo linear e memória constante. Você guarda apenas os dois últimos valores e sobe a escada. Aqui vai um exemplo bem direto que uso nos meus scripts:
def fib(n):
if n
= 0:
return []
elif n == 1:
return [0]
seq = [0, 1]
for _ in range(2, n):
seq.append(seq[-1] + seq[-2])
return seq
Isso retorna a lista completa até o enésimo termo. Se você só precisa do valor isolado, não guarda o array inteiro e economiza memória. Troca o list append por duas variáveis e o consumo de RAM cai de O(n) para O(1). Pequeno ajuste, diferença significativa quando roda isso em batch. Tive um problema recente num projeto de criptografia onde precisei gerar números da sequência até a posição 10.000. A versão iterativa normal funcionou, mas na hora de testar performance, percebi que para posições muito altas, o custo de adicionar elementos grandes na memória começa a pesar. A solução foi usar um gerador, yieldando cada termo conforme preciso, sem jamais guardar tudo num array. Pra quem trabalha com números grandes frequentemente, isso faz uma diferença real. O Python lida com inteiros de precisão arbitrária nativamente, então não há overflow como em C ou Java, mas o custo de alocação de objetos ainda existe. Outro ponto que poucos mencionam: a relação com a razão áurea. Divida fib(n) por fib(n-1) e você se aproxima de phi, cerca de 1.6180339887... Isso vale pra qualquer n razoavelmente grande, mas cuidado ao usar essa aproximação pra cálculos numéricos sensíveis. Floats de dupla precisão começam a errar a partir do termo 70 ou 71, e depois disso o resultado numérico se afasta do valor exato. Se você precisa da precisão, use inteiros e só converta pra float no final, se for realmente necessário.
Vantagens e limitações reais
O gerador é mais eficiente que a lista completa em termos de memória, mas um pouco mais lento em iteração única porque o Python precisa retomar o frame a cada yield. Para gerar dez mil termos de uma vez sem guardar nada, isso é irrelevante. Para gerar bilhões de termos em pipeline, a diferença se torna mensurável. Nada gratuito. Existe também o método de Binet, a fórmula fechada que usa potências de phi. Na teoria, calcula o enésimo termo diretamente. Na prática, erros de arredondamento de ponto flutuante a tornam imprecisa acima do termo 70 em double precision. Há contornos com decimais de maior precisão usando bibliotecas como mpmath, mas aí você troca precisão por velocidade. É um trade-off real, não uma dica de marketing. Se você precisa de um termo específico muito distante, sem gerar os intermediários, o método de exponenciação de matriz é o caminho. Representa a relação de recorrência como uma matriz 2x2 e eleva ela à potência n em tempo logarítmico. Isso reduz o custo de O(n) para O(log n), o que é uma diferença brutal para n na casa dos milhões. A desvantagem é que a implementação é mais trabalhosa e o overhead de multiplicação de matrizes com inteiros grandes pode compensar para valores pequenos de n. Funciona bem a partir de n = 100.000 ou mais, dependendo do hardware.
Sequencia De Fibonacci Em Frutas Sequência De Fibonacci: Um Pouco
Há ainda casos onde a sequência de Fibonacci aparece em contextos inesperados. Algoritmos de busca com dicionários balanceados, análise de pior caso de certain sorts, e até na modelagem de populações (a versão original do problema de Fibonacci era sobre coelhos, sim). Não é só um exercício acadêmico. Mas o uso mais comum hoje em dia é como benchmark de performance de linguagens e estruturas, ou em problemas de otimização onde a propriedade de subestrutura ótima se aplica. Se o seu objetivo é apenas consultar termos famosos ou usar em geração de valores pseudoaleatórios, um array pré-computado fixo serve. Gerar uma tabela de 1.000 termos leva menos de dois segundos na maioria das máquinas modernas e ocupa unos dois megabytes. Se precisar de mais, pense em compressão ou em cálculo sob demanda. Não adianta ter tudo pronto na memória se você só acessa dez por cento dos valores. O download de bibliotecas prontas como a do SymPy ou NumPy pode parecer conveniente, mas para algo tão simples quanto Fibonacci, embutir a lógica no código evita dependências desnecessárias. A Sobrecarga de importar uma biblioteca inteira pra cinco linhas de função é um gasto que só se justifica se você já precisa daquela biblioteca por outros motivos. Senão, escreva as cinco linhas.
Resumo sem resumo
Use loop iterativo para a maioria dos casos. Troque por gerador quando a memória importa. Parta para exponenciação de matriz quando n ultrapassa centenas de milhares. Evite a fórmula de Binet para precisão exata. E não se assuste com a escalada rápida dos valores, ela é parte do que torna a sequência interessante.
Galeria
Sequencia De Fibonacci Corpo Humano
Sequencia De Fibonacci Em Flores 6.600+ Sequência De Fibonacci Fotos
Sequencia De Fibonacci Em Design
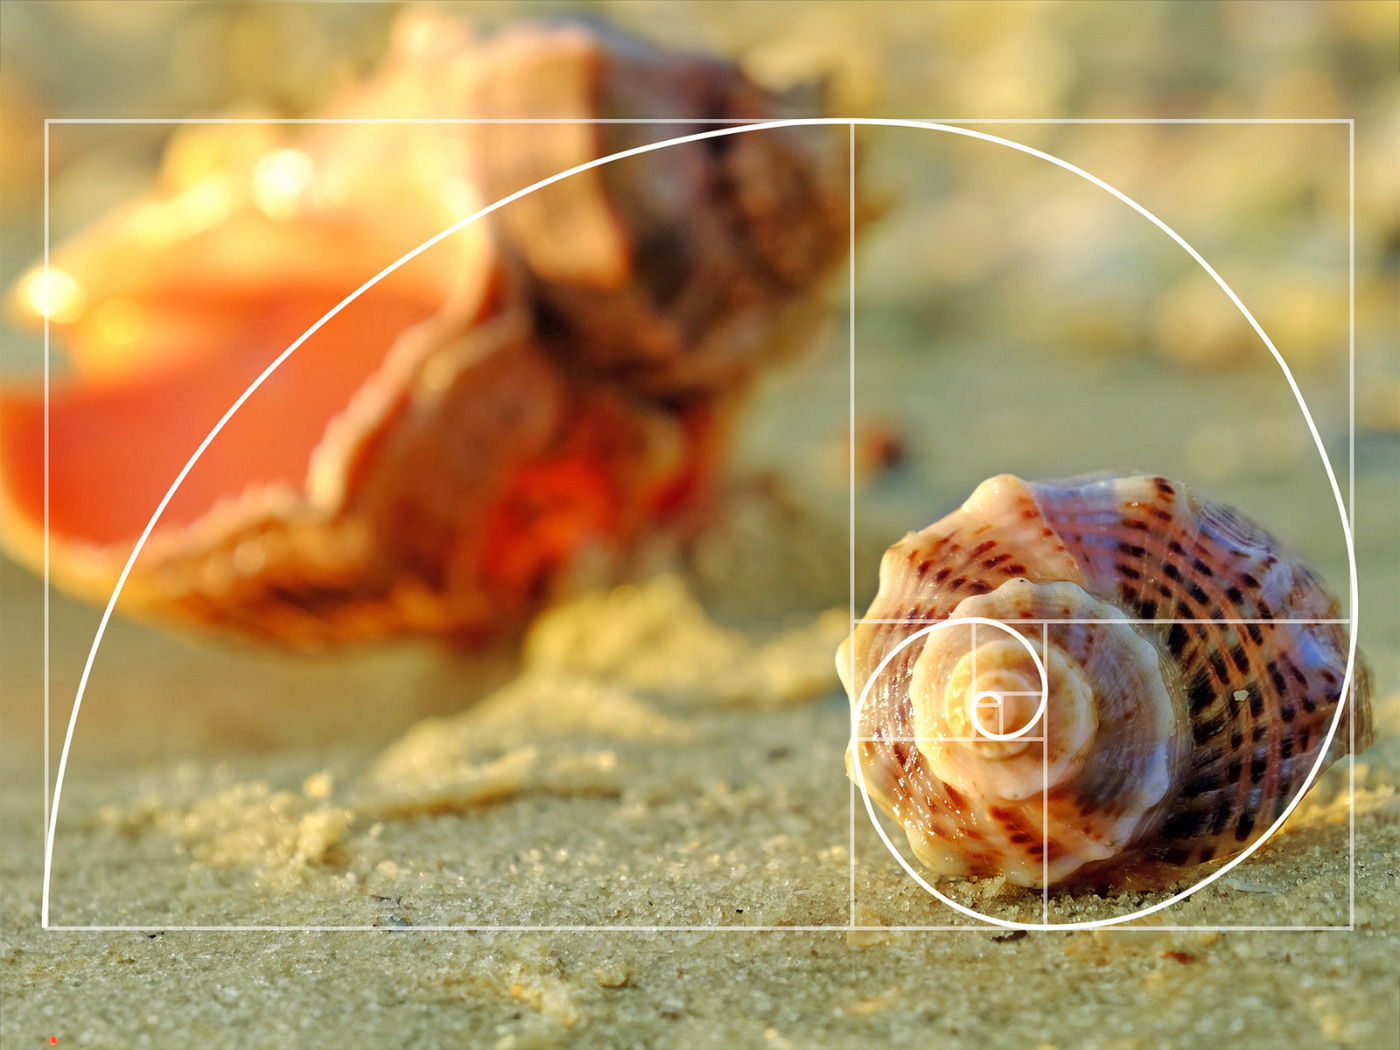
Sequencia De Fibonacci Em Conchas Os Coelhos Do Matemático Fibonacci