Formula Desvio Padrão Amostral
Calculando o desvio padrão amostral na prática
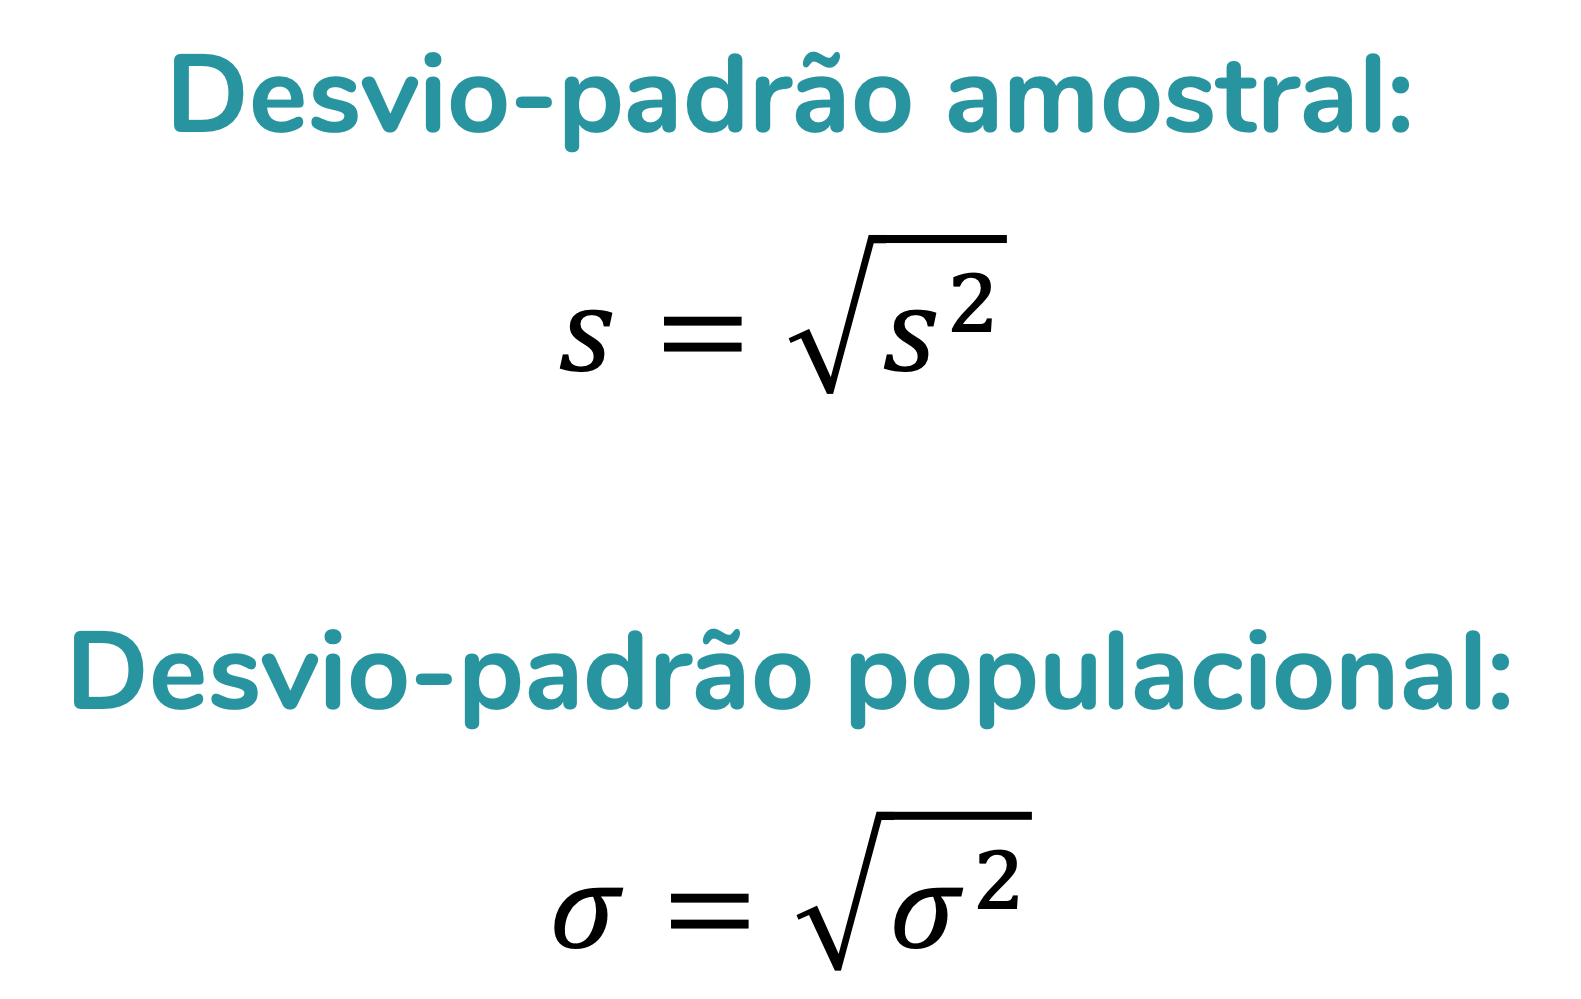
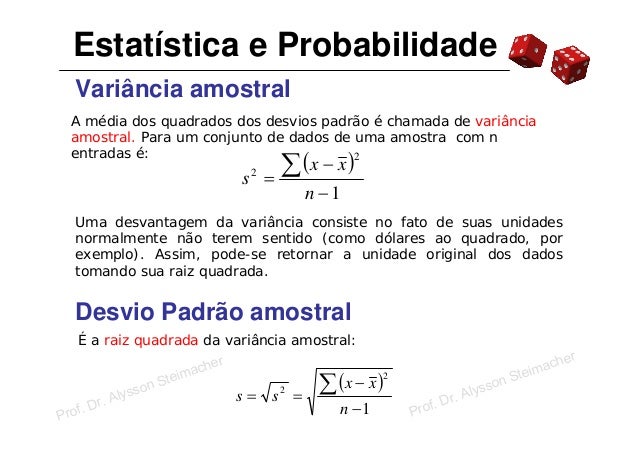
A fórmula desvio padrão amostral é S dividido por n menos um, onde S é o desvio padrão populacional. Na prática, isso significa que você pega a soma dos quadrados das diferenças entre cada observação e a média amostral, divide por n-1 e depois extrai a raiz quadrada do resultado. O n-1 existe porque estamos estimando a variabilidade de uma população inteira a partir de apenas uma amostra, e ele corrige o viés da estimativa. Se você usar n no denominador em vez de n-1, seu resultado vai tender sistematicamente para baixo, especialmente com amostras pequenas. Eu trabalho com dados de produção industrial desde 2014. No início, sempre cometia o erro de confundir o desvio padrão amostral com o populacional. Foi só quando precisei reportar desvios para um cliente que estava auditando meus processos que percebi a diferença. O cliente pediu a fórmula desvio padrão amostral e eu tinha calculado tudo com n no denominador. O resultado estava cerca de 8% abaixo do correto para uma amostra de 12 observações. Eu precisei recalculair tudo do zero e ainda pedir desculpas para o gestor da auditoria. Desde então, sempre meço duas vezes antes de dividir por n-1.
Qual a diferença entre e S? Uma resposta direta
O símbolo sigma () representa o desvio padrão populacional. É o verdadeiro desvio de toda a população que você está estudando. O S maiúsculo representa o desvio padrão amostral, que é uma estimativa baseada em dados limitados. Quando você tem acesso a todos os dados da população — por exemplo, a medição completa de todas as peças produzidas em uma linha durante um turno inteiro — você usa a fórmula com n. Quando você só tem uma amostra, usa n-1. Isso é a correção de Bessel. A correção de Bessel tem um comportamento interessante. Para amostras grandes, o efeito de dividir por n-1 em vez de n se torna insignificante. Com n igual a 30, a diferença entre as duas fórmulas é menor que 2%. Com n igual a 100, a diferença cai para menos de 1%. Por isso muitos manuais mais antigos ou cursos introdutórios simplesmente ignoram a correção e usam n mesmo para amostras. É tecnicamente errado, mas na prática o erro é pequeno o suficiente para não causar problemas graves em muitos contextos. Quando você lida com amostras de menos de 20 observações, o erro pode chegar a 10% ou mais, e aí a correção importa de verdade.
Como aplicar a fórmula passo a passo
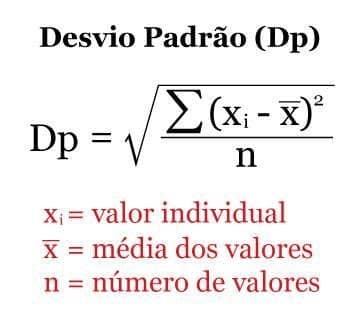
Pegue seus dados. Digamos que você tenha as seguintes medições: 12, 15, 14, 13, 16, 11, 14, 15. A média é 13,75. Agora calcule a diferença de cada observação em relação à média e eleve ao quadrado: (12 - 13,75)² = 3,0625, (15 - 13,75)² = 1,5625, e assim por diante. Some todos esses quadrados. O resultado é a soma dos quadrados dos desvios. Divida por n-1. No exemplo acima, n é 8, então você divide por 7. O quociente é a variância amostral. Por fim, tire a raiz quadrada. O resultado é o desvio padrão amostral S. Na prática, você não precisa fazer esses cálculos à mão. Ferramentas como Excel, Python com numpy ou R fazem tudo automaticamente. No Excel, a função é STDDEV.S. Em Python, numpy.std com ddof igual a 1. O problema é que muitas pessoas copiam a função STDDEV.P por hábito, e essa calcula com n no denominador, não com n-1. É um erro extremamente comum que já vi acontecer em relatórios de qualidade, artigos científicos e até em planilhas de engenharia. Sempre verifique qual função está usando. Se o seu software pedir o parâmetro ddof, defina como 1 para desvio padrão amostral.
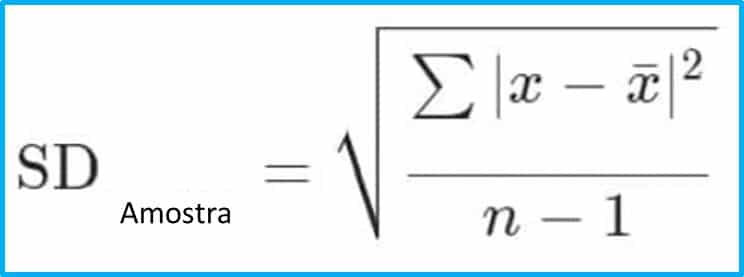
O problema que quase me custou um contrato
Em 2021, eu estava analisando a variabilidade de tolerâncias em um processo de usinagem. Trabalhava com amostras de cinco peças retiradas a cada hora. O processo tinha uma especificação de tolerance muito apertada: 10 milímetros mais ou menos 0,02 milímetros. Eu estava monitorando o desvio padrão para garantir que o processo estava sob controle estatístico. Usei uma função de planilha que eu confiava cegamente, e ela estava calculando com n em vez de n-1. Como minha amostra era sempre de tamanho cinco, a correção de Bessel multiplicava meu resultado por cerca de 1,118. Meu desvio padrão estava subestimado em quase 12%. O gráfico de controle mostrava o processo como "estável" quando na verdade ele estava fora dos limites. Eu só descobri quando o cliente mediu as peças e encontrou rejeição superior a 5%. A correção foi simples: troquei a fórmula na planilha e refiz todo o monitoramento. A primeira semana após a correção mostrou que o processo já estava fora de controle há pelo menos três semanas. O contrato estava prestes a ser renovado e eu precisei apresentir os dados corretos ao cliente, incluindo um plano de ação para recuperar o processo. Levei dois dias inteiros refazendo todas as análises. Depois desse incidente, desenvolvi um hábito: toda vez que for calcular desvio padrão amostral, escrevo explicitamente a fórmula no cabeçalho da planilha e confirmo o denominador antes de enviar qualquer relatório.
Quando a fórmula desvio padrão amostral não é suficiente
O desvio padrão amostral é uma medida útil, mas ele assume que os dados seguem uma distribuição aproximadamente normal. Se seus dados forem fortemente assimétricos, o desvio padrão pode não capturar adequadamente a variabilidade. Por exemplo, se você está medindo tempos de espera em um atendimento e a maioria dos casos dura dois minutos mas alguns duram horas, o desvio padrão vai ser grande, mas a mediana e os quartis vão dar uma ideia muito mais precisa de como os dados se comportam na maioria das vezes. Nesses casos, a amplitude interquartil ou o desvio absoluto mediano são alternativas mais informativas. Outro cenário em que o desvio padrão amostral perde utilidade é quando você tem poucos dados e muitos valores extremos. Com amostras menores que dez observações, a própria estimativa do desvio padrão se torna muito imprecisa. O intervalo de confiança para o desvio padrão pode ser extremamente amplo. Se você precisa de inferência estatística com amostras pequenas, o teste t de Student ou os intervalos de confiança baseados na distribuição qui-quadrado para a variância são mais adequados do que simplesmente reportar um único valor de S. Existe ainda o problema da dependência entre observações. Em séries temporais ou dados de processos industriais, as medições sucessivas frequentemente não são independentes. O desvio padrão amostral padrão trata cada observação como independente, o que não é verdade nesse contexto. A solução mais comum é estimar a variância usando métodos que levem em conta a autocorrelação, como o estimador de Newey-West ou a análise de variância por blocos. Sem essa correção, seu desvio padrão estará novamente enviesado, mas agora pela direção oposta: tende a superestimar a variabilidade real quando há autocorrelação positiva.
Erros comuns que você provavelmente vai cometer
Um erro frequente é usar a função de desvio padrão populacional quando deveria usar a amostral. Outro é confundir variância com desvio padrão. A variância é o quadrado do desvio padrão, então se você precisa de uma resposta em milímetros, não pode parar na variância porque ela estará em milímetros ao quadrado. Também vejo pessoas calcularem a média corretamente e depois usarem essa média arredondada nos cálculos subsequentes, o que introduz erro de arredondamento cumulativo. Sempre mantenha o máximo de casas decimais possível durante o cálculo e só arredonde no resultado final. Um terceiro erro é tratar o desvio padrão como uma medida de tendência central. O desvio padrão não diz onde os dados estão concentrados. Ele diz o quão espalhados eles estão em torno da média. Se dois conjuntos de dados têm a mesma média mas desvios padrão diferentes, a média é idêntica mas a dispersão é completamente distinta. Sempre reporte junto com a média, ou informe qual medida de tendência central é relevante para o seu contexto.
Galeria
-

Calculadora De Desvio Padrão Amostral - FDPLEARN -

Exemplo de desvio padrão: o que é, fórmula e calculadora -
Qual A Diferença De Desvio Padrão Amostral E Populacional? – ZSANC
