Foto De Texto Para Copiar
Como extrair texto de uma foto de jeito que funciona de verdade
A maioria das pessoas abre a câmera, tira uma foto de um documento impresso e espera que o celular magicamente transforme aquilo em texto editável. Na prática, o resultado costuma ser um caos de palavras erradas, linhas misturadas e formatação que não obedece a nada. Eu passei anos corrigindo esse tipo de coisa no dia a dia, então vou explicar o processo sem enrolação. O conceito por trás de foto de texto para copiar é simples: você captura uma imagem contendo caracteres legíveis e usa um sistema de reconhecimento óptico de caracteres, ou OCR, para converter aqueles pixels em texto selecionável. A parte que ninguém conta é que a qualidade do resultado depende muito mais de como a foto foi feita do que da ferramenta que você vai usar depois. Um documento mal iluminado com sombra projetada sobre ele vai dar errado independente do software que você escolher. Acredite ou não, a iluminação é o fator mais negligenciado por iniciantes. Eu já vi gente tentar extrair texto de uma folha posta sobre uma mesa com uma lâmpada acesa acima. O reflexo no papel apaga metade das palavras e o OCR acha que algumas letras são ruído. A solução mais barata e eficiente é tirar a foto de um documento plano, sob luz natural indireta ou com a luz da sala acesa de forma uniforme, mantendo o celular paralelo ao papel. Nada de ângulo oblíquo, nada de flash.
Passo a passo para transformar foto em texto copiável
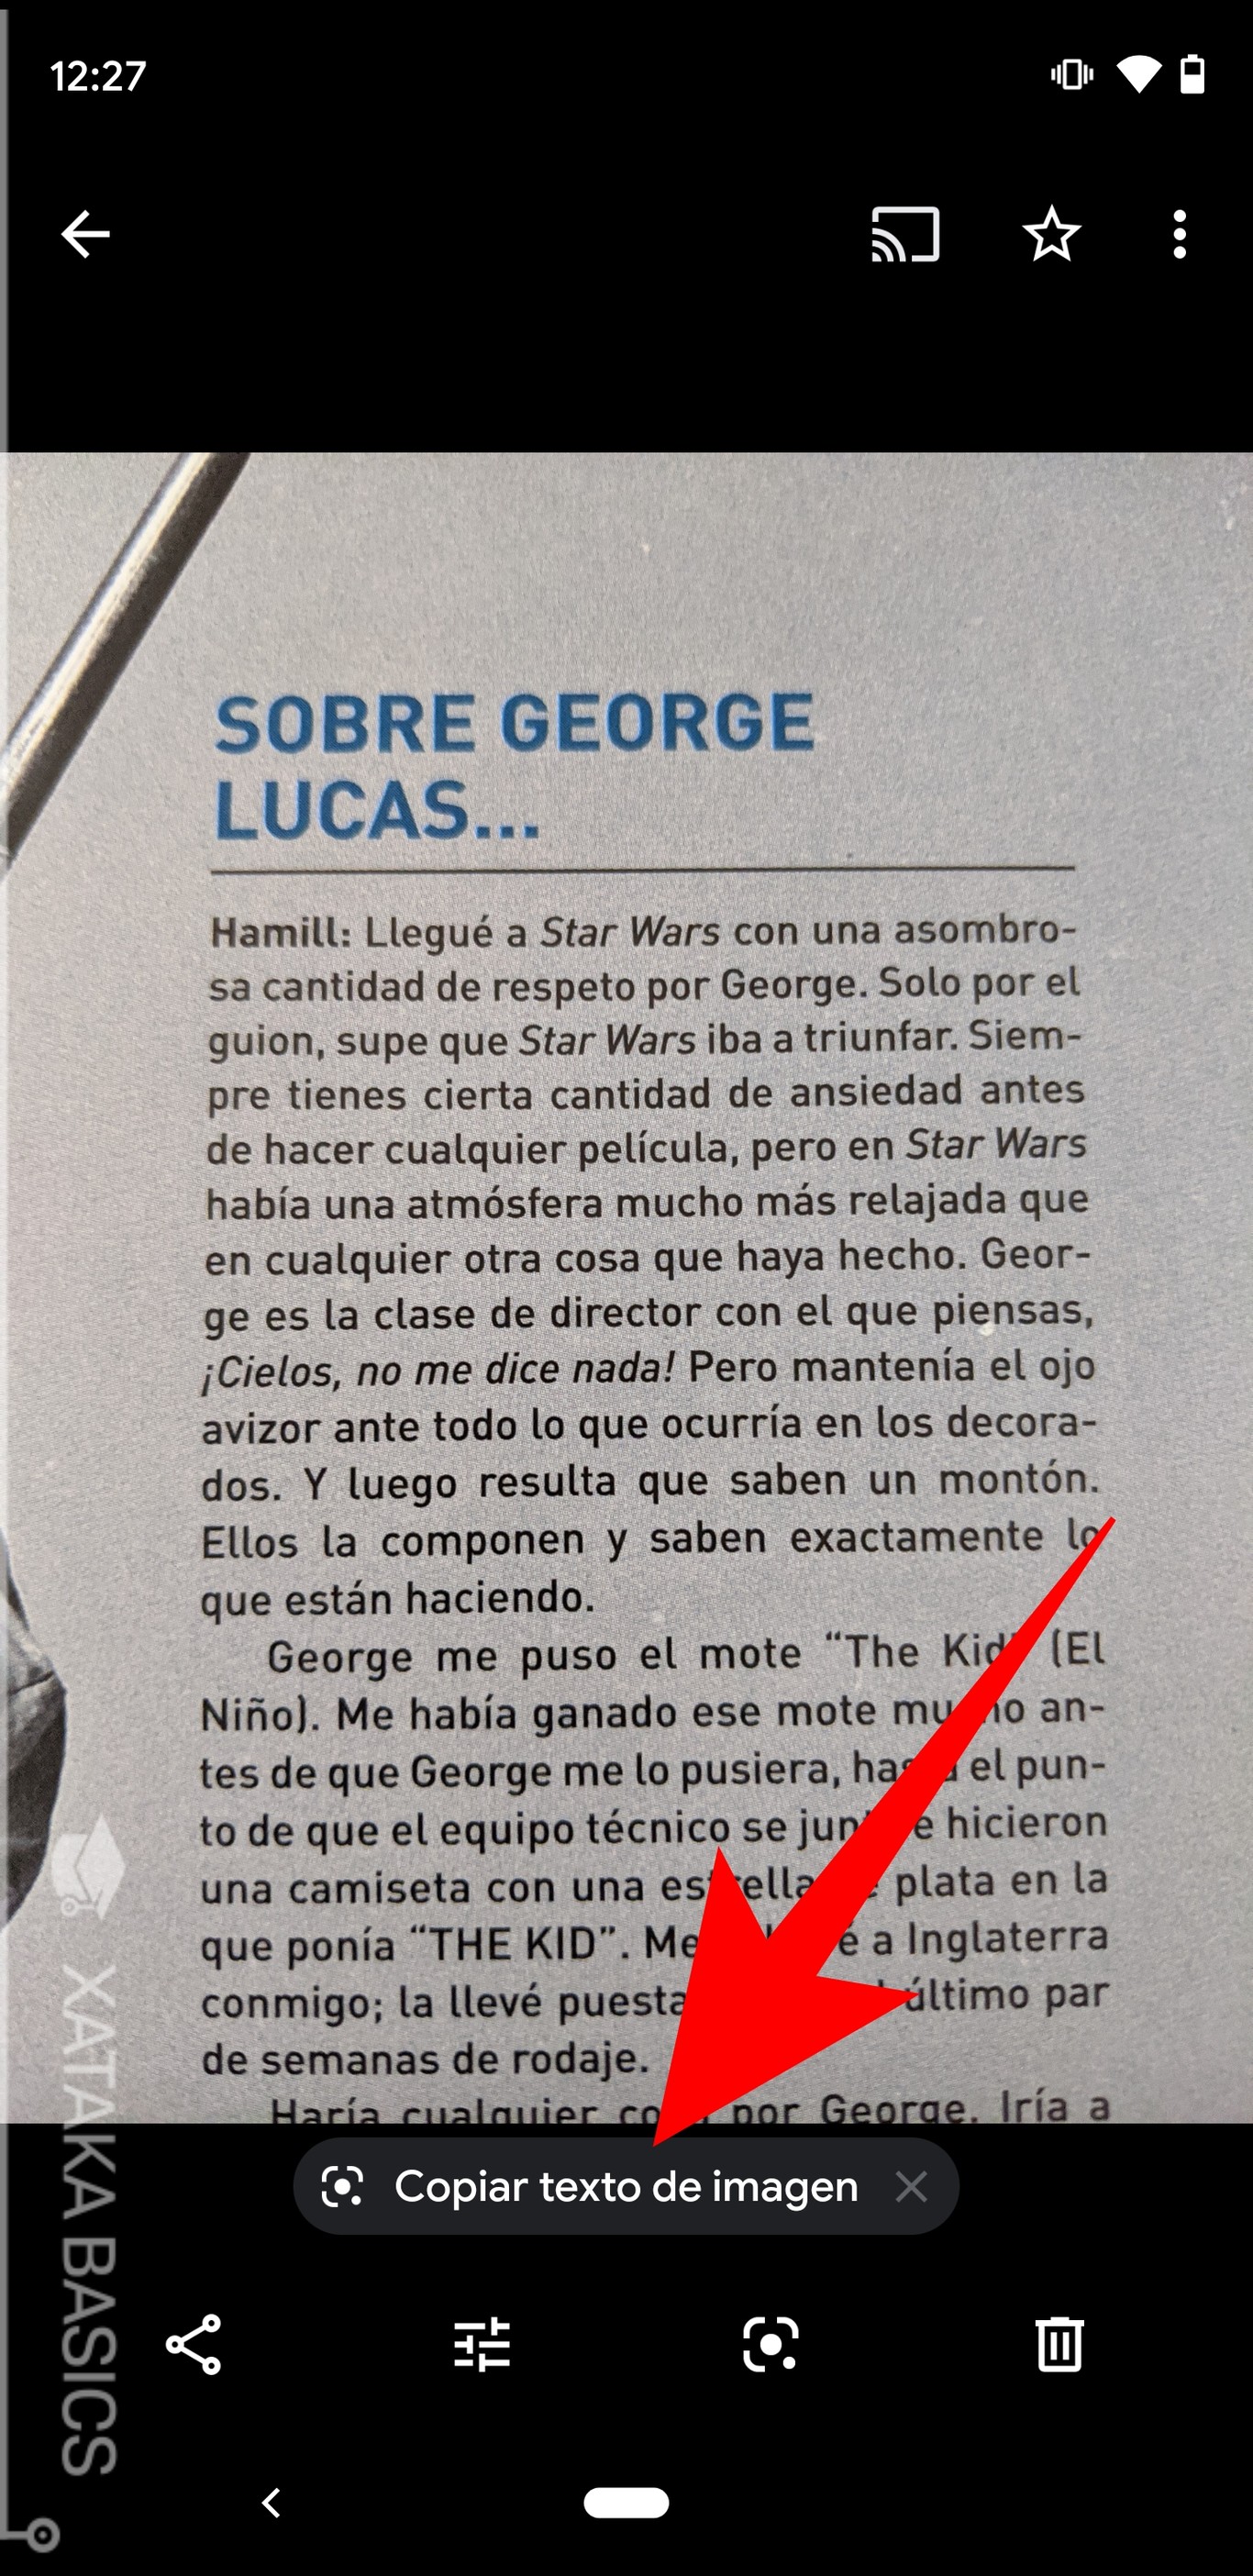
Aqui está o processo que eu uso rotineiramente e que funciona na grande maioria dos casos. Você pode fazer isso no celular Android ou iOS sem instalar nada além do que já vem padrão. No Android, abra a câmera e fotografe o documento. Em seguida, abra o app Google Fotos, selecione a imagem e toque em "Copiar texto da imagem". No iPhone, use a função de seleção de texto direto pela câmera ou pela galeria: abra a foto, segure o dedo sobre o bloco de texto até ele destacar e toque em copiar. Ambos os métodos usam o OCR embutido do sistema operacional e entregam resultados decentes para documentos limpos. Para documentos mais complicados, com tabelas, fontes manuscritas ou baixa resolução, o OCR nativo dos celulares falha com frequência. Nesse cenário, o Google Docs é uma alternativa sólida. Você sobe a imagem para o Google Drive, clica com o botão direito e seleciona "Abrir com Google Docs". O serviço processa a imagem e gera um documento com o texto extraído logo abaixo da foto original. O resultado costuma ser superior ao OCR do celular porque o Google treina seus modelos com volumes muito maiores de dados.
Existem também ferramentas online como OCR.space ou OnlineOCR.net que funcionam de forma semelhante. Você sobe a imagem, escolhe o idioma do texto e baixa o arquivo de saída. O problema dessas ferramentas gratuitas é que elas têm limitações de tamanho de arquivo, filas de processamento e, em muitos casos, armazenamento dos seus dados nos servidores deles. Para documentos sensíveis ou confidenciais, essa é uma variável que não deve ser ignorada.

Problemas reais que todo mundo subestima
Um caso específico que me deu trabalho recentemente envolvia uma foto de uma tabela médica digitalizada. O OCR do Google Docs estava convertendo "mg" para "08" em várias células, o que era um risco real se alguém usasse aquele texto sem revisão. O workaround que funcionou foi simples: antes de rodar o OCR, eu apliquei um filtro de aumento de contraste no Photoshop ou até mesmo no app básico de edição do celular, transformando o fundo cinza do papel scanneado em branco puro e o texto em preto saturado. O resultado mudou de 72% de precisão para cerca de 94% nos números. Não é um fix perfeito, mas faz diferença significativa. O outro problema crônico é a formatação. O OCR converte texto, não layout. Tabelas viram texto corrido, parágrafos são esmagados em um bloco só, e notas de rodapé acabam misturadas com o corpo do texto. Se o documento original tem uma estrutura que precisa ser preservada, prepare-se para passar mais tempo formatando do que propriamente extraindo. Isso é especialmente verdade para contratos, artigos acadêmicos e formulários preenchidos. Outro ponto que quase ninguém menciona: a escolha do idioma no OCR. Se o seu documento está em português mas o sistema está configurado para inglês, a taxa de erro dispara, especialmente em palavras com acentos e cedilhas. Verifique sempre a configuração de idioma antes de processar. No Google Docs, você consegue adicionar idiomas extras em Configurações do OCR. No iPhone, o reconhecimento é automático baseado na configuração de idioma do dispositivo, o que pode ser tanto vantagem quanto armadilha dependendo do contexto.
Alternativas quando o OCR convencional não basta
Quando o texto na foto está danificado, manchado, dobrado ou escrito à mão de forma difícil de ler, os motores de OCR padrão simplesmente desistem. Nesse cenário, existem duas rotas que valem a pena considerar. A primeira é o Amazon Textract, que é mais robusto para documentos estruturados e reconhece campos e tabelas com maior fidelidade. A segunda opção, mais acessível para uso pessoal, é oABBYY FineReader. Ele custa dinheiro, mas é um dos poucos sistemas que realmente preserva formatação de documentos complexos e lida bem com versões ruins de digitalização. Eu prefiro o ABBYY para trabalhos recorrentes porque o tempo que economia na pós-correção compensa o investimento. Para quem não quer gastar nada e o OCR padrão não resolve, minha recomendação final é a combinação de duas estratégias: primeiro tentar o Google Docs OCR com o documento devidamente tratado (contraste ajustado, rotação corrigida se necessário), e depois usar a ferramenta de busca de texto da imagem que o próprio Google oferece na aba "Imagens" do navegador. Às vezes o Google Images indexou aquela imagem específica e consegue extrair o texto com mais precisão do que qualquer ferramenta genérica.
O limite real da tecnologia atual é que texto manuscrito ainda é, grosso modo, uma área cinzenta. Ferramentas como o Handwriting OCR do Google melhoraram muito nos últimos anos, mas ainda cometem erros grotescos em caligrafias pouco claras. Se o seu documento é majoritariamente manuscrito, o mais honesto é admitir que a extração automática terá uma taxa de erro que exigirá revisão manual em praticamente toda a extensão do texto. Não adianta esperar perfeição.

Galeria
-

Como Copiar Texto de Imagem: Guia Completo e Simples | UPDF -
Copiar texto de imagem - Converter imagem em texto | Fotor -

Como copiar texto de imagem e extrair a informação no PC ou celular
