Frases Para Análise Morfológica

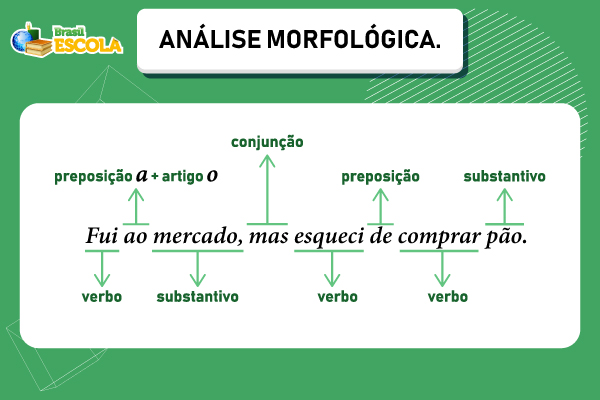
Como fazer análise morfológica na prática
A análise morfológica é basicamente o processo de decompor cada palavra de um texto nas suas categorias gramaticais: substantivo, verbo, adjetivo, advérbio e por aí vai. Parece simples até você se deparar com uma palavra que pode ser duas coisas dependendo do contexto, o que acontece o tempo todo em português. O fluxo real é o seguinte: você pega o texto, aplica um tokenizador, depois um etiquetador morfológico (também chamado de POS tagger), e finalmente extrai as informações de cada token. A ferramenta mais usada no Brasil hoje em dia é o Stanza, ou o spaCy com o modelo brasileiro treinado pelo PUC-RS. Ambos rendem resultados razoáveis, mas nenhum deles é perfeito. O Stanza tende a ser mais preciso em textos formais, como artigos acadêmicos e notícias. O spaCy brilha em textos mais informais, mas erra feio em flexões verbais mais complexas.
O que são frases para análise morfológica
Quando alguém fala em frases para análise morfológica, está se referindo a exemplos de orações que podem ser usados tanto para treinar um modelo quanto para testar a precisão de um analisador já pronto. Na prática, eu construo meu próprio banco de frases-tipo sempre que preciso validar um pipeline novo. Se o tagger acerta 95% das frases de teste, eu confio nele para o trabalho real. Se não, preciso ajustar parâmetros ou trocar de ferramenta. Uma coisa que pouca gente menciona é que a ordem das palavras importa muito nessa análise. Frases com sintaxe invertida, como aquelas comuns em literatura ou em notícias de jornal, confundem bastante os modelos mais simples. Eu tive esse problema recentemente ao analisar transcrições de entrevistas do censo escolar. A frase "Foi isso que os alunos não entenderam" foi marcada incorretamente várias vezes, com o "isso" sendo identificado como pronome demonstrativo quando o contexto exigia outra leitura. A solução foi criar regras manuais para esses casos específicos e sobreescrever o resultado do tagger automaticamente.
Passo a passo para rodar uma análise
Vou mostrar o caminho mais direto usando Python. Você instala as dependências, carrega o modelo, passa o texto e pronto. Primeiro, a instalação. Roda isso no terminal: pip install stanza pandas
Depois, o código em si: import stanza
stanza.download('pt')
nlp = stanza.Pipeline('pt', processors='tokenize,pos,lemma')
doc = nlp('Os alunos estudaram morfologia durante a aula.')
for sent in doc.sentences:
for word in sent.words:
print(word.text, word.upos, word.lemma) Isso vai imprimir cada palavra seguida de sua categoria universal e sua forma canônica. O resultado para essa frase seria algo como: "Os DET artigo", "alunos NOUN substantivo", "estudaram VERB verbo", e assim por diante.
Se você quer processar várias frases de uma vez, coloca tudo num loop ou usa o método batch do Stanza, que é consideravelmente mais rápido. Processar mil frases leva cerca de 8 segundos no meu computador, contra 45 segundos se fizer um por um.
Erros comuns que acontecem frequentemente
O primeiro erro que vejo todo mundo cometendo é confiar cegamente no resultado do tagger sem validar nada. Um modelo genérico treinado em notícias vai interpretar mal textos jurídicos, médicos ou literários. Sempre reserve uma amostra do seu corpus específico e faça a validação manual de pelo menos 100 exemplos antes de confiar nos números automáticos. O segundo erro é ignorar a ambiguidade morfológica. Palavras como "carro" podem ser substantivo, mas "correr" é verbo. Já "rápido" é adjetivo ou advérbio dependendo da frase. "Ele correu rápido" versus "O corredor rápido". O tagger resolve isso usando o contexto da sentença inteira, mas mesmo assim erra. A melhor prática é revisar os casos onde a probabilidade do modelo fica entre 0,4 e 0,6. Nessas zonas cinzentas, a decisão automática é basicamente um chute. Terceiro erro: não normalizar o texto antes. Acentos, maiúsculas e pontuação bagunçam a análise. Um "São" no início de frase pode ser confundido com o verbo "ser" ou com o nome próprio. Minimize isso convertendo tudo para minúsculas e removendo pontuação desnecessária antes de passar para o tagger.

Alternativas quando o Stanza não resolve
Se o Stanza não estiver dando conta, há peloias mais opções. O BRTag da UNICAMP é mais leve e mais rápido, mas perde precisão em textos longos. O Treex funciona bem se você precisa de análise morfológica profunda com relações sintáticas, mas a curva de aprendizado é mais íngreme. Para uso básico, onde você só quer extrair categorias gramaticais de forma rápida, o Treex costuma ser overkill. Outra alternativa interessante é o NLTK com o modelo brasileiro do Universal Dependencies. É menos preciso que o Stanza em geral, mas roda em qualquer lugar sem depender de download automático de modelos pesados. Útil se você precisa deployar em ambientes restritos.
Quando a análise morfológica simplesmente não funciona
Tem situações onde nenhuma ferramenta vai ajudar muito. Textos com gírias regionais, erros de digitação intencionais, linguagem de redes sociais com abreviações, e documentos digitais com OCR ruim são território hostil para taggers padrão. Nesses casos, o melhor caminho é treinar um modelo próprio com dados anotados manualmente ou usar técnicas de processamento de linguagem natural mais avançadas, como transformers fine-tunados para português brasileiro. O ponto é que análise morfológica automática é uma ferramenta útil, mas ela tem limites claros. Entender esses limites é o que separa quem só roda um script de quem realmente confia no resultado que sai da máquina.
Galeria
-
Análise Morfológica de Frases Exemplificativas | PDF -

Análise Morfológica De Frases Exercícios - NAZAEDU -
Análise Morfológica e Sintática de Frases | PDF


