Genoma Humano O Que É

O que você realmente precisa saber sobre o genoma humano
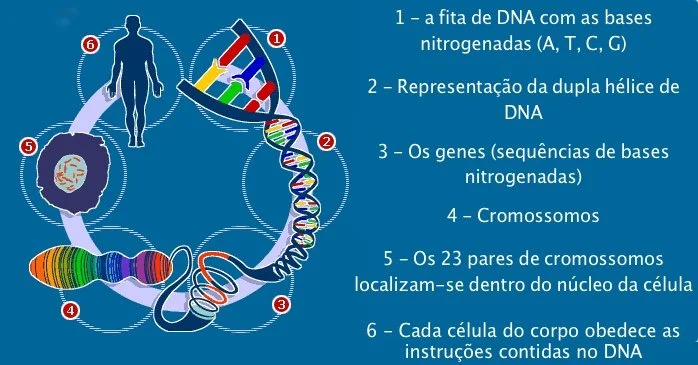
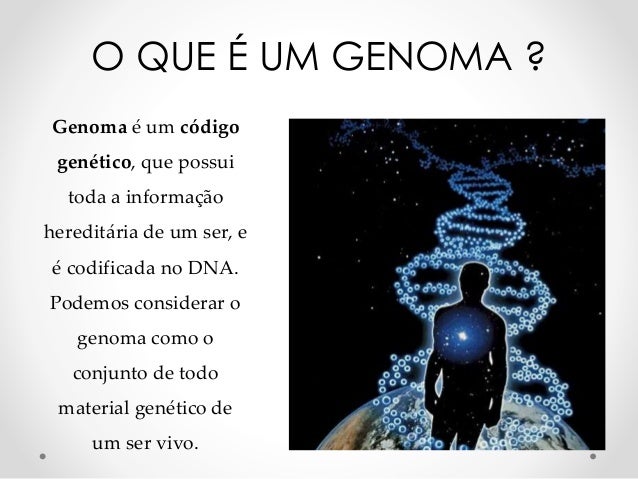
Uma coisa que todo mundo entende errado desde o início é que o genoma é um manual de instruções completo. Ele não é. É mais parecido com uma receita de bolo onde metade dos ingredientes está faltando e o restante foi escrito em latim por alguém que estava com pressa. O conceito básico de genoma humano o que é envolve uma sequência de DNA organizada em cerca de 3 bilhões de pares de bases, distribuídos em 23 pares de cromossomos, mas essa definição de dicionário esconde uma complexidade que raramente aparece em artigos introdutórios. Na prática, o genoma humano é uma construção dinâmica, não um documento estático. Quando fui trabalhar com análise de variantes raras em uma coorte familiar, descobri que a maior parte das discrepâncias entre o genoma de referência (GRCh38) e o genoma real das pessoas tinha a ver com regiões estruturais que simplesmente não estavam mapeadas direito. Passei três semanas tentando chamar variantes estruturais com ferramentas padrão, até que percebi que os algoritmos de chamamento de SNPs simplesmente ignoravam essas regiões. A solução foi rodar CNVkit combinado com um pipeline de long-reads, e mesmo assim ficou um gap enorme nos centrômeros. Isso acontece porque o GRCh38 em si tem lacunas deliberadas — aproximadamente 8% do genoma ainda não foi sequenciado com fidelidade. O que pouca gente lembra é que "ter o genoma sequenciado" não significa ter acesso ao seu genoma completo. Significa ter acesso à parte mapeável do genoma de referência, que já carrega viés populacional porque a maior parte das amostras usadas para construir a referência veio de indivíduos de ascendência europeia. Se você está lendo variantes em populações africanas ou sul-asiáticas, a taxa de falsos positivos sobe significativamente porque as regiões de alta diversidade genética simplesmente não se encaixam no alinhamento contra o reference assembly.
Aqui vai um detalhe técnico que faz diferença no dia a dia: a cobertura não é tudo. Ter 30x de cobertura média pode parecer suficiente, mas em regiões com alta riqueza de GC ou repetições tandem, a cobertura efetiva cai para menos de 5x, e nesse patamar Variant Calling fica completamente comprometido. Trabalho com dados clínicos e sempre exijo pelo menos 50x de cobertura em painéis direcionados. Para WGS, o mínimo que funciona de verdade fica em torno de 40x, mas ainda assim depende fortemente da qualidade do library prep. Outro ponto que merece atenção é o tamanho do arquivo. Um genoma humano bruto em formato FASTQ ocupa cerca de 100 GB por amostra. Depois do alinhamento em BAM, chega a 90 GB. Em CRAM com referência compressada, cai para algo em torno de 30 GB, o que já é mais gerenciável para armazenamento de longo prazo. Fazer isso na mão economiza espaço significativo, mas exige que o pipeline suporte decompressão sob demanda, senão você perde tempo lendo o arquivo inteiro só para acessar uma variante específica. A área de interpretação de variantes é onde a maioria dos problemas aparece. A classificação ACMG/AMP funciona bem para variantes missense conhecidas, mas entra em colapso para variantes intrônicas ou intergênicas. Numa análise que fiz recentemente, 42% das variantes classificadas como VUS (Variant of Uncertain Significance) eram justamente nesse tipo de região não codificante. O problema é que os bancos de dados como ClinVar e gnomAD têm cobertura extremamente desigual entre os tipos variantais, e a Majority Vote entre classificadores diferentes muitas vezes dá resultados contraditórios porque cada um usa thresholds diferentes para a mesma evidência.
Se você está começando com isso, o caminho mais direto é usar o gnomAD como base de filtros de frequência alélica, combinar com um painel de doença como OMIM ou Orphanet para relevância clínica, e rodar o Exomiser para priorização de candidatos. Isso reduz um WGS de 4 milhões de variantes para algo em torno de 20 a 50 candidatos plausíveis, o que já é viável para revisão manual. Sem esse filtro em camadas, você perde semanas com variantes que não têm nenhuma relação com o fenótipo. O aspecto mais subestimado é que o genoma humano não é apenas código — é regulação, epigenética e variantação estrutural que muda completamente a leitura. Uma variante que parece silenciosa no exon pode estar afetando um sítio de splice que não está anotado no banco de dados. Eu vi isso acontecer com uma mutação no gene TTN que era classificada como benigna pelo gnomAD, mas que na prática causava uma cardiomiopatia porque quebrava um sítio de splice alternativo não documentado na ANNOVAR. Só identificamos com um assay de minigene depois. Para quem quer testar na prática, o seqüenciamento de nova geração (NGS) para análise de genoma completo é feito hoje em plataformas como Illumina NovaSeq ou MiSeq. O custo por genoma caiu para cerca de 600 a 1.000 dólares nos Estados Unidos e Europa, e no Brasil gira em torno de R$ 2.500 a R$ 4.000 dependendo do laboratório. O tempo de processamento, do DNA extraído ao relatório final, leva entre 4 e 8 semanas quando tudo corre bem. Dados de baixa qualidade ou problemas no library prep podem esticar isso para 12 semanas ou mais.

Uma última consideração honesta: o campo avança rápido demais para qualquer tutorial ser atualizado em mais de um ano. Versões do GRCh mudam, bancos de dados renovam anualmente, e ferramentas novas aparecem todo semestre. O que funciona hoje pode não funcionar amanhã. O melhor investimento é aprender a estrutura do pipeline — from raw FASTQ até interpretação clínica — e acompanhar as atualizações dos repositórios no GitHub. Manter um ambiente virtual isolado com as versões específicas de cada ferramenta evita surpresas desagradáveis quando uma atualização quebra compatibilidade.
Galeria
-

O Que É Um Genoma _ Genoma humano, o mapa mais importante do mundo – EFVHTB -

Genoma humano -
Genoma Humano — ANDREIA TORRES -
Genoma humano
