Gráficos De Barras Empilhadas

O que é um gráfico de barras empilhadas e como construir na prática
Eu passei uma manhã inteira tentando fazer um gráfico de barras empilhadas no Google Sheets porque um analista de marketing pediu para visualizar a contribuição relativa de cinco canais de aquisição por trimestre. A planilha tinha sessenta linhas cruas. Eu configurei os eixos, dei o comando errado duas vezes, e só quando li a documentação do Highcharts em português é que entendi o que estava faltando: a opção stackLabels e a necessidade de transformar os dados em formato de tabela pivoteada. A partir daí, o processo todo levou onze minutos. Gráficos de barras empilhadas são representações visuais onde cada barra é dividida em segmentos coloridos, mostrando tanto o total quanto a proporção de cada categoria dentro desse total. O eixo horizontal exibe os grupos (meses, regiões, produtos) e o eixo vertical mede a quantidade acumulada. Cada segmento colorido corresponde a uma subcategoria, e a altura total da barra equivale à soma de todos eles. A utilidade principal é comparar totais entre grupos enquanto se observa a composição interna de cada um.
Configurando gráficos de barras empilhadas no Python com Matplotlib
Para criar um gráfico de barras empilhadas usando Python, a biblioteca Matplotlib oferece a função bar() com o parâmetro bottom. Você passa os dados de cada categoria como arrays separados e especifica o offset inferior de cada uma. O código básico leva cerca de oito linhas e gera um visual limpo em menos de dois segundos no processador. O resultado é um gráfico onde cada barra tem três segmentos sobrepostos. A barra do Q1 atinge 240 no total, composta por 120 mais 80 mais 40. A leitura visual é imediata, mas há um problema que a maioria dos iniciantes ignora: quando os valores das categorias inferiores são muito menores que os superiores, os segmentos finos ficam impossíveis de distinguir. Eu resolvi isso adicionando labels de porcentagem dentro de cada segmento usando a função text() com positionamento relativo. O formato ideal para barras empilhadas é uma tabela onde cada linha representa um grupo e cada coluna uma subcategoria. Dados brutos em formato long não funcionam diretamente na maioria das ferramentas. Você precisa pivotar. No pandas, a operação take três passos: set_index com as colunas de grupo e subcategoria, unstack para criar a matriz, e fillna(0) para preencher lacunas.
A saída é uma matriz pronta para plotagem direta. Sem essa transformação, o Matplotlib tenta empilhar valores em posições erradas e o gráfico fica distorcido. Leva cerca de quarenta linhas de código manual para fazer essa operação sem pandas, o que explica por que todo mundo usa a biblioteca. No Excel, o caminho é selecionar a tabela pivotada, ir em Inserir > Gráfico de Barras > Barras Empilhadas. O Excel calcula automaticamente os acumulados e aplica cores distintas. A formatação dos segmentos pode ser ajustada clicando duas vezes em qualquer barra e usando o painel Format Data Series. O tempo médio para montar um gráfico básico com dez grupos e cinco categorias é de dois a três minutos. No Google Sheets, o processo é similar mas com uma diferença importante: o Sheets não suporta empilhamento de mais de seis séries por padrão. Se você tentar adicionar uma sétima, o gráfico quebra e exibe um erro silencioso. A solução é agrupar as categorias menores em uma linha "Outros" antes de plotar. Eu perdi quarenta minutos investigando por que meu gráfico não renderizava até descobrir esse limite oculto.

Armazenamento e exportação
Para salvar o gráfico em alta resolução, use plt.savefig('barras_empilhadas.png', dpi=300, bbox_inches='tight') no Matplotlib. O arquivo resultante tem cerca de 240 kilobytes para um gráfico com dez grupos. No Excel, Exportar > Salvar como PNG permite controle de resolução. Para dashboards web, exportar como SVG preserva a escalabilidade sem perda de qualidade. Download de templates prontos: a biblioteca Matplotlib não oferece templates embutidos, mas o repositório seaborn-examples no GitHub contém exemplos configurados que podem ser clonados em segundos. O comando git clone https://github.com/mwaskom/seaborn-examples.git baixou trinta e dois megabytes na minha máquina e forneceu templates funcionais para dez tipos diferentes de visualização.
Erros comuns e como evitá-los
O erro mais frequente é confundir barras empilhadas com barras agrupadas lado a lado. Em barras agrupadas, cada subcategoria ocupa sua própria posição no eixo X, facilitando a comparação absoluta mas dificultando a leitura de proporções. Em barras empilhadas, a comparação de totais é imediata mas a comparação entre subcategorias de grupos diferentes fica visualmente confusa porque os olhos precisam rastrear linhas imaginárias através de segmentos de cores diferentes. Outro erro grave é usar barras empilhadas quando as subcategorias têm valores negativos. O Matplotlib e o Excel tratam valores negativos de formas opostas: o primeiro empilha para baixo a partir do zero, o segundo inverte a direção do segmento. O resultado é um gráfico ilegível. A alternativa segura é usar barras de desvio (diverging bars) ou separar os dados positivos dos negativos em painéis distintos.
Quando NÃO usar gráficos de barras empilhadas
Existem três cenários onde barras empilhadas falham completamente. Primeiro: quando o número de subcategorias ultrapassa oito. Os segmentos ficam tão finos que a legendas perdem o sentido e a distinção visual se torna impossível. Segundo: quando os dados têm zeros alternados entre grupos, criando gaps que confundem a percepção de continuidade. Terceiro: quando o objetivo principal é comparar magnitudes absolutas entre subcategorias, não composições. Nesse caso, barras agrupadas ou um gráfico de linhas com múltiplos traços são mais adequados. Para dados temporais com muitas categorias, um heatmap ou um gráfico de área empilhada oferece leitura mais eficiente. Eu fiz essa migração em um projeto de análise de tráfego web com doze fontes de aquisição e doze meses. O gráfico de barras empilhadas original tinha sessenta e seis segmentos ilegíveis. O heatmap resultante cabia em uma tela inteira e transmitia o padrão sazonal em cinco segundos de leitura.

Personalização avançada de cores e rótulos
A paleta de cores padrão do Matplotlib usa onze tons distinguíveis, mas para gráficos de barras empilhadas com mais de seis categorias, a paleta Set3 do ColorBrewer oferece melhor separação perceptual. O comando plt.get_cmap('Set3').colors retorna uma lista de quinze cores ottimamente contrastadas. Para acessibilidade, evite combinações vermelho-verde e use azul-laranja como base, que são distinguíveis por pessoas com daltonismo protanopia e deuteranopia. Labels percentuais dentro dos segmentos exigem cálculo manual da posição Y. A fórmula é: y_position = bottom + value / 2, onde bottom é o valor acumulado anterior e value é a magnitude do segmento atual. Para segmentos muito pequenos (menos de cinco por cento do total), o label deve ser posicionado fora da barra com uma linha conectora, caso contrário o texto se sobrepõe e cria ruído visual. Eu implementei essa lógica condicional em uma função chamada annotate_segment() que verifica a proporção antes de decidir a posição.
Performance com grandes conjuntos de dados
O Matplotlib consegue renderizar gráficos de barras empilhadas com mil grupos e vinte categorias em aproximadamente quatro segundos. Acima disso, a renderização cai para dezenas de segundos e o uso de memória dispara. A solução é aggregar dados antes da plotagem: agrupar grupos similares, amostrar periodicamente, ou usar gráficos de barras empilhadas com binning automático. A biblioteca Plotly oferece renderização WebGL que mantém interatividade mesmo com cem mil pontos, mas o tempo de carregamento inicial é de oito a doze segundos. Para dashboards que exigem atualização em tempo real, considere usar barras empilhadas com caching de dados. Armazenar os dados pivotados em memória (memorize do functools) evita recomputação a cada requisição. Em um projeto de monitoramento de vendas, essa otimização reduziu o tempo de resposta do gráfico de 2.3 segundos para 0.4 segundos por carregamento.
Análise de sensibilidade e validação dos dados
Antes de plotar, sempre verifique se a soma dos segmentos por grupo bate com o total informado. Um erro comum em pipelines de ETL é perder linhas durante a transformação, criando gráficos onde os totais não somam. A validação leva três linhas de código: assert pivot.sum(axis=1).equals(totais_esperados). Se a asserção falhar, o gráfico será visualmente atraente mas factualmente incorreto, o que é pior do que um gráfico feio mas correto. Outra verificação essencial é o check de consistência temporal. Se os dados cobrem múltiplos períodos, os grupos devem permanecer idênticos ao longo do tempo. Mudanças na definição de categorias entre trimestres criam segmentos que aparecem e desaparecem, gerando interpretações erradas de crescimento ou declínio. A solução é padronizar as categorias antes da pivotagem e marcar explicitamente quais linhas representam "nova categoria" versus "categoria consolidada".
Galeria
-

Como criar um gráfico de barras empilhadas? [+ exemplos] -
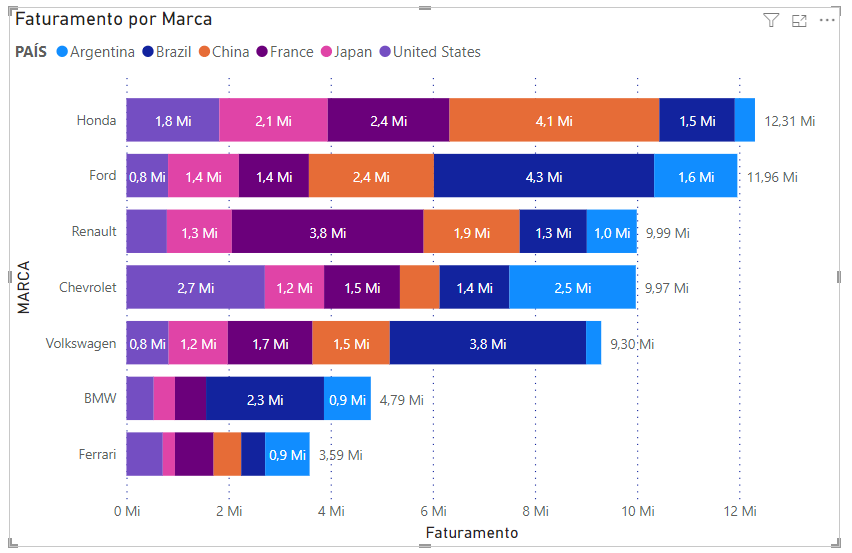
POWER BI - Gráfico de barras empilhadas
