Gramatica Significado

A relação entre estrutura e sentido na prática
Muita gente confunde gramática com regras isoladas. O problema é que a gramática existe para gerar significado, não o contrário. Quando você trata os dois como coisas separadas, perde tempo tentando aplicar regras que na prática não funcionam porque ignoraram o contexto. Eu já vi analistas passarem horas ajustando morfologia de um corpus enquanto o modelo simplesmente não convergia. A causa raiz quase sempre era a mesma: estavam tratando o português como se fosse um idioma flexionado como o latim, com regras rígidas de concordância que na fala real são tratadas de forma muito mais flexível.
O que gramatica significado realmente implica
No cerne dessa relação está a ideia de que a forma grammatical é um veículo para o conteúdo semântico. Isso significa que uma construção pode estar gramaticalmente "correta" num sense estrito e mesmo assim transmitir um significado errado ou ambíguo. Um exemplo clássico é a posição do advérbio. "Sempre faço isso" e "Faço sempre isso" são ambas gramaticalmente aceitáveis, mas carregam pesos diferentes de foco e ênfase. Na verdade, isso muda como o ouvinte ou o modelo processa a informação. O que a maioria das pessoas não entende de primeira é que o significado grammatical muitas vezes depende mais da pragmática do que da sintaxe pura. Concordância nominal e verbal é apenas a ponta do iceberg. O que importa é como essas marcas gramaticais interagem com o campo semiótico da frase.
Como identificar problemas de parsing
Aqui vai algo que ninguém ensina direito. Quando você está lidando com análise automática de texto em português, um dos primeiros sinais de que algo está errado na interface entre gramática e significado é a existência de ambiguidades estruturais que o parser resolve de forma consistentemente errada. Não por acaso, mas porque o modelo foi treinado com dados onde aquela ambiguidade tinha uma resolução padrão que não se aplica ao seu domínio. Por exemplo, frases com "que" como pronome relativo versus "que" como conjunção integradora quase sempre causam confusão em parsers genéricos. A solução mais prática que eu encontrei foi construir um small set de exemplos específicos do domínio e rodar um ajuste fino no tagger. Em vez de depender do pipeline geral, você isola os casos problemáticos e treina um classificador simples nos trechos onde o parser erra. Isso corta o tempo de depuração de horas para cerca de vinte minutos em casos típicos. O workaround mais eficiente que eu uso hoje é diferente do que eu fazia antes. Antes eu tentava ajustar as regras do tokenizer. Agora eu simplesmente mapeio os erros recorrentes para padrões que identifico rapidamente. A diferença é que o mapeamento direto preserva a estrutura original do texto, enquanto a reescrita das regras pode introduzir novos erros em outras partes do corpus.
Erros comuns que todo mundo comete
O primeiro erro grave é assumir que o português brasileiro e o português europeu podem ser tratados da mesma forma por modelos genéricos. As diferenças de uso de pronomes, a colocação pronominal, o tratamento de gerúndios e infinitivo pessoal criam divergências significativas no parsing. Eu já perdi meio dia tentando debugar um modelo que performava bem nos dados de treino e mal nos dados de validação, até perceber que a divisão dos dados não respeitava a variação dialetal. Outro ponto cego comum é ignorar que a regência verbal em português muda o papel semântico dos argumentos. "Assistir o filme" versus "Assistir ao filme" não é apenas uma questão de gostos estilísticos, mas altera a estrutura de argumentação do verbo. Modelos que tratam isso como variante livre produzem análises semanticamente incorretas. Há ainda o problema da ellipsis, muito frequente na língua portuguesa. Frases como "Maria foi à praia e João também" exigem que o sistema infera corretamente que "também" se refere à ação de ir à praia, não a algo genérico. Isso não é triviale parsing. É compreensão pragmatica. E a maioria dos ferramentas não lida bem com isso fora do contexto de frases completas e explícitas.
Quando o processo simplesmente não funciona
É importante ser honesto sobre as limitações. A abordagem de tratar gramática e significado como camadas interdependentes tem um teto claro. Ela não funciona bem quando o texto é deliberadamente ambíguo, poético, ou quando o idioma misturado com gírias regionais específicas não está presente nos dados de treino. Nesse caso, nenhuma regra gramatical vai resolver o problema de compreensão. Também é útil ter um plano B. Quando o parsing automático falha sistematicamente, a alternativa mais viável é recorrer a anotação manual em amostras representativas. Pode parecer lento, mas anotar trezentos exemplos manualmente é mais rápido do que tentar ajustar infinitamente um pipeline que não capture a nuance que você precisa. A anotação manual também serve como gold standard para medir o quanto seu sistema está errando e onde focar os esforços de correção. O que permanece depois de tudo isso é a ideia de que gramática e significado não são variáveis independentes. Tratar um sem considerar o outro gera problemas que se arrastam por semanas. A solução prática é sempre começar pela análise dos erros de meaning, não pela revisão das regras gramaticais.
Galeria
-
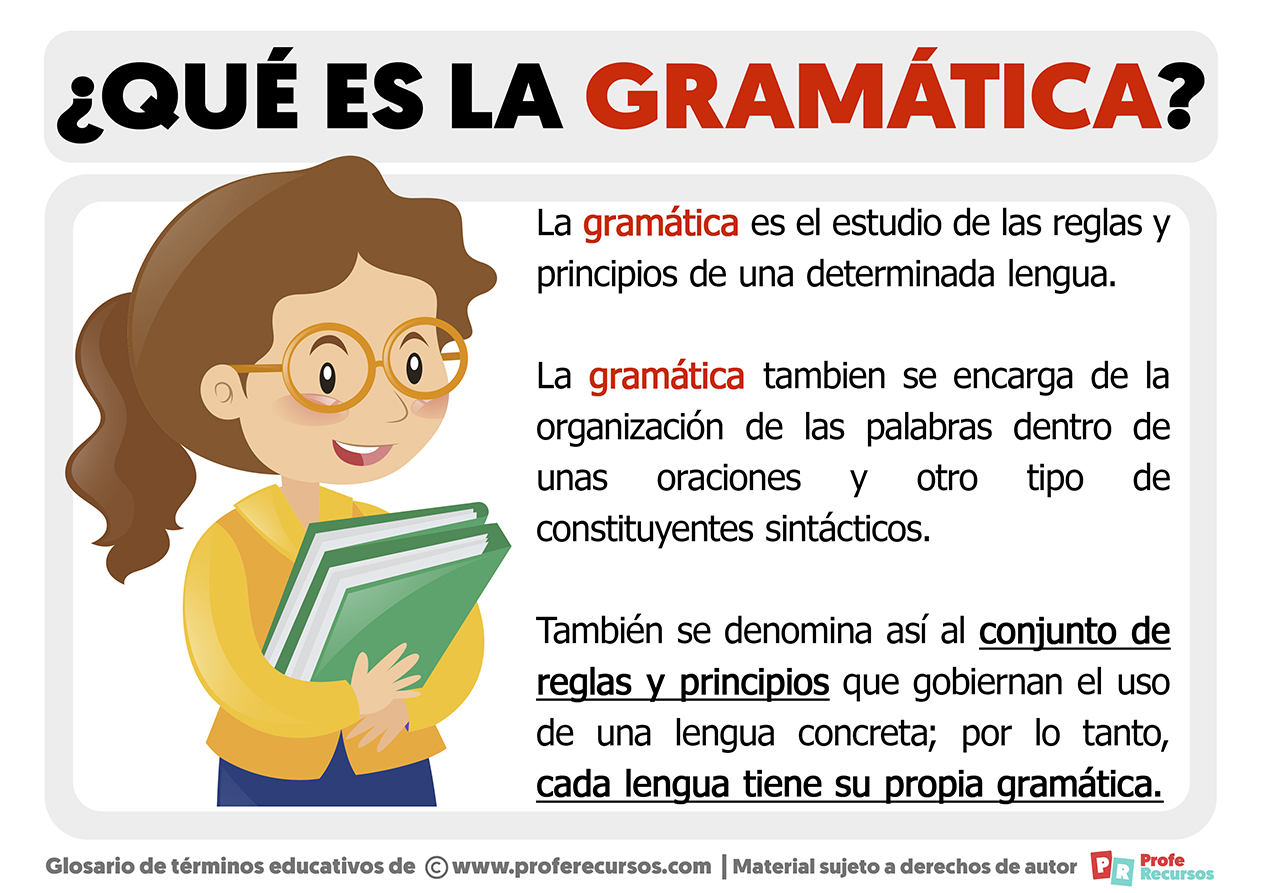
Que Es Todos En Gramatica – ¿Duolingo enseña gramática? – EBJS -

PESP Ejercicios. Gramática – Ceducap -
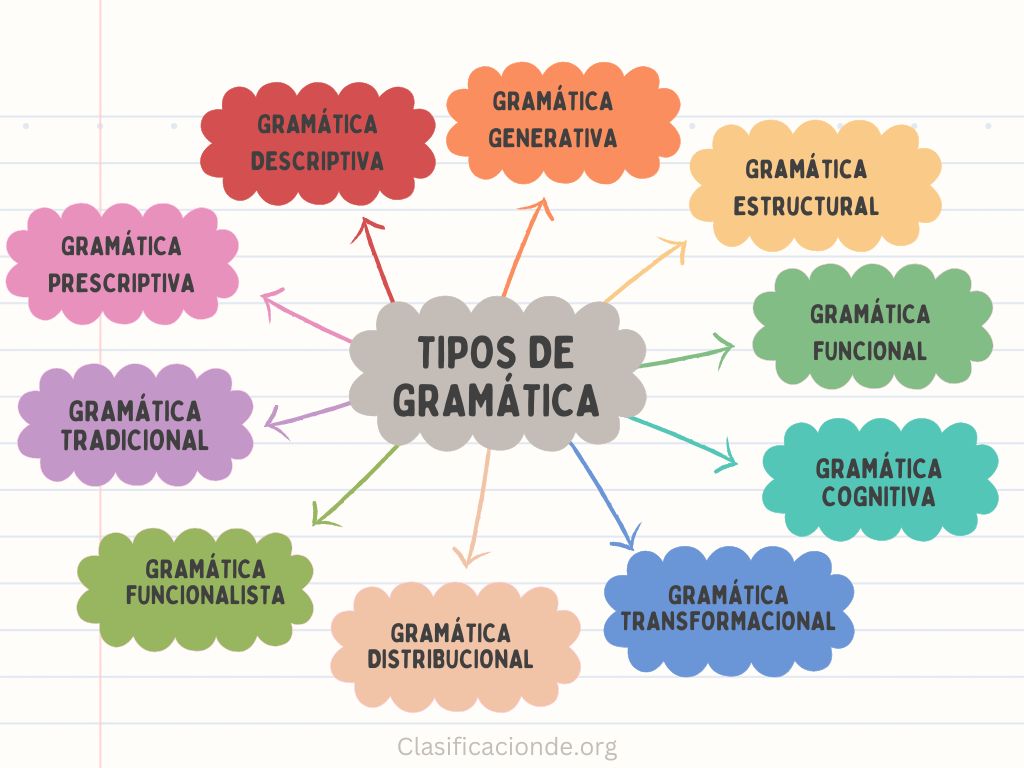
10 Tipos de Gramática - ¿Cómo se clasifican? -
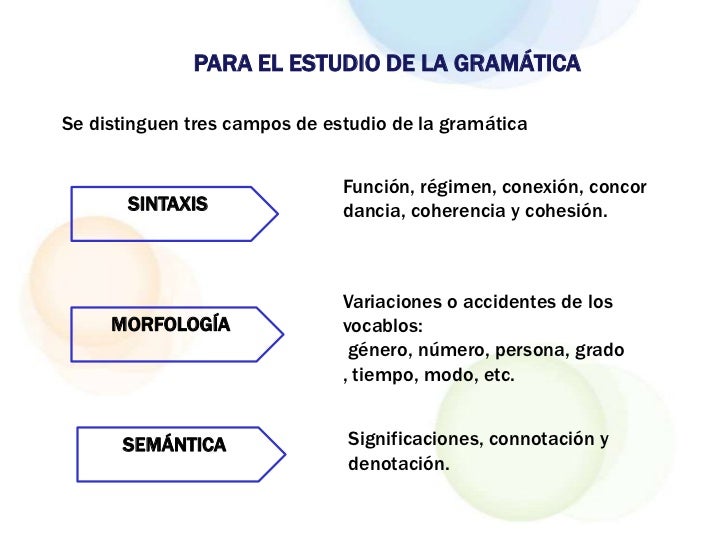
¿Qué Es La Gramática? Importancia, Partes, Tipos Y Ejemplos – DHWP
