Hierarquia Banco De Dados

Entendendo como os dados se organizam em camadas
A hierarquia de banco de dados não é um conceito único e mágico. É a forma como os sistemas estruturam informações em níveis de abstração, do mais físico ao mais conceitual. O modelo mais ensinado nas faculdades é o de três níveis da ANSI/SPARC, mas na prática você lida com coisas bem mais bagunçadas. Em termos simples, a hierarquia banco de dados refere-se à organização em camadas que separa como os dados são armazenados fisicamente, como são vistos logicamente e como o usuário final os enxerga. A camada física cuida de arquivos, discos, índices e páginas de memória. A camada lógica define tabelas, colunas, chaves, tipos de dados. A camada externa é a visão que cada aplicação ou usuário específico recebe. O problema é que a maioria dos projetos modernos nem chega perto dessa separação limpa. Você pega um PostgreSQL rodando, conecta com uma API em Node.js, e na tela o usuário vê JSON. Onde estão as três camadas aí? Elas existem de forma implícita, sim, mas a responsabilidade de manter a coerência entre elas caiu inteiramente sobre você. Sem um DBA dedicado, sem equipe de infraestrutura separada. Você é tudo isso ao mesmo tempo.
Camadas e como elas se conectam
O nível físico é onde os dados realmente residem. Armazenamento em disco, padrões de acesso, paginação, alocação de espaço. Aqui entram os detalhes de como cada motor de banco decide escrever um registro. O PostgreSQL, por exemplo, usa MVCC com tuplas visíveis por transação, e isso impacta diretamente o tamanho dos arquivos no disco e a fragmentação ao longo do tempo. Não é algo que o schema define, mas é consequência direta da decisão arquitetural. No nível lógico, você opera com o modelo relacional tradicional: tabelas, constraints, foreign keys, índices. É aqui que a maior parte dos desenvolvedores passa o tempo. Mas o nível lógico não existe isolado. Uma foreign key mal indexada no nível lógico pode causar locks em cascata que degradam o nível físico inteiro. O banco não distingue essas camadas durante a execução. Ele apenas executa. Já o nível externo é onde surgem as views, os schemas por tenant, as permissões granulares. Em sistemas multi-tenant, eu costumo criar um schema por cliente e usar policies no RLS (Row Level Security) do PostgreSQL para garantir isolamento. Isso é a camada externa funcionando como deveria. O problema aparece quando alguém esquece de adicionar a policy e uma query mal formada retorna dados de outro cliente. Já vi isso acontecer em produção. A correção foi um trigger que validava a tenant_id em todas as INSERTs e UPDATEs adicionais, além das policies existentes.
Outros modelos hierárquicos que você encontra no mercado
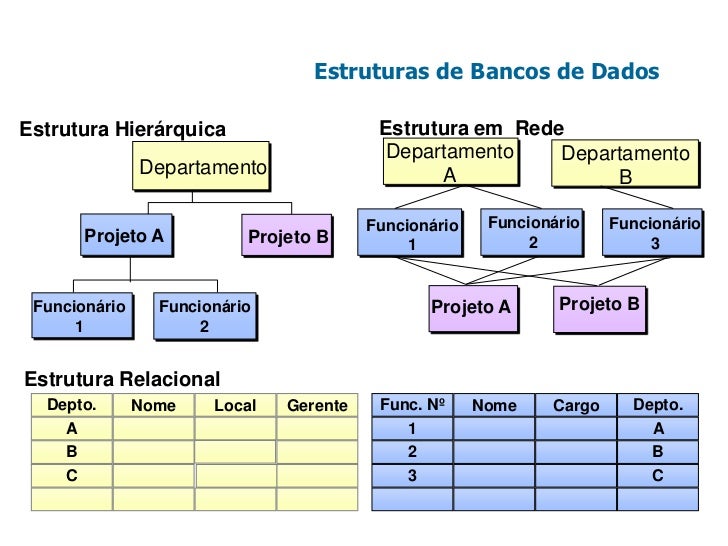
Além do modelo relacional com suas três camadas, existem abordagens completamente diferentes. O modelo hierárquico original, aquele dos anos 60 com DBTG e IMS da IBM, organizava dados em árvores pai-filho. Um registro pai podia ter múltiplos filhos, mas um filho tinha apenas um pai. Era rápido para consultas em estruturas bem definidas, como organogramas ou árvore de diretórios. Caía feio quando precisava de relacionamentos muitos-para-muitos. Hoje em dia, você encontra variantes disso em bancos orientados a grafos e em alguns sistemas de arquivo NoSQL. O modelo em rede foi a evolução natural do hierárquico, permitindo que um registro tivesse múltiplos pais. Resolveu parte do problema dos muitos-para-muitos, mas trouxe complexidade extrema de manutenção. Praticamente extinto em sistemas novos, ainda aparece em legados bancários e de seguros que rodam desde os anos 80. No mundo NoSQL, a hierarquia aparece de formas diferentes. Bancos como MongoDB organizam documentos em coleções com estruturas aninhadas. Um documento pode conter um array de subdocumentos, que por sua vez contenham outros arrays. Isso cria uma hierarquia interna dentro de cada documento, o que é útil para dados com relação 1-N bem definida e acessada em conjunto. O problema é que consultas que precisam atravessar múltiplos níveis de aninhamento ficam lentas sem índices compostos adequados. E indexes em campos dentro de arrays em documentos grandes consomem memória de forma inesperada.

Bancos columnar como ClickHouse ou Amazon Redshift organizam a hierarquia de outra forma: dados são agrupados por colunas em blocos de compressão no disco. A leitura de uma única coluna em bilhões de linhas pode ser ordens de magnitude mais rápida do que em um banco row-oriented porque o motor lê apenas os blocos relevantes. Isso não é hierarquia no sentido ANSI/SPARC, mas é uma escolha de organização em camadas que impacta diretamente performance.
Um caso real que aprendi da forma difícil
Há alguns anos, lidava com um sistema de inventário que usava PostgreSQL com uma tabela de categorias em auto-relacionamento (nested set, não materialized path). A query para buscar todas as subcategorias de um nó usava um CTE recursivo. Funcionava bem com poucos milhares de registros. Quando o banco cresceu para cerca de 40 mil categorias com profundidade média de 7 níveis, as queries de navegação levavam de 200ms para algo acima de 8 segundos em horários de pico. O gargalo não era o CTE em si. Era que o plano de execução escolhia um nested loop em vez de hash join porque os estatísticas estavam desatualizadas. A solução que funcionou foi rodar ANALYZE manual nas tabelas envolvidas, atualizar o parâmetro default_statistics_target de 100 para 300 nas colunas de chave estrangeira da tabela de categorias, e depois migrar de nested set para materialized path com uma coluna de caminho string. A query de navegação caiu para menos de 50ms com um índice B-tree simples na coluna de path. O nested set tinha vantagens teóricas de integridade, mas na prática gera manutenção custosa e planos de execução instáveis.
Pegadinhas que ninguém conta
Primeira: views materializadas não resolvem tudo. Elas são úteis para agregações caras que não mudam com frequência, mas o overwrite manual ou o refresh programado pode criar janelas de inconsistência. Eu já vi relatórios gerados com dados de duas semanas atrás porque o refresh estava configurado para rodar a cada 24 horas e o job falhava silenciosamente por falta de permissão no esquema de destino. Monitorar o último refresh é obrigatório, não opcional. Segunda: a hierarquia de permissões no PostgreSQL segue uma ordem específica que muitos ignoram. Roles herdam permissões de roles dos quais são membros, mas permissões explícitas em tabelas sobre postergam permissões herdadas. Se você concede SELECT em uma view para um role e depois revoga esse role de um grupo maior, o SELECT na view permanece para aqueles usuários. A única forma de remover é revogar explicitamente na view também. É um detalhe que causa dores de cabeça recorrentes em ambientes com many desenvolvedores e RBAC mal documentado. Terceira: hierarquia de banco de dados não significa necessariamente melhor performance. Adicionar níveis de abstração como views, procedures e triggers pode melhorar a manutenibilidade, mas cada camada adicional adiciona overhead de parsing e execução. Uma view que envolve outra view que chama uma função PL/pgSQL com lógica complexa vai ser mais lenta do que uma query direta equivalente. O ideal é usar abstração onde ela agrega valor real de segurança ou consistência, não como padrão automático para tudo.

Quando a hierarquia tradicional não serve
Sistemas distribuídos com sharding quebram a ideia de uma única hierarquia centralizada. Cada shard tem seu próprio esquema lógico, mas a visão unificada depende da aplicação. Isso significa que foreign keys entre shards não existem no banco. A consistência é garantida em nível de aplicação, o que é muito mais propenso a erros. Já trabalhei com um sistema onde um pedido podia referencear um cliente que estava em outro shard. A query funcionava porque a aplicação fazia dois selects separados e juntava os dados na memória. Se um dos shards estivesse fora do ar, o pedido simplesmente não era criado, sem aviso nenhum. Bancos NewSQL como CockroachDB e TiDB tentam resolver isso mantendo uma hierarquia SQL tradicional por cima de um cluster distribuído. Eles oferecem transações ACID across shards, o que é vantajoso. A desvantagem é latência significativamente maior em comparação com um banco single-node para operações point-read, e o custo de infraestrutura é consideravelmente mais alto. Para workloads que não precisam de transações cross-shard, um Postgres single-node com sharding aplicado pela aplicação (usando partições ou bancos separados) costuma ser mais simples e mais rápido. O modelo document store também desafia a hierarquia tradicional ao eliminar a necessidade de schema fixo. Cada documento pode ter campos diferentes. Isso é poderoso para dados semiestruturados, mas gera problemas de consistência que o modelo relacional resolve automaticamente com constraints. Em um projeto meu com MongoDB, tivemos um caso onde campos numéricos eram salvos como string por um bug em um microserviço antigo. Nenhum índice, nenhuma constraint, nenhuma validação no banco. O problema só apareceu quando o dashboard de analytics começou a exibir valores errados porque a agregação fazia soma de strings ao invés de números. A correção envolveu um script de migração para limpar os dados existentes e adicionar validação via JavaScript no application layer, já que MongoDB não tem check constraints nativos de forma prática.
Conclusão prática
Não existe hierarquia perfeita. A melhor estrutura depende do volume de dados, da complexidade das relações, da equipe disponível e dos requisitos de consistência versus performance. Comece com o modelo que resolve o problema atual. Não adicione camadas de abstração por padrão. Monitore os planos de execução. Mantenha estatísticas atualizadas. E documente as decisões de schema porque daqui a seis meses ninguém vai lembrar por que aquela foreign key estava ali ou por que você escolheu materialized path em vez de nested set.
Galeria
-

Modelo De Banco De Dados De Rede Estruturas E Hierarquia De Banco De -
Aula tecnologia da informacao 6 banco de dados -

Modelo De Banco De Dados Hierarquico Banco De Dados: O Que é E Como
