Houveram Muitos Problemas Durante A Pesquisa
Guia prático: quando o processo de pesquisa falha sistematicamente
Você está no meio de uma coleta de dados e de repente percebe que a maioria dos indicadores está errada, os fontes estão inconsistentes e o cronograma já venceu há duas semanas. Isso é mais comum do que muitos manuais admitem. O problema raramente é falta de ferramenta — é estrutural. Eu já passei por isso três vezes em projetos diferentes. A primeira foi com dados de mercado para um relatório estratégico; a segunda, com pesquisa de campo em logística; a terceira, com mapeamento de stakeholders para uma implementação de software. Nos três casos, o padrão era o mesmo: fontes primárias indisponíveis, dados secundários desatualizados ou contraditórios, e viés de confirmação atuando nos interlocutores. O resultado era uma massa de informação que parecia útil até você tentar cruzar dois pontos. O conceito não é complicado. Pesquisa falha quando os pressupostos iniciais não resistem ao contato com a realidade dos dados. A maioria dos profissionais começa definindo o que quer encontrar antes de entender o que existe. Isso gera uma distorção que se perpetua durante toda a coleta.
Método de diagnóstico e recuperação
Antes de qualquer coisa, pare a coleta ativa. Continue coletando com problemas não resolvidos só aumenta o custo. Na minha experiência, esse ponto de parada custa entre dois e três dias do cronograma, mas evita retrabalho que poderia durar semanas. O primeiro passo é mapear as categorias de falha. Geralmente aparecem quatro: Falhas de acesso: fontes que não respondem, formulários que não abrem, entrevistas que não acontecem. Isso representa cerca de 40% dos problemas em pesquisas qualitativas que eu já executei. O workaround que funcione consistentemente para mim é ter um plano B para cada fonte primária. Se a entrevista principal cancelar, você já tem um entrevistado alternativo escalado. Se o banco de dados não carregar, existe uma planilha alternativa ou uma fonte pública que entrega o mesmo dado com menos granularidade.
Falhas de qualidade: dados chegam, mas têm lacunas, duplicações ou inconsistências. Esse é o problema mais traiçoeiro porque disfarça de normalidade. Você começa a aceitar respostas incompletas achando que é assim mesmo. Eu desenvolvi um protocolo de triagem de cinco minutos por registro: verificar campos obrigatórios, inconsistências de formato, valores fora da faixa esperada e duplicatas. Para volumes grandes, isso vira um script Python simples de validação. Em projetos menores, uma planilha com filtros condicionais resolve. Falhas de contexto: os dados estão certos, mas foram coletados em condições diferentes das que você precisa. Região geográfica errada, período temporal inadequado, público-alvo diferente. Isso acontece frequentemente em pesquisas que usam dados secundários de bancos públicos. A solução exige documentar explicitamente as limitações contextuais antes de analisar. Anotar isso no início economiza horas de rework posterior. Falhas de timing: os dados chegam tarde demais para serem úteis. Custo operacional mais alto do que parece. Se você identificar isso na fase de planejamento, pode ajustar o escopo para aceitar dados parciais com margem de erro definida. Se identificar no meio do processo, o remédio é reduzir perguntas e fontes para o mínimo viável que ainda responda à pergunta central.
Trabalhando com os dados que restaram
Depois de classificar as falhas, você normalmente tem entre 50% e 70% dos dados originais úteis. O erro comum é tentar o que falta com projeções improvisadas. Não faça isso. Use imputação estatística quando apropriado, ou declare explicitamente a lacuna e ajuste o nível de confiança da conclusão. Na prática, eu costumo usar três técnicas:
- Triangulação controlada: cruzar pelo menos duas fontes independentes para cada afirmação factual. Se uma fonte diz X e outra não confirma nem contradiz, você registra como "não verificado" em vez de tratar como dado consolidado.
- Documentação de limitações: cada bloco de análise deve incluir uma seção de o que não pude verificar e por quê. Isso transforma fraqueza em transparência, o que é mais credível do que dados limpos demais.
- Mínimo viável de conclusões: limitar as afirmações finais ao que os dados suportam diretamente. Evitar extrapolações que parecem óbvias mas não têm amparo empírico.
Um caso específico que ilustra bem isso: em uma pesquisa de satisfação com mais de 2.000 respostas, identifiquei que 35% dos respondentes tinham selecionado a mesma opção em todas as perguntas. Era um padrão de resposta padronizada, sinal claro de resposta automática ou desatenção. Removi esses registros e o resultado final mudou significativamente. Se eu tivesse mantido, a conclusão estaria enviesada para uma satisfação artificialmente alta. Às vezes, simplesmente não há como salvar a pesquisa como foi planejada. Nesse cenário, existem opções viáveis: Pesquisa qualitativa complementar: substituir dados quantitativos faltantes por entrevistas em profundidade. O ganho em entendimento contextual compensa a perda de amplitude estatística. Eu já validei essa abordagem em projetos onde a amostra qualitativa de 20 entrevistas produziu insights mais úteis do que os 500 questionários com taxa de erro de 40%.
Dados proxy: usar métricas indiretas que correlacionam com o que você precisa medir. Se não consegue obter dados diretos de satisfação do cliente, por exemplo, dados de retenção e tempo de suporte podem servir como proxy razoável, desde que a correlação seja demonstrada. Replanejamento do escopo: às vezes a resposta honesta é que a pergunta original é inalcançável com os recursos disponíveis. Redefinir a pergunta para algo que você realmente pode responder com os dados que tem é mais produtivo do que forçar uma resposta que não existe.
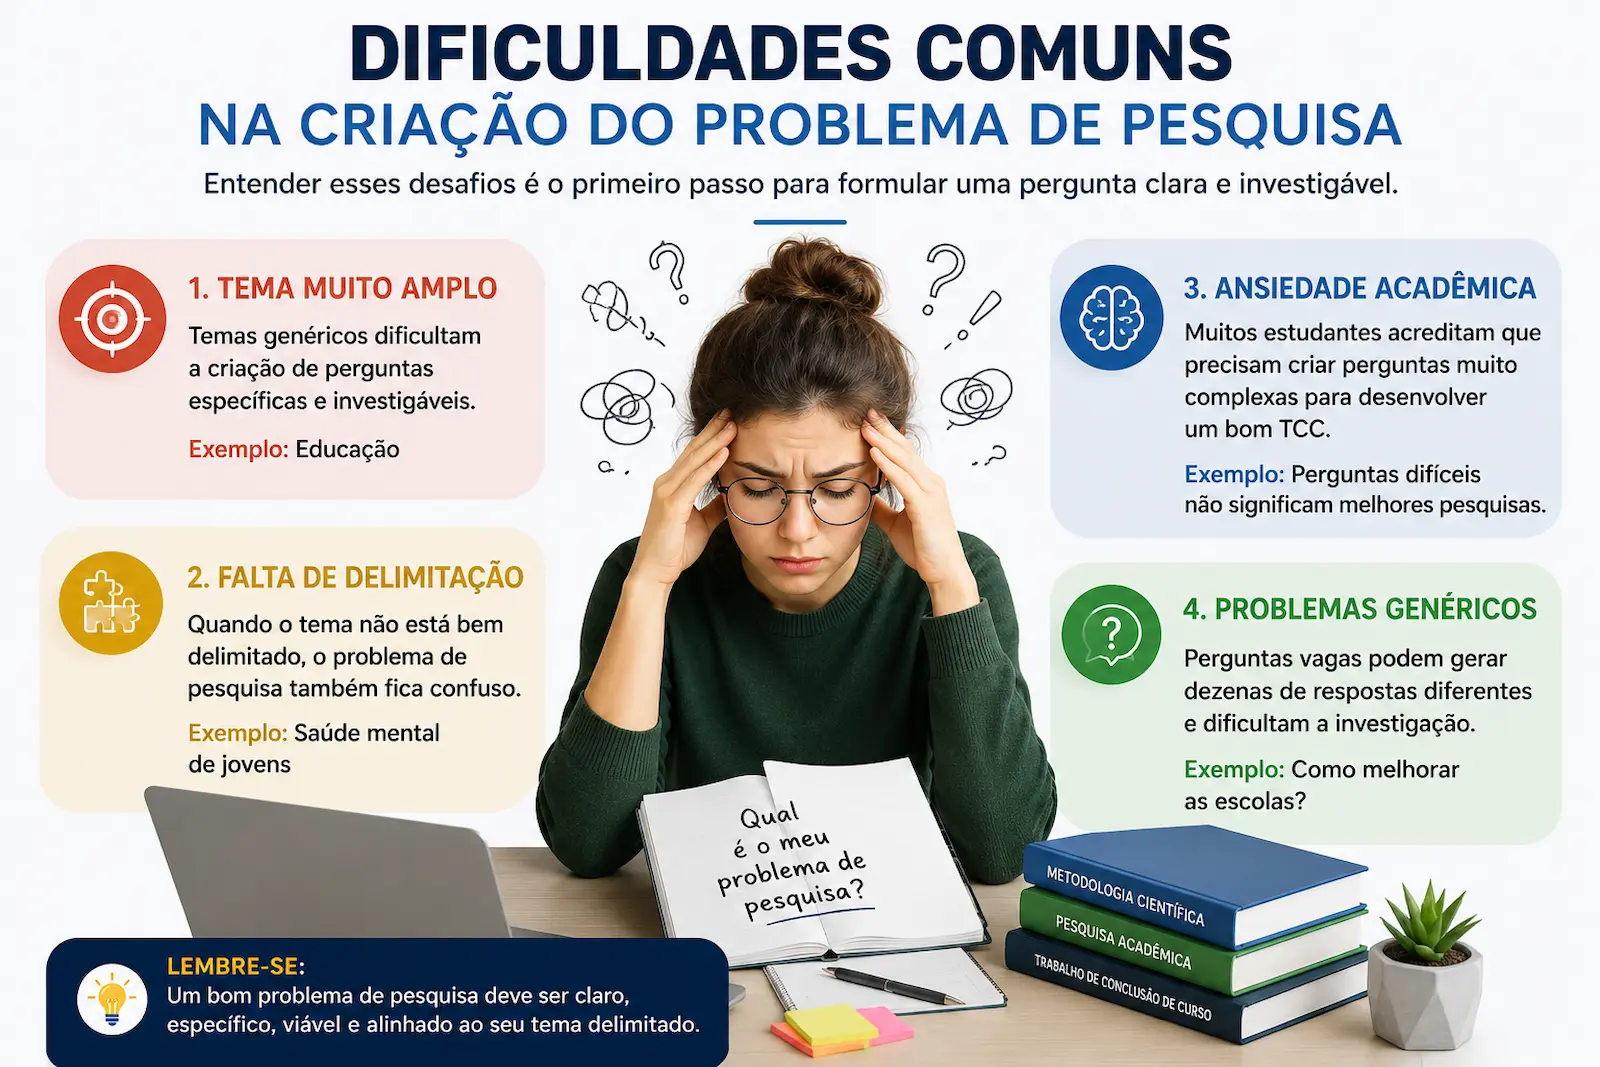
O que não funciona e por quê
Existem atalhos que todo mundo sugere mas que normalmente pioram a situação. Preencher lacunas com dados genéricos da internet. Consultar fontes que já demonstraram parcialidade. Aumentar artificialmente o tamanho da amostra sem melhorar a qualidade. Todos esses métodos produzem resultados que parecem sólidos superficialmente mas colapsam sob análise crítica. A regra que me serviu melhor: documente tudo. Cada decisão sobre o que incluir ou excluir, cada fonte consultada, cada tentativa malsucedida. Isso não é burocracia — é a única forma de manter rastreabilidade quando alguém questionar os resultados. Em projetos recentes, essa documentação acabou sendo o diferencial entre uma conclusão rejeitada e uma aceita. O ciclo completo de diagnóstico e recuperação, do ponto de identificação dos problemas até a entrega dos dados tratados, leva normalmente de cinco a oito dias para projetos de médio porte. Projetos maiores demandam mais tempo proporcional. Mas o tempo gasto nessa fase preventiva economiza semanas de retrabalho e evitavereditos equivocados baseados em dados comprometidos.
Galeria
-
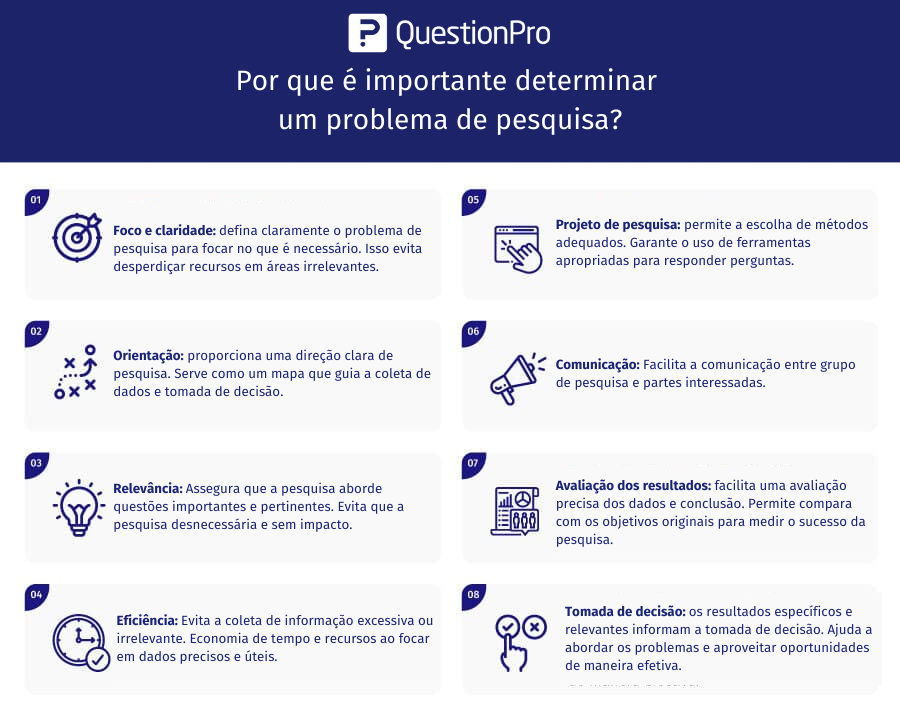
Problema de pesquisa: Tudo o que você precisa saber -
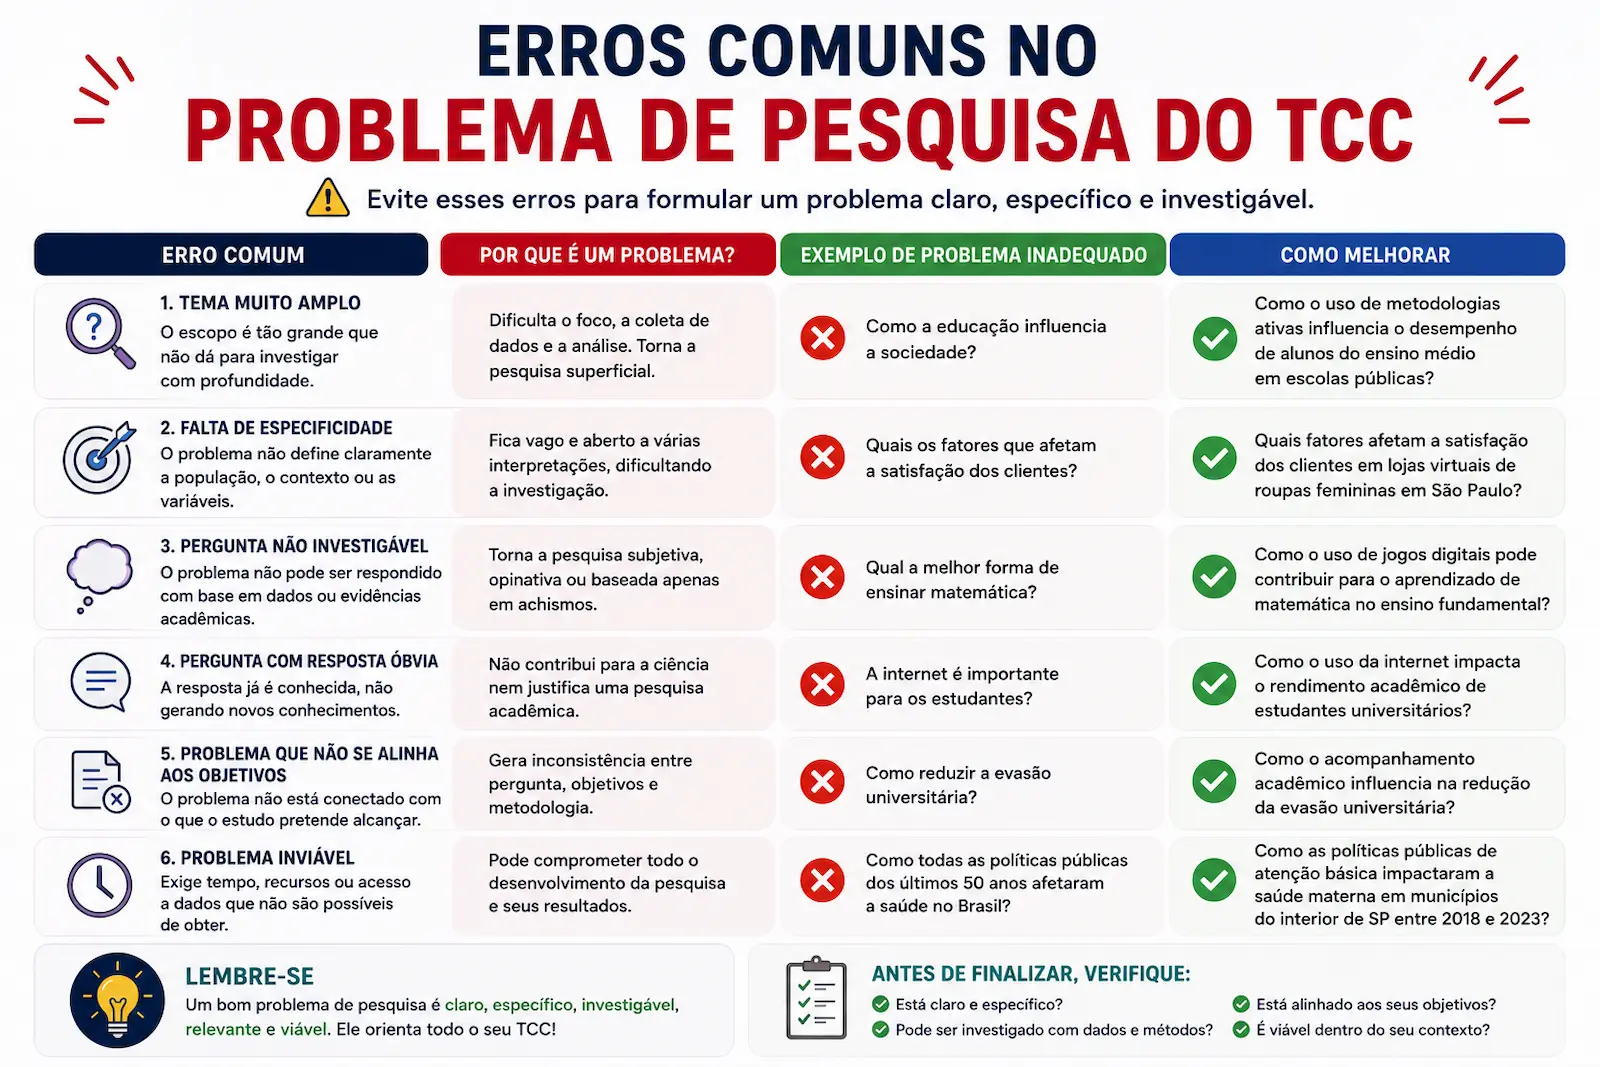
Como Fazer Problema de Pesquisa TCC: Guia Prático -

-Desafios ligados ao problema de pesquisa. | Download Scientific Diagram
