Http É O Protocolo Responsável Por Transmitir Hipertexto

Entendendo o protocolo HTTP na prática
A primeira vez que realmente entendi como o HTTP funciona não foi lendo documentação. Foi quando perdi seis horas de produção porque um servidor devolvia headers de cache incorretos e eu não sabia por onde começar a diagnosticar. Isso é comum. O protocolo parece simples até você precisar colocar a mão no código. O HTTP, ou Hypertext Transfer Protocol, é o mecanismo pelo qual navegadores e servidores se comunicam. Quando você digita uma URL e aperta Enter, seu navegador envia uma requisição estruturada que segue um formato bem definido. O servidor responde com dados e um código numérico que indica o que aconteceu. Isso acontece em milissegundos, mas cada passo tem nuances que só aparecem quando as coisas dão errado.
http é o protocolo responsável por transmitir hipertexto
O nome pode parecer óbvio, mas tem um detalhe que muita gente ignora. O HTTP não é apenas sobre transferir texto. Ele foi projetado para transportar qualquer tipo de dado, desde que embalado corretamente. HTML, JSON, imagens, vídeos, arquivos binários tudo passa pelo mesmo túnel. A diferença está nos headers, especificamente no Content-Type, que informa ao receptor como interpretar o conteúdo que veio junto com a resposta. Na prática, isso significa que você pode usar uma única API REST sobre HTTP para entregar respostas em formatos completamente diferentes. Um endpoint pode retornar JSON para uma aplicação e HTML para um navegador. O protocolo não se importa. Ele só carrega os bytes e confia nos headers para que a interpretação seja correta do outro lado. Aqui vai algo que os tutoriais não costumam enfatizar. O HTTP é stateless por definição. Cada requisição é independente. Não há memória entre uma conexão e outra. Isso é tanto uma vantagem quanto uma limitação. A vantagem é simplicidade e escalabilidade. Servidores podem processar milhares de conexões sem precisar rastrear o estado do usuário. A desvantagem é que toda a responsabilidade de manter sessões e contexto fica para cima, seja via cookies, tokens JWT ou armazenamento local do navegador.
Uma coisa que aprendi na pratica depois de meses lidando com falhas intermitentes em produção. O HTTP suporta pipelining, onde múltiplas requisições podem ser enviadas antes de receber respostas. Na teoria isso reduz latência. Na prática, a maioria dos servidores e intermediários modernos, incluindo proxies e CDN, ignoram ou quebram o pipelining. Se você depende disso para performance, pode estar criando um problema silencioso. A solução mais confiável hoje é usar HTTP/2 com multiplexação nativa ou HTTP/3 sobre QUIC. O HTTP/1.1 pipelined é uma armadilha disfarçada de otimização. Outro ponto que gera confusão constante. HTTP não é seguro por si só. A versão sem criptografia, a porta 80 padrão, transmite tudo em texto puro. Senhas, tokens, cookies, corpo de requisição nada disso é cifrado. Para ter segurança você precisa do HTTPS, que é basicamente o HTTP rodando sobre TLS. Muita gente ainda usa os termos como sinônimos, mas tecnicamente são camadas diferentes. O HTTP define a linguagem da comunicação. O TLS define o túnel seguro onde essa comunicação acontece. Eu já vi equipes inteiras perderem dias investigando vazamento de dados porque um proxy intermediário registrava headers de autenticação em logs acessíveis. A correção não foi mudar o protocolo. Foi configurar o proxy para não logar headers sensíveis e forçar HSTS em todos os subdomínios. HSTS, ou HTTP Strict Transport Security, é um header que diz ao navegador para nunca mais tentar conectar via HTTP não criptografado durante um período determinado. Parece simples, mas quase ninguém aplica corretamente em ambientes de desenvolvimento e isso gera testes falhos que passam para produção.

Se você quer entender de verdade como o HTTP funciona por baixo, a melhor coisa é parar de usar bibliotecas abstratas por um tempo. Abra um terminal, use curl ou um socket bruto, e construa uma requisição manual linha por linha. Veja o que acontece quando você omite o Host header. Teste o que ocorre com um método HTTP inválido. Envie um body quando o método espera que seja vazio. Esses exercícios revelam detalhes que a documentação nunca mostra. Há também a questão dos códigos de status, que as pessoas tratam como curiosidade mas são fundamentais para depuração. Um 401 significa que credenciais são necessárias. Um 403 significa que você está autenticado mas não tem permissão. A confusão entre esses dois códigos já causou bugs reais que eu corrigi. O servidor estava respondendo 403 para usuários não autenticados em vez de 401, e o front-end tratava isso como erro de permissão, mostrando uma mensagem errada para o usuário final. Correção levou vinte minutos, mas o diagnóstico levou duas horas porque o comportamento parecia correto superficialmente. Para quem precisa implementar algo do zero, a especificação oficial está no RFC 9110 e séries relacionadas. Não é leitura leve, mas é a fonte primária. Versões mais antigas como o RFC 7231 ainda são citadas com frequência, o que gera inconsistências em implementações. Se você estiver construindo um cliente ou servidor, leia o RFC mais recente e verifique se as bibliotecas que você usa o seguem. Muitos frameworks têm implementações parciais que não cobrem edge cases.
Uma alternativa ao HTTP tradicional quando performance e latência são críticos é o uso de protocolos como gRPC sobre HTTP/2 ou WebSocket para comunicação full-duplex. O gRPC é especialmente interessante para APIs internas onde você controla tanto o cliente quanto o servidor. Usa Protobuf para serialização, que é muito mais eficiente que JSON em tamanho e velocidade de parsing. WebSocket é o caminho certo quando você precisa de conexão persistente, como em chat, jogos ou dashboards em tempo real. O importante é entender que o HTTP é um protocolo maduro, mas não imutável. As versões mais recentes trouxeram melhorias reais de performance. O HTTP/2 reduziu a sobrecarga de cabeçalhos com compressão HPACK e permitiu streaming de resposta. O HTTP/3 migrou do TCP para QUIC sobre UDP, eliminando o problema de head-of-line blocking que ainda afeta o HTTP/2. Cada evolução resolve um problema específico que apareceu no uso real. Se você está começando agora, configure seu servidor para suportar pelo menos HTTP/2 e planeje a migração para HTTP/3 quando o ecossistema amadurecer mais. Para baixar ou estudar implementações de referência, o projeto caddyserver tem uma codebase limpa e bem documentada que mostra como construir um servidor HTTP moderno. O libcurl é essencial para entender clientes HTTP do zero. Ambos estão disponíveis gratuitamente e são usados em produção por milhares de sistemas. A documentação técnica deles é mais honesta que a maioria dos artigos que você vai encontrar pesquisando no Google.
Galeria
-
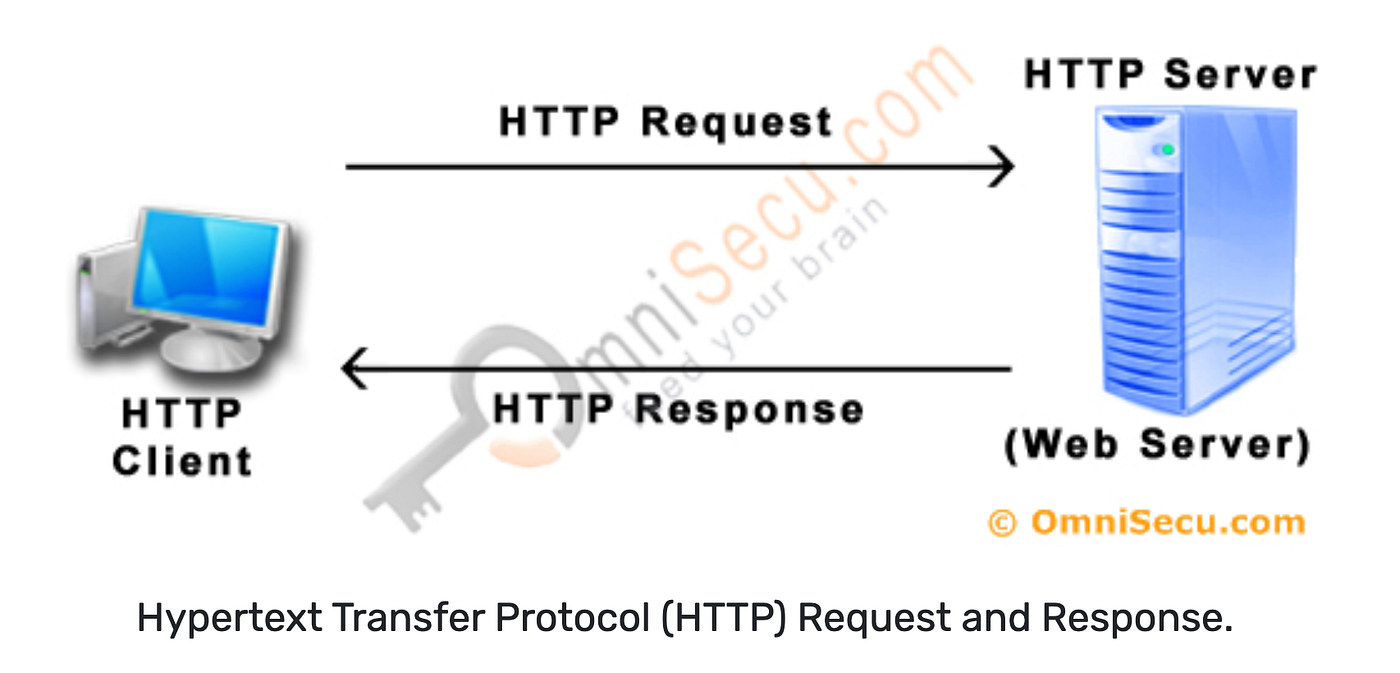
Protocolo Http HyperText Transfer Protocol | HTTP Tutorial | Gate -
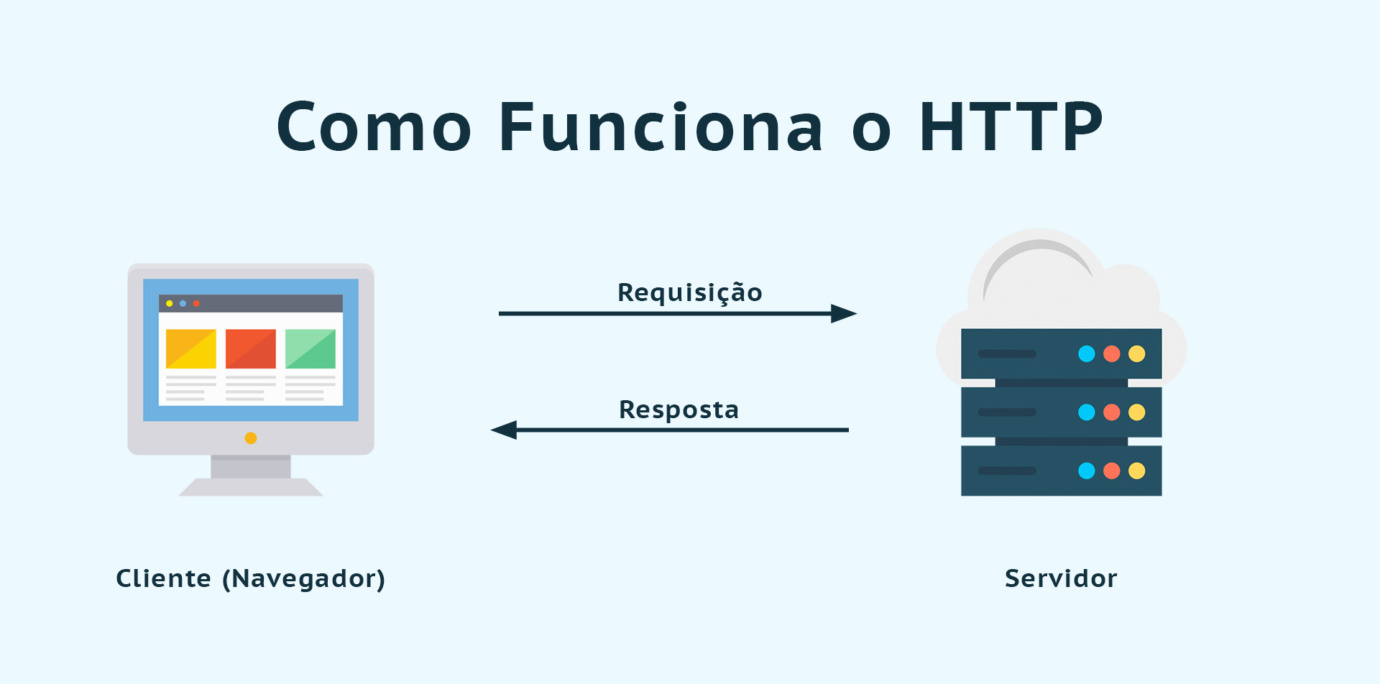
O que é HTTP? Saiba Tudo Sobre o Protocolo da Web - Melhores Hospedagem -
Protocolo HTTP -

Arquitetura Do Protocolo Http System Design Protocolos E

