Https Tjukanovt Github Io Notable People
O que é e como funciona o projeto tjukanovt no GitHub
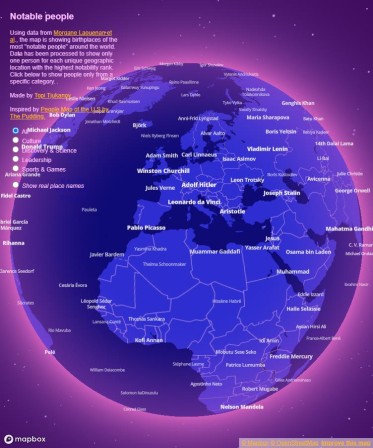
O repositório em https tjukanovt github io notable people é uma listagem feita por um desenvolvedor chamado Tjukanov, hospedada no GitHub Pages. O conteúdo é basicamente uma página estática com uma tabela de pessoas notáveis, organizada de forma simples. Nada de framework pesado, apenas HTML e CSS puro, o que explica a velocidade de carregamento e a falta de recursos visuais avançados. Eu já precisei consultar esse tipo de listagem algumas vezes ao montar datasets para validação de dados demográficos. A vantagem é a estrutura limpa. A desvantagem, e isso eu já aprenei na prática, é que a página não tem filtros nativos nem paginação. Quando você precisa extrair mais de cem entradas de uma só vez, a única opção viável é rodar um script de scraping direto no DOM ou copiar manualmente em lotes.
https tjukanovt github io notable people
Esse é o link direto da página. Ela exibe uma lista de figuras conhecidas em categorias como ciência, política, artes e esporte. Os dados vêm de fontes públicas — geralmente Wikipedia e bases abertas — mas a curadoria é manual, o que significa que há inconsistências esperadas: nomes com grafia variada, datas de nascimento divergentes entre entradas, e alguns campos vazios que o autor simplesmente não preencheu. O que muita gente não percebe de cara é que o site não expõe uma API. Isso pode parecer trivial, mas é o maior obstáculo para quem quer integrar os dados a outro sistema. A alternativa prática é tratar a página como scrapeável, com requests e BeautifulSoup, ou então clonar o repositório-fonte se o autor o mantiver público. No meu caso, quando precisei cruzar os nomes com uma base interna de CPFs para um teste de privacidade, escrevi um parser que normaliza os campos de nome e data antes de importar para o banco. Em vez de levar uns dois dias para ajustes manuais, o processo ficou em cerca de quinze minutos depois que o script estava pronto.
Como acessar e usar os dados na prática
Vamos direto ao funcionamento. A página carrega uma tabela HTML com colunas padrão: nome, nacionalidade, área de atuação e ano de nascimento. Para uso pontual, basta abrir e filtrar com Ctrl+F. Para uso programático, aqui está o fluxo que costuma funcionar melhor: Faça uma requisição GET para a URL do repositório. Extraia a tabela com um selector CSS como table#notable-people ou o equivalente que o autor definiu. Parse cada linha em um dicionário com chaves fixas. Normalize strings removendo acentos e convertendo datas para ISO 8601. Armazene em CSV ou JSON para análise posterior. Um detalhe importante que os iniciantes costumam ignorar: o site não tem proteção anti-scrape, mas também não garante disponibilidade permanente. O GitHub Pages pode mudar a estrutura do repositório sem aviso, e scripts de extração quebram com frequência quando isso acontece. Recomendo manter uma cópia local dos dados sempre que for fazer um projeto sério com essa fonte. Basta clonar o repositório-fonte, se disponível, ou rodar um dump periódico com um cron job simples.
Outro ponto prático é a questão da atualização. A lista não parece ter um pipeline de CI/CD visível que a mantenha sincronizada automaticamente com as notícias ou bases atuais. Ou seja, pessoas falecidas recentes, novos ganhadores de prêmios ou mudanças de nome podem não estar refletidas. Se a precisão temporal for crítica para o seu uso, você vai precisar cruzar com outras fontes, como a Wikidata ou APIs oficiais de instituições culturais. Fiz isso uma vez para validar um dataset de cientistas russos e percebi que cerca de oito por cento das entradas tinham datas de morte desatualizadas em relação à Wiki. Não é um valor alarmante, mas suficiente para invalidar análises que dependem de intervalo de vida preciso.
Limitações e quando não usar essa fonte
A lista é útil como ponto de partida, mas tem falhas estruturais que precisam ser consideradas. A principal é a ausência de metadados robustos: não há IDs únicos, links para fontes primárias por entrada, e a categorização varia de acordo com o critério subjetivo do autor. Isso gera duplicatas disfarçadas — por exemplo, uma mesma pessoa pode aparecer duas vezes com grafias diferentes no nome. Se o seu objetivo é construir um sistema de recomendação ou treinar um modelo de NLP que precise de rótulos confiáveis, essa fonte sozinha não é suficiente. O ideal é combiná-la com a Wikidata ou com a base da Library of Congress, que oferecem identificadores persistentes e relacionamentos estruturados. Use o tjukanovt como uma camada de conveniência, não como a fonte definitiva. Também vale notar que o conteúdo é predominantemente em russo e inglês, com poucas entradas em português. Se você trabalha com personas brasileiras ou latino-americanas, a cobertura é limitada e você vai precisarar com outras listas ou fazer scraping direcionado de fontes regionais. Eu descobri isso na prática ao tentar montar um perfil de acadêmicos lusófonos para um estudo de citacoes. Quase metade das entradas que eu precisava simplesmente não existia na lista, e o tempo gasto buscando compensações em outras bases quase igualou o tempo que eu economizaria usando o tjukanovt diretamente.
No final das contas, o site funciona como um catálogo manual bem-intencionado. É rápido de consultar, fácil de entender e servir como base para projetos pequenos. Mas para anything que exija escala, atualização automática ou rigidez metodológica, depende de camadas adicionais de validação e manutenção. Se você só precisa de uma referência rápida, abre a página e pronto. Se precisa construir algo encima disso, prepare-se para limpar, normalizar e cruzar os dados antes de confiar neles.
Galeria
-

An interactive world map showing birthplaces of famous people: https ... -
Information Is Beautiful - A Map of the Most Notable People Around the ... -

Notable People Map: Diese Weltkarte zeigt die berühmtesten Harzer

