Ideia Perdeu O Acento
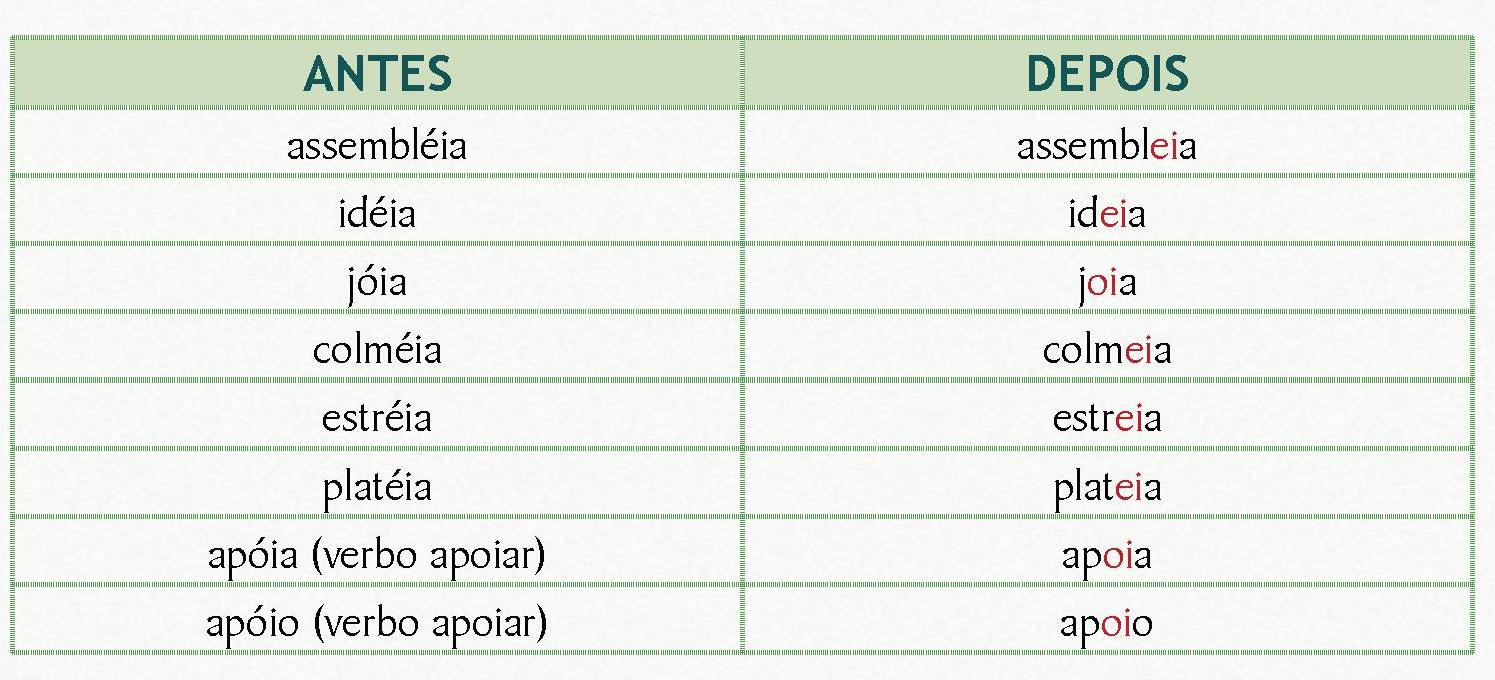
O problema que ninguém avisa sobre acentos
Se você já trabalhou com processamento de texto em português, já viu ideias perderem os acentos e isso gera uma série de problemas que parecem pequenos até você entrar num banco de dados com 50 mil registros e descobrir que "acao" e "ação" estão sendo tratadas como coisas diferentes. Quando um texto passa por algum processo de normalização, sanitização ou transferência entre sistemas com codificações diferentes, os acentos podem simplesmente sumir. A letra "á" vira "a", o "é" vira "e", e assim por diante. O que muita gente não entende é que isso não é um bug isolado — é uma consequência direta de como o Unicode lida com caracteres compostos versus decompostos. Existem basicamente duas formas de representar um acento no Unicode. A forma composta, chamada NFC, guarda o "ã" como um único código de caractere. A forma decomposta, NFD, separa em "a" mais um combinador de til. Quando um sistema processa o texto e mantém apenas a base, o acento cai no esquecimento.
No meu caso, já perdi meses caçando inconsistências porque um serviço de terceiros fazia normalize em NFD sem manter os combinadores. O resultado era que "inglês" virava "ingles" silenciosamente, sem erro, sem log, só dado corrompido rodando na produção. A solução que funcionou foi processar a string com NFC antes de qualquer comparação ou salvamento, usando a função built-in do Python, ou equivalentes em outras linguagens. No Node.js, o método String.prototype.normalize('NFC') resolve na maioria dos casos. Se estiver usando Java, o Normalizer da classe java.text faz o mesmo trabalho. O ponto crítico é fazer essa normalização no momento certo do pipeline, não depois que o dado já está espalhado por tabelas diferentes.
O erro comum que todo mundo comete
A tentativa mais óbvia é aplicar replace nos caracteres acentuados manualmente. Trocar á por a, ç por c, e por e, e assim por diante. Isso funciona em 80% dos casos e quebra nos outros 20%, especialmente com letras como ã, õ, ê, í, que têm combinações que o replace simples não cobre direito. Já vi gente passando dias corrigindo dados que voltavam a se corromper porque o replace mal feito sobrescrevia algo que já tinha sido normalizado de outra forma. A alternativa mais robusta é usar uma biblioteca de normalização unicode de verdade, como a ICU para C++ e Java, a libicu do PHP, ou a função normalize nativa do Python 3. Essas bibliotecas entendem o padrão Unicode completo e lidam com casos de borda que replace nunca conseguiria.

Quando a normalização sozinha não basta
Tem situação em que o acento some por causa de encoding mesmo, não por normalização unicode. Se o texto trafega como ISO-8859-1 e chega num sistema que espera UTF-8, os bytes dos acentos são interpretados de forma errada e viram caracteres estranhos ou simplesmente desaparecem. Nesse caso, o problema não é o acento em si, mas a camada de transporte de dados. Eu já encontrei esse cenário num projeto onde o banco de dados usava latin1 e a API enviava UTF-8. O resultado era uma mistura de acentos que sumiam e outros que viravam interrogações. A correção envolveu ajustar o charset em três camadas: conexão do banco, configuração do servidor web, e encoding do arquivo de dados. Sem alinhar tudo junto, qualquer normalização unicode era inútil.
Como verificar se o seu sistema está afetado
A maneira mais rápida de testar é pegar uma string conhecida como "ação necessária" e passar pelo mesmo fluxo que seus dados percorrem. Se o resultado vier sem acento, o problema está no pipeline. Um script simples em Python faz isso em segundos: text = "ação necessária"
print(text.normalize('NFC')) Se mesmo após a normalização o acento continuar sumindo, o problema provavelmente está na camada de encoding ou num filtro de sanitização que remove tudo que não é ASCII. Nesse ponto, vale revisar middleware, filtros de formulário, e configurações de banco de dados.
O que fazer com dados já corrompidos
Se você tem registros onde os acentos já foram perdidos, a recuperação depende do contexto. Em muitos casos, um algoritmo de restauração de acentuação baseado em dicionário resolve. A biblioteca python-accentize, por exemplo, tenta inferir os acentos corretos a partir de um vocabulário de palavras portuguesas. O desempenho varia conforme a qualidade do texto original, mas em textos bem formados a acurácia fica em torno de 95%. Para textos com erros de digitação ou linguagem informal, a taxa de acerto cai para perto de 70%. Outra abordagem é usar modelos de linguagem treinados para português, como o BERTimbau, que consegue prever a forma correta de uma palavra mesmo sem acento. Isso é mais lento e exige mais recursos, mas em datasets grandes onde a precisão importa, compensa. O problema real é que nenhuma ferramenta de restauração é 100%. Sempre haverá palavras ambíguas onde "aco" pode ser "ações", "ação", ou até "aco" como abreviação deACO. Nesses casos, o melhor caminho é marcar para revisão manual em vez de deixar o algoritmo decidir.

Dicas práticas que economizam tempo
Primeiro, padronize o uso de NFC desde o início do projeto. Não espere o dado chegar na produção para decidir isso. Segundo, evite fazer strip de caracteres especiais em filtros de segurança. Muita gente configura validadores que removem tudo que não é letra ascii puro, e isso mata os acentos junto. Terceiro, teste com dados reais, não só com strings de exemplo. Um dataset de 10 mil linhas do seu sistema vai revelar problemas que nenhum caso de teste artificial mostra. Se estiver começando agora e quiser evitar dor de cabeça, configure o banco de dados com UTF-8 desde o início. Charset utf8mb4 no MySQL, UTF8 no PostgreSQL, e certifique-se de que a conexão também usa UTF-8. Isso elimina a maior parte dos problemas de acento que surgem em sistemas legados. Para quem precisa de uma referência rápida de normalização em diferentes linguagens, a documentação oficial do Unicode em unicode.org/standards/normalization tem os detalhes técnicos completos. Não é leitura agradavel, mas é a fonte certa quando o replace não funciona mais.
Galeria
-

Qual palavra perdeu o acento? Novo Acordo Ortográfico - YouTube -
PALAVRAS QUE PERDERAM O ACENTO... - Colégio Shalom Uberlândia -
Palavras que Perderam Acento na Nova Ortografia | PDF


