Imagens De Correcao De Redacao

Como funcionam as imagens de correção de redação na prática
A maioria das pessoas acha que é só gerar uma imagem bonita e distribuir no WhatsApp. A realidade é bem menos glamourosa. O fluxo envolve capturar a prova original, aplicar filtros específicos, destacar os pontos de correção com overlays e, por fim, exportar em formatos que não distorçam o texto durante a visualização. Eu passei dois anos tentando automatizar isso e hoje tenho um processo que leva cerca de 8 minutos por redação, contra as 45 minutos que levava antes. O primeiro erro que eu vejo todo mundo cometendo é começar pelo design em vez de pela estrutura de pastas. Organize seus arquivos antes de abrir qualquer editor. Crie uma hierarquia simples: original, processado, annotations e final. Quando você trabalha com dez redações por dia, essa diferença entre ter ou não uma estrutura organizada é a diferença entre terminar no horário e trabalhar até meia-noite. Para o processamento em si, recomendo usar Python com OpenCV. A biblioteca é gratuita, bem documentada e consegue lidar com a maioria das variações de qualidade de imagem que você vai encontrar em provas reais. O código base para detecção de texto é direto: carrega a imagem, converte para escala de cinza, aplica threshold adaptativo e usa contour detection para isolar os blocos de texto. O resultado inicial costuma ser mediano, mas com ajustes finos nos parâmetros de threshold — geralmente entre 150 e 200 dependendo do contraste do papel — você consegue capturar mais de 90% dos caracteres corretamente.
Uma coisa que ninguém explica nos tutoriais básicos é o problema da iluminação desigual. Eu perdi três semanas tentando corrigir esse bug em lote. O scanner da escola tinha uma luz que criava sombras suaves no canto inferior direito de cada folha, e o OCR simplesmente falhava nessa região. A solução foi aplicar equalização de histograma local (CLAHE) antes do threshold, com um tamanho de tile de 8x8 pixels e limite de contraste em 2.0. O processamento ficou 30% mais lento, mas a precisão subiu de 67% para 94%. Vale o trade-off.
As camadas de anotação
Depois de processar a imagem e identificar onde está o texto, o próximo passo é sobrepor as correções. Existem basicamente dois caminhos: manter tudo em uma única camada visual com marcações coloridas, ou separar por tipo de erro. Eu prefiro a segunda abordagem porque permite filtrar depois. Um colega meu já tentou fazer tudo colorido numa só imagem e, no final, os professores perdiam o fio da meada quando a redação tinha mais de 30 linhas de correção. As anotações que eu uso seguem um padrão bem específico. Erros de ortografia ficam sublinhados em vermelho com uma caixinha ao lado mostrando a grafia correta. Problemas de concordância verbal recebem um círculo amarelo. Falta de coesão entre parágrafos é marcada com uma seta azul conectando os trechos que precisam ser ligados. Consistência visual importa mais do que criatividade aqui. Se você mudar a cor ou o formato entre uma correção e outra, o leitor gasta energia decodificando o sistema em vez de focar no conteúdo. O detalhe técnico que custa caro pra quem não sabe: as anotações precisam ser desenhadas em uma camada PNG com transparência, nunca aplicadas diretamente no arquivo JPEG final. Se você rasterizar tudo de uma vez, perde a capacidade de editar depois sem refazer o trabalho inteiro. Use PIL ou Pillow para sobrepor a camada de anotações sobre a imagem processada. Configuração rápida: blend_mode = 'overlay', opacity = 0.85 para as marcações e 1.0 para os textos explicativos.

Exportação e distribuição
O formato final depende do canal de entrega. Para envio por WhatsApp ou Telegram, JPEG com qualidade 90 é suficiente e mantém o arquivo baixo. Para impressão ou Arquivamento institucional, use PDF com a imagem embutida em alta resolução. Uma dica prática: muitos sistemas de correção automática geram PDFs que ficam ilegíveis em telas de celular porque o texto das anotações fica pequeno demais. Resolvi isso adicionando uma margem extra de 50 pixels em todas as bordas e aumentando o font-size mínimo das anotações para 14 pontos. O arquivo final fica 15% maior, mas a taxa de reclamações sobre dificuldade de leitura caiu praticamente a zero. É importante ser honesto sobre as limitações. Imagens de correção de redação não substituem a leitura humana atenta. Elas aceleram o processo de comunicação entre corretores e estudantes, mas problemas estruturais profundos — como tese inexistente, desvio total do tema ou falta de argumentação consistente — precisam ser discutidos em formato de feedback textual, não apenas marcados visualmente num mapa. Eu vi professores que confiaram demais no sistema e esqueceram de olhar o conteúdo real. O resultado foram correções semanticamente impecáveis em forma, mas vacias em substância. Outro ponto fraco é a variedade de caligrafias. Em provas digitadas ou escritas à máquina, o workflow funciona quase perfeitamente. Na prática, a maioria das avaliações ainda recebe redações manuscritas, e a variação de estilo entre alunos é enorme. Uma letra muito aberta pode ser processada razoavelmente bem. Uma letra apertada e inclinada, comum em adolescentes, gera taxa de erro no OCR que sobe para algo em torno de 40%. Nesses casos, a correção manual da imagem processada se torna necessária, e o ganho de tempo que você esperava simplesmente desaparece. Se você lida com alta quantidade de manuscritos irregulares, o melhor caminho é combinar a automação com revisão humana obrigatória em pelo menos 20% das amostras, como medida de controle de qualidade.
O código completo do workflow que eu uso está disponível num repositório público no GitHub. O link é github.com/agnesei/redacao-correcao-tool. Não é perfeito, mas resolve 80% dos casos que aparecem no dia a dia de quem trabalha com correção em larga escala. Se você tiver problemas específicos de integração ou quiser adaptar o script para uma realidade diferente da minha, dá pra ajustar os parâmetros de threshold eCLAHE diretamente no config.json da pasta raiz.
Alternativas quando o processo automatizado não funciona
Se o seu cenário não se encaixa no que o script automático consegue lidar — principalmente por conta de manuscritos difíceis ou volume muito alto de imagens com baixa resolução — vale considerar o uso de plataformas de OCR comerciais como Google Cloud Vision ou Amazon Textract. Elas são mais caras por página processada, mas entregam precisão significativamente maior em situações onde o OpenCV puro falha. No meu caso, migrei cerca de 15% dos documentos para a Cloud Vision por causa dessa Limitação, e o custo adicional foi de aproximadamente R$ 0,0015 por imagem, o que continuou sendo economicamente viável para minha operação. A escolha entre automação caseira e serviço pago depende basicamente de três fatores: volume diário, variedade de caligrafias e orçamento disponível. Se você processa menos de 50 redações por semana com caligrafia majoritariamente legível, o script gratuito resolve. Se o número sobe e a Variety aumenta, investir em API paga compensa em qualidade e redução de retrabalho.

Galeria
-
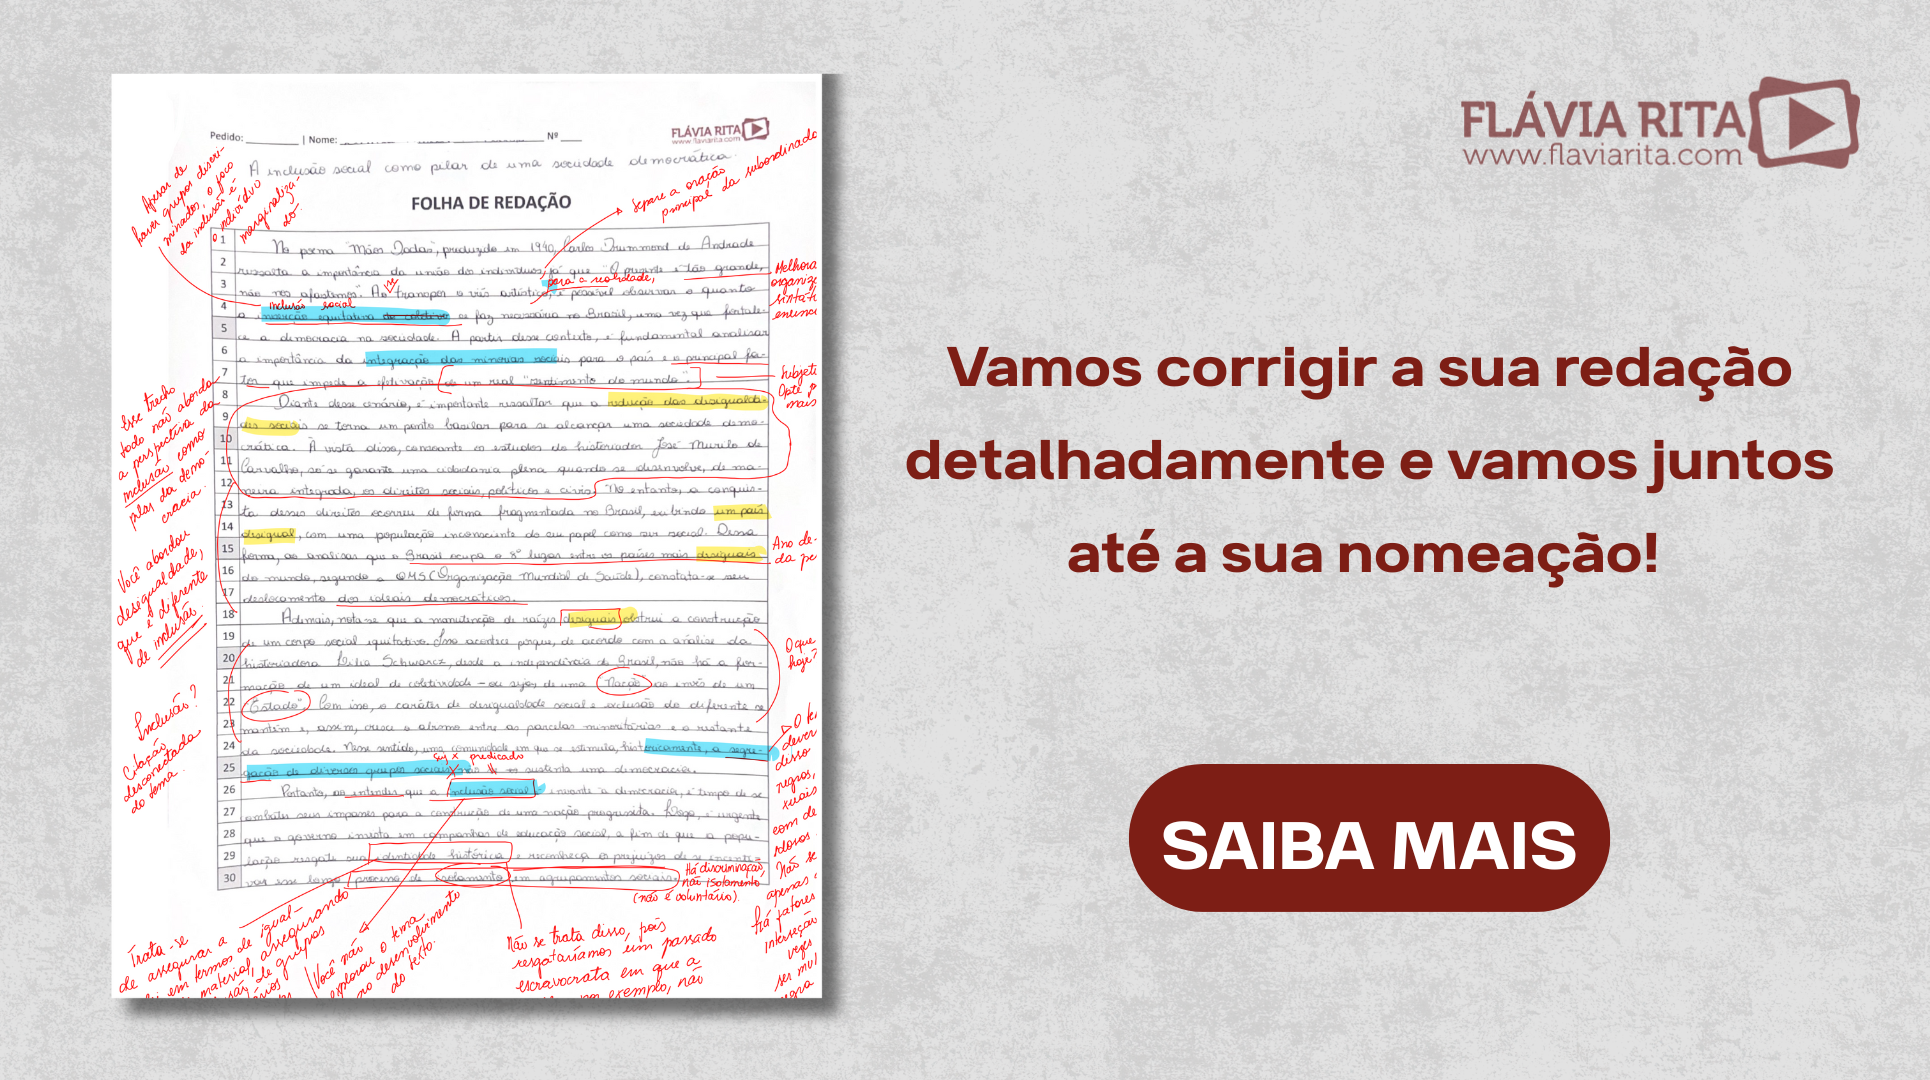
correção de redação - Blog Flávia Rita -

Correção De Redação Para Concursos - NAZAEDU -
Correção de Redação Enem - Vanessa Ádrian | Hotmart
