Imagens Para Texto
Como extrair texto de imagens de forma prática
A maioria das pessoas tenta usar uma ferramenta e fica na dúvida quando o resultado não fica bom. O problema raramente é o software em si. É a qualidade da imagem de entrada. Se o scanner ou a foto tem ruído, texturas inconsistentes ou perspectiva distorcida, nenhuma engine de OCR vai entregar um resultado limpo de primeira. O processo começa com a preparação da imagem. Converter para preto e branco, ajustar o contraste e endireitar a perspectiva são passos que a maioria das pessoas pula por preguiça, mas que fazem toda a diferença na precisão final.
Imagens para texto: como funciona na prática
A tecnologia por trás do imagens para texto chama-se OCR, reconhecimento óptico de caracteres. Existem duas abordagens principais: template matching, que compara padrões de pixels com fontes conhecidas, e deep learning, que usa redes neurais para identificar padrões de texto independentemente da fonte ou tamanho. Ferramentas como Tesseract, OCRmyPDF, Google Vision e Azure OCR são as mais citadas. Mas a diferença entre um resultado aceitável e um que funciona de verdade costuma estar no pré-processamento, não na escolha da engine. Eu já vi pessoas gastarem horas tentando melhorar o modelo quando o problema era uma imagem tremida ou mal iluminada. Um detalhe que poucos mencionam: a maioria das APIs gratuitas tem limites ridículos. O Google Cloud Vision oferece cerca de mil unidades grátis por mês. Uma imagem de um documento A4 em alta resolução pode consumir centenas dessas unidades. Se você processa muitos documentos, vale a pena considerar soluções self-hosted como PaddleOCR ou EasyOCR, que são gratuitas e rodam localmente.
Um problema real que enfrentei
Estava processando imagens de recibos antigos com fundo amarelado e tinta azul esmaecida. O Tesseract padrão transformava o texto azul em ruído ou simplesmente desaparecia. A solução foi aplicar CLAHE (Contrast Limited Adaptive Histogram Equalization) antes do OCR, ajustando o contraste localmente em vez de usar um limiar global. O resultado melhorou de 40% para cerca de 85% de precisão. Sem esse passo, o resto do pipeline era inútil. Sempre verifique a resolução. Abaixo de 150 DPI, os resultados ficam inconsistentes. Se a imagem estiver baixa resolução, use interpolação bicúbica ou até super-resolução com modelos como ESRGAN antes de processar. Documentos com múltiplas colunas ou tabelas são onde o OCR tradicional mais erra. Ele pode embaralhar a ordem do texto lendo linha por linha em vez de coluna por coluna. Use segmentação de região de interesse ou divisões manuais para forçar o processamento bloco por bloco.

O pós-processamento não é opcional. Correção ortográfica, validação contra dicionários e formatação de saída podem economizar horas de revisão manual. Scripts simples com Python e bibliotecas como PySpell ou autocorrect fazem uma diferença enorme em documentos longos.
Limitações que ninguém conta
Texto manuscrito ainda é um problema sério. Mesmo modelos de deep learning têm taxa de erro acima de 20% para caligrafia irregular. Em documentos históricos ou anotações à mão, a correção humana é inevitável. Não adianta insistir com OCR puro nesses casos. Documentos danificados, manchados ou muito antigos também desafiam qualquer ferramenta. Rasgos, desbotamento e sujeira criam artefatos que confundem os algoritmos. Às vezes, a melhor solução é restaurar a imagem primeiro com técnicas de processamento de imagem e só então aplicar OCR. Outro ponto importante: segurança. Enviar imagens para processamento em nuvem significa entregar dados para servidores de terceiros. Se os documentos contêm informações sensíveis, prefira soluções locais como Tesseract instalado na sua máquina ou PaddleOCR self-hosted.
Quando o OCR convencional não basta
Para formulários com campos variados e layouts complexos, ferramentas especializadas em extração de tabelas como Table Transformer ou DeepTable entregam resultados muito superiores. Elas entendem a estrutura e extraem não só o texto mas também a organização das células. Imagens com texto sobreposto a gráficos ou fotos também exigem abordagem diferente. Segmentar a imagem e processar cada região separadamente dá resultados muito melhores do que jogar a imagem inteira numa engine de OCR e torcer. O images para texto funciona bem quando você entende onde ele falha. Preparar a imagem corretamente, escolher a ferramenta certa para o tipo de documento e saber quando parar e pedir ajuda humana são as coisas que realmente fazem a diferença no dia a dia.
Galeria
-

Conversor de imagem para texto: transforme imagem em texto online | Canva -
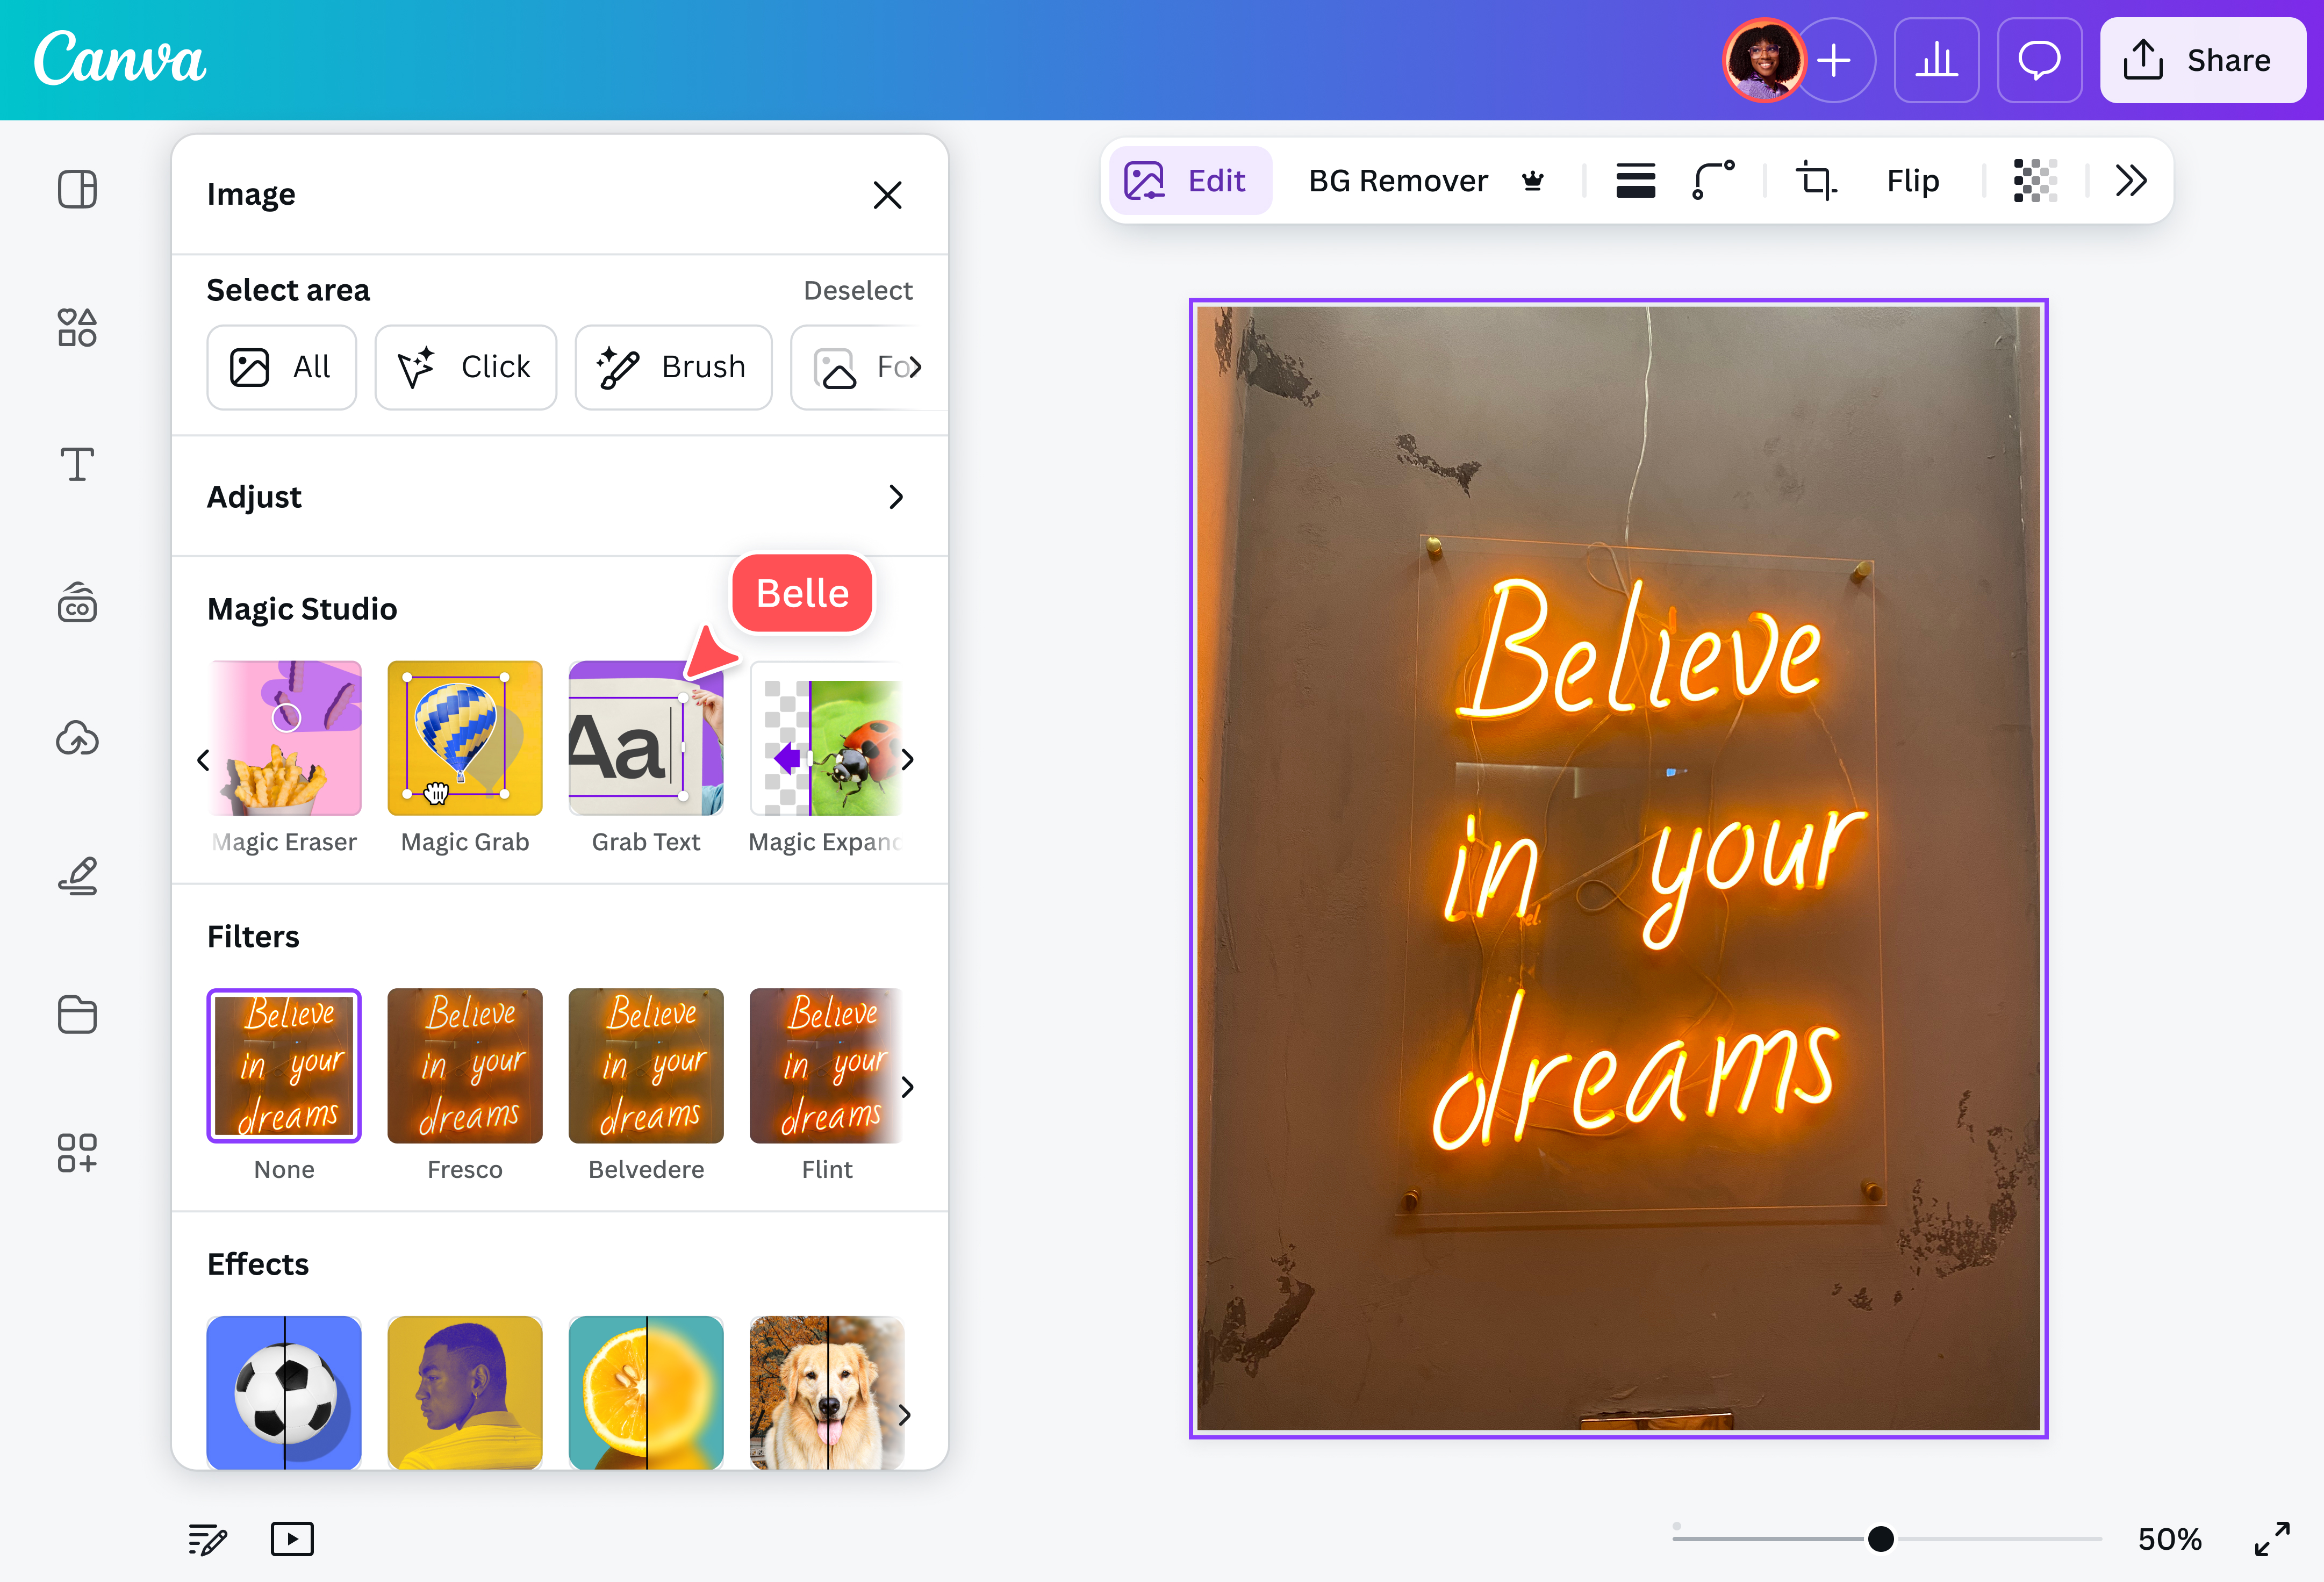
Conversor de imagem para texto: transforme imagem em texto online | Canva -
Conversor de imagem para texto: transforme imagem em texto online | Canva
