Indicadores Socioeconômicos Do Brasil

Como montar um painel de indicadores socioeconômicos do Brasil para análise prática
Você pega os dados, junta tudo numa planilha e descobre que metade das tabelas não conversam entre si. Isso é o ponto de partida real. Não adianta começar colecionando números sem saber exatamente o que quer responder com eles. O que eu costumo fazer primeiro é definir a pergunta de pesquisa. Isso parece óbvio, mas a maioria das pessoas pula essa etapa e entra direto na caça a dados. Quando eu sei que preciso analisar a evolução da desigualdade nas regiões nordestinas entre 2010 e 2023, por exemplo, eu já sei quais indicadores vou priorizar: taxa de Gini, rendimento médio nominal per capita, IDH-M por município, e a proporção de domicílios com acesso a saneamento básico. Se a pergunta for outra, os indicadores mudam completamente.
Indicadores socioeconômicos do Brasil: fontes principais e como acessá-las
As fontes oficiais se concentram em três lugares. PNAD Contínua do IBGE, que entrega dados trimestrais sobre trabalho, rendimento e condições de vida. Sistema de Informações sobre Orçamentos Públicos em Saúde (SIA SUS), do DATASUS, para indicadores de saúde. E a base de gastos sociais do Tesouro Nacional, que permite cruzar arrecadação com execução orçamentária por município. Eu começo sempre pelo IBGE. É a mais completa e a mais documentada. Direto na tabela mais interessante. A tabela permanente do PNAD com rendimentos e condições de vida fica em tabnet.ibge.gov.br. Lá você baixa os arquivos em .csv ou .ods, o que facilita muito o tratamento posterior. O dado bruto do Censo Demográfico de 2022 também está disponível no mesmo portal, na seção microdados. Se precisar de série histórica mais longa, o Censo de 2010 ainda é referência. Os dois são compatíveis em variáveis básicas como renda, educação e cor, mas há mudanças metodológicas que exigem ajuste se você for comparar as duas ondas.
Para dados de emprego, o Cadastro Central de Empresas (CAGED) do Ministério do Trabalho é essencial. Mostra aberturas e demissões mensais por setor e município. É um indicador de temperatura econômica muito mais ágil que o PIB, que só sai com trimestre atrasado. Você acha em dados.gov.br. Saúde fica no DATASUS. A tabela de mortalidade por causas, organizada pelo Sistema de Informações sobre Mortalidade (SIM), é atualizada todo mês. O ideal é baixar por CID-10, agrupar as causas em blocos relevantes e depois cruzar com dados populacionais do IBGE para calcular taxas padronizadas. Sem padronização por idade, você acaba distorcendo a leitura quando compara regiões com perfis demográficos diferentes. Tesouro Nacional disponibiliza os dados orçamentários em tesourotransparente.gov.br. A função por função orçamentária mostra quanto cada município gasta em saúde, educação, assistência social. Useful para quem quer medir esforço fiscal relativo, ou seja, a participação dos gastos sociais sobre a receita corrente líquida.

Eu tenho uma regra prática aqui: nunca usar apenas uma fonte. Dados do IBGE sobre pobreza podem apresentar números diferentes dos do MDS, porque cada um usa linha de pobreza distinta. O IBGE calcula com base na renda domiciliar per capita e na POF, enquanto o MDS emprega o CadÚnico com recorte de miserabilidade absoluta. Para análise comparativa, eu prefiro manter as fontes separadas e deixar claro nos notas de rodapé qual critério cada número segue. Misturar sem avisar gera confusão séria.
Tratamento dos dados e cruzamento técnico
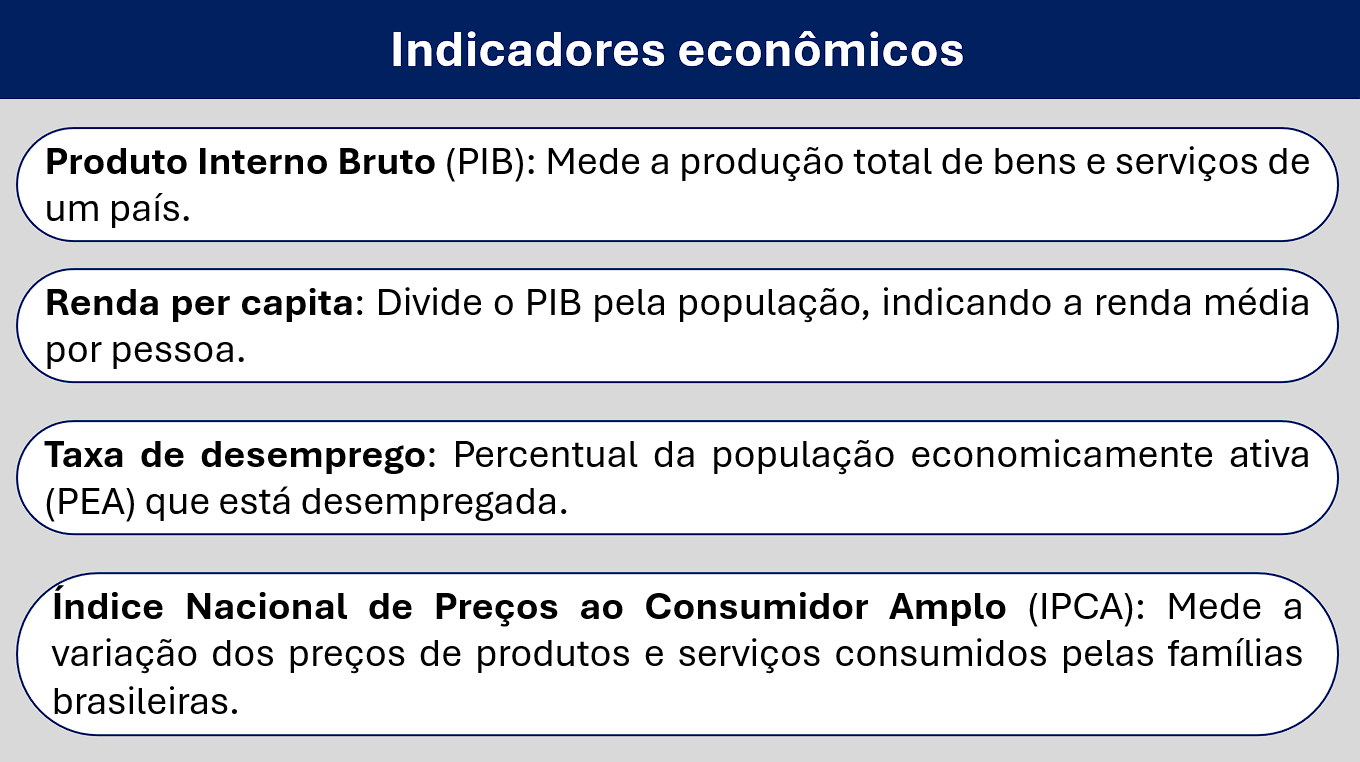
O maior problema que eu encontro na prática é a inconsistência espacial. Municípios mudam de nome, mudam de estado, alguns são extintos e outros surgem. Eu resolvo isso usando a tabela de equivalência do IBGE, que versiona as divisões territoriais de ano em ano. Você baixa o arquivo no site do IBGE mesmo, na seção sobre divisão territorial, e usa ele para harmonizar a base ao longo do tempo. Sem esse arquivo, você vai ter municípios que aparecem e desaparecem, e isso quebra qualquer série temporal. Depois da harmonização espacial, vem a padronização de grandezas. PIB por habitante precisa ser deflacionado. Eu uso o IPCA acumulado para transformar valores nominais em reais de um ano base, normalmente 2015 ou 2020, dependendo do período estudado. Isso elimina o efeito inflação e permite comparação temporal limpa. Um erro comum é comparar PIB nominal direto. Você termina dizendo que o Rio de Janeiro cresceu quando na verdade só houve correção monetária. No cruzamento de microdados, eu costumo usar Stata. O comando merge com opção de fuzzy match funciona bem para vincular dados do Censo a informações do CadÚnico, desde que se use código do município do IBGE como chave. Há casos em que o código não bate e o merge falha. Nesses momentos, eu recorro ao nome do município e ao estado como backup. Ainda assim, o ideal é evitar fuzzy match sempre que possível, porque ele introduz ambiguidade. Se tiver apenas 2 por cento dos registros não vinculados, é aceitável. Se passar de 10 por cento, revê a lógica de junção.
Outro ponto que muitas pessoas deixam passar: a definição de domicílio no PNAD. O IBGE considera como rendimento do domicílio a soma de todos os rendimentos dos moradores. Isso significa que um domicílio com três pessoas desempregadas mas com um aposentado recebendo benefícios pode aparecer com rendimento acima da linha de pobreza, mesmo que os desocupados estejam em situação de vulnerabilidade. Se seu foco é pobreza intradomiciliar, precisa desagregar para pessoa, não ficar só no agregado. Eu monto uma cópia do banco original antes de qualquer transformação. Isso economiza horas de retrabalho quando algo dá errado no processamento. A cópia fica em um diretório chamado dados/bruto/, e o resultado tratado vai para dados/limpo/. Parece bobagem, mas já vi gente perder uma semana inteira porque alterou a base sem backup.

Construção de indicadores compostos
Quando você precisa resumir múltiplas dimensões num único número, recorre a indicadores compostos. O IDH-M do PNUD é o exemplo mais conhecido. Ele combina esperança de vida, escolaridade e rendimento. O cálculo padrão normaliza cada dimensão entre zero e um, aplica pesos iguais e faz a média geométrica. O IBGE publica o IDH-M municipal todo ano, então não precisa refazer a conta se estiver usando os dados oficiais. Se quiser construir seu próprio indicador, comece escolhendo as dimensões relevantes. Desigualdade, pobreza, acesso a serviços básicos, emprego e segurança alimentar são os mais comuns. Depois normalize cada variável. A normalização por z-score é a mais simples, mas tem o problema de ser sensível a outliers. Uma alternativa mais robusta é a normalização min-max, que coloca tudo entre zero e um com base nos valores observados na amostra. A escolha dos pesos é onde a análise vira julgamento político. Peso igual é o padrão conservador. Se você acha que educação é mais importante que renda, pode dar um peso maior. O problema é que qualquer peso que você atribuir vai ser questionado. A solução prática é fazer sensibilidade: rodar o indicador com pesos alternados e ver se a classificação dos municípios muda drasticamente. Se mudar pouco, o indicador é robusto. Se mudar muito, você precisa explicar no artigo por que aquele conjunto de pesos é mais adequado.
Um detalhe técnico que ninguém comenta: a escalonamento de variáveis com distribuição assimétrica exige transformação logarítmica antes de normalizar. Renda domiciliar per capita no Brasil tem cauda longa muito forte. Sem log, os municípios ricos dominam a variância e empurram todos os outros para perto de zero. Aplicar log(1 + valor) resolve isso na maior parte dos casos.
Interpretação e armadilhas comuns
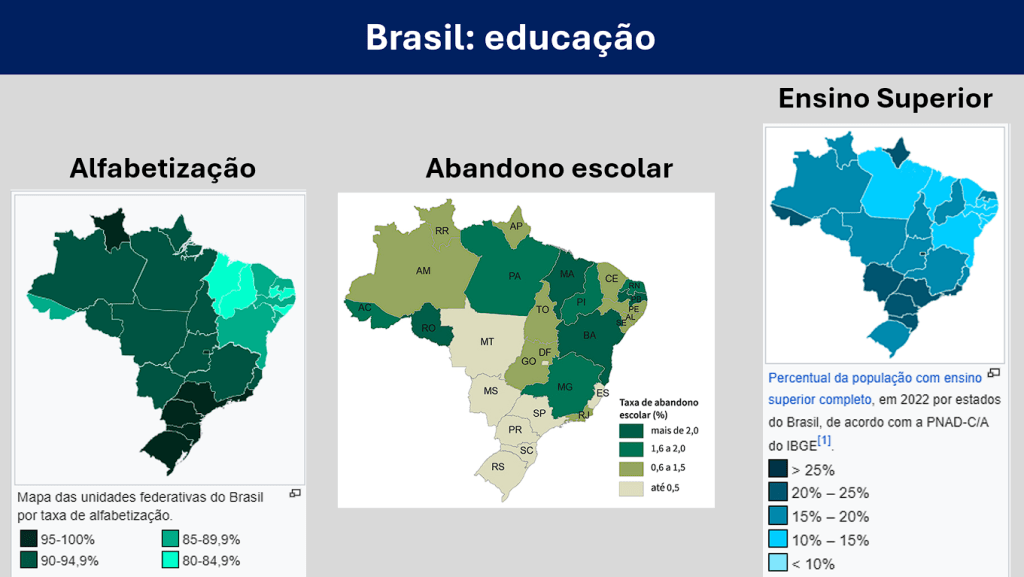
A principal armadilha é confundir correlação com causalidade. Se um município tem alto IDH-M e baixo crime, isso não significa que o IDH reduziu a criminalidade. Pode ser que municípios mais ricos atraiam mais recursos de segurança pública, ou que a estrutura produtiva seja diferente. Sempre controle por variáveis de contexto quando fizer regressões. Tamanho populacional, densidade demográfica, participação do setor primário na economia e distância até capitais são controles básicos que costumam capturar muita variância. Outra armadilha frequente é usar dados municipais quando o fenômeno observado é estadual ou federal. O salário mínimo varia por lei federal. Políticas de transferência de renda são federais. Se você quer analisar impacto de políticas públicas, precisa considerar o nível de governança adequado. Dados municipais isolados podem parecer convincentes, mas escondem efeitos de escala. Existem ainda problemas de subnotificação. Em regiões com maior informalidade, a renda declarada no PNAD tende a ser subestimada. O IBGE tenta corrigir isso com fatores de ajuste, mas a correção não é perfeita. Se seu estudo foca em populações de baixa renda em áreas rurais, leve isso em conta e apresente margem de erro quando for o caso.
Por fim, a sazonalidade dos dados econômicos. O CAGED tem flutuação forte no período de férias e no Natal. Se você estiver analisando tendência de emprego, use média móvel de três meses ou diferenças sazonais para remover o ruído. Caso contrário, picos e quedas aparentes podem levar a conclusões equivocadas sobre a dinâmica do mercado de trabalho. A coisa mais importante é anotar cada decisão metodológica. Qual fonte, qual Ano-base, qual tratamento de missing, qual normalização. Quem lê seu trabalho precisa conseguir reproduzir cada passo. Documentação ruim é o que mais gera retrabalho e perda de credibilidade.
Galeria
-
7. Brasil – indicadores socioeconômicos – ciências humanas e sociais ... -
7. Brasil – indicadores socioeconômicos – ciências humanas e sociais ...
