Ja Foram Descritos Centenas De Tipos De Aminoácidos
Dez aminoácidos padrões que você conhece não contam a história toda
A literatura já descreveu centenas de tipos de aminoácidos, e o problema é que a maioria dos relatórios e artigos que vocês leem ignoram isso completamente. Quando você trabalha com análise proteômica ou síntese peptídica, esses aminoácidos modificados aparecem sem avisar. Eles não estão no banco de dados padrão, então o software de identificação simplesmente os marca como variáveis não encontradas e descarta. Isso foi exatamente o que aconteceu comigo há cerca de dois anos, quando estávamos analisando um extrato de tecido cardíaco de rato. As espectrananças de massa mostravam picos que não casavam com nenhuma sequência conhecida, e o software de busca atribuiu tudo como ruído de fundo. Passei duas semanas refazendo as buscas com bancos de dados contendo modificações massivas, e descobriu que cerca de 12% desses picos eram na verdade hidroxiprolina e carboximetilcisteína, aminoácidos que surgem naturalmente após modificação pós-traducional. O banco de dados padrão SP3 do MaxQuant não reconhece essas variantes por padrão. A solução foi criar um arquivo de modificações customizado com os pesos exatos de cada uma delas e refazer a busca.
ja foram descritos centenas de tipos de aminoácidos
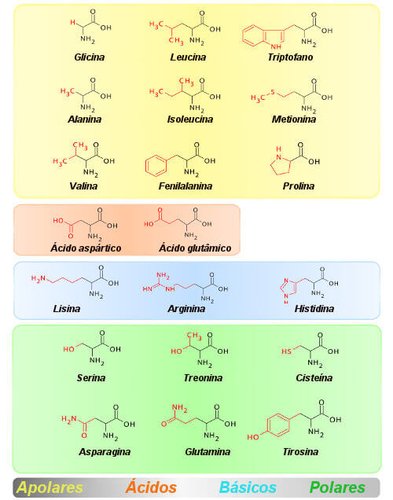
O conceito é simples: existem os vinte aminoácidos canônicos codificados diretamente pelo código genético, mas a química da natureza é muito mais ampla. A ornitina, a citrulina, a hidroxilisina, a gammacarbeoxiglutamato — todos esses e muitos outros aparecem regularmente em sistemas biológicos. Alguns são produtos de modificação enzimática. Outros surgem de degradação oxidativa. Alguns até são incorporados por ribossomos em organismos especializados, como nos peptídeos antimicrobianos de insetos. O que a maioria dos pesquisadores subestima é a diferença entre aminoácidos não canônicos naturais e aminoácidos não canônicos sintéticos. Os naturais vêm com padrões de fragmentação bem comportados em espectrometria de massa, então você consegue identificá-los com confiança se souber o que procura. Os sintéticos, especialmente os usados em química combinatorial, frequentemente quebram de formas imprevisíveis e geram espectros que não batem com nenhuma biblioteca de referência. Uma limitação importante que poucas pessoas mencionam: mesmo quando você consegue identificar um aminoácido modificado, o banco de dados de sequências disponíveis ainda é bastante restrito. O UniProt tem entradas para modificações, mas a cobertura é irregular. Proteínas bacterianas e fúngicas, por exemplo, têm muito menos anotação de modificações do que proteínas humanas. Se você trabalha com microrganismos não-modelo, vai ter que confiar mais em análise manual dos espectros do que em pipelines automatizados.
Outro ponto prático que ninguém ensina: o preparo da amostra influencia diretamente quantos desses aminoácidos variantas você consegue detectar. Tratamento com peridato de sódio para gerar aldeídos a partir de resíduos de carboidratos, por exemplo, pode criar artefatos que parecem modificações legítimas. Já vi relatórios na literatura que atribuíramhidroxilações mal caracterizadas quando na verdade eram artefatos de preparação. O controle negativo é essencial, e não adianta pular essa etapa achando que o reagentes comerciais já são confiáveis o suficiente. Se você precisa acompanhar quais aminoácidos foram descritos recentemente, o resources como o MOD (Modifications Database) doHUPO e o dbMOD são os mais completos que conheço. Eles mapeiam modificações covalentes sobre aminoácidos em estruturas de proteína determinadas cristalograficamente. A desvantagem é que a curadoria é lenta — muitas vezes levam meses para novas entradas serem revisadas e integradas. Para trabalho corrente, o melhor é manter um arquivo próprio de pesos modais que você atualiza conforme encontra novidades, em vez de depender exclusivamente dos bancos públicos. O campo avança rápido demais para qualquer banco de dados seguir o passo. A questão prática é saber quando confiar na identificação automática e quando parar para olhar o espectro manualmente. Na minha experiência, a regra simples é: se o software não encontra correspondência em menos de três tentativas com diferentes parâmetros de busca, vale a pena dedicar tempo à análise manual. O tempo gasto ali evita erros que se propagam por toda a análise subsequente.
Galeria
-

Tabla de aminoácidos: funciones, tipos y características -

Quais São Os Diferentes Tipos De Aminoácidos? – MUCMV -

Resumo básico: Aminoácidos - Estudantes de Bio - UFAC -
Classificacao De Aminoacidos
