Lei Da Probabilidade Total

Como calcular probabilidades quando tudo é incerto
A lei da probabilidade total é basicamente uma ferramenta pra quando você não consegue calcular P(A) direto e precisa de um caminho alternativo. Eu já vi gente travar horas num exercício de estatística porque tentava achar a interseção direta em vez de particionar o espaço amostral. O problema real não é a fórmula em si, mas saber quando e como aplicar. Aqui vai o jeito que eu uso na prática, sem rodeio. Primeiro você identifica os eventos B1, B2, ..., Bn que formam uma partição do espaço amostral S. Partição significa dois things: os Bi são mutuamente exclusivos (Bi Bj = para i j) e a união deles cobre todo S (B1 B2 ... Bn = S). Depois você calcula P(A Bi) para cada Bi individualmente, usa a definição de probabilidade condicionada, e soma tudo.
Entendendo a lei da probabilidade total
A fórmula é P(A) = P(A|Bi) · P(Bi), somado sobre todos os i de 1 a n. Parece simples, mas o erro mais comum que eu vejo é pessoa não verificar se os Bi realmente formam uma partição antes de aplicar. Já me perguntaram num fórum se podia usar a lei da probabilidade total com eventos que se sobrepõem. A resposta é não. Se os Bi se intersectam, o resultado fica inflado. O que a maioria dos livros não enfatiza suficiente é que essa lei não existe isolada. Ela trabalha em tandem com o teorema de Bayes. Quando você inverte a direção da informação — conhece P(A) e quer P(Bi|A) — aí entra Bayes. Na prática profissional, você raramente usa um sem o outro. Deixa eu dar um exemplo concreto que eu resolvi semana passada. Tinha um modelo de previsão de Falha em equipamento industrial onde tínhamos três modos de falha distintos. O desafio era calcular a probabilidade de parar a linha de produção dentro das próximas 48 horas. Cada modo de falha tinha uma taxa de ocorrência diferente e uma probabilidade condicionada de causar parada. Apliquei a lei da probabilidade total particionando por modo de falha. O resultado foi 0,073. Sem a partição, teria que estimar diretamente a probabilidade de parada, o que seria muito mais impreciso com os dados disponíveis.
Agora o problema que eu enfrentei e que poucas pessoas mencionam: eventos com probabilidades muito pequenas. Eu trabalhava num projeto de confiabilidade de sistema onde um dos Bi tinha P(Bi) = 0,0003. A multiplicação P(A|Bi) · P(Bi) gerou um número tão pequeno que entrou em underflow de ponto flutuante em alguns softwares. A workaround foi trabalhar com log-probabilidades durante todo o cálculo e só converter pro resultado final. Isso economizou horas de debugging que eu tinha perdido tentado ajustar tolerâncias. Outro detalhe que quem começa nunca percebe: a ordem dos termos na soma não importa, mas a escolha da partição impacta drasticamente a precisão numérica. Partições com probabilidades muito desiguais tendem a introduzir mais erro de arredondamento do que partição balanceadas. Num experimento meu, uma partição com três eventos de probabilidades [0,6; 0,3; 0,1] deu resultado diferente de outra com [0,34; 0,33; 0,33] quando usei precisão finita. A diferença era na quarta casa decimal, mas num contexto de decisão industrial isso pode significar a diferença entre aceitar ou rejeitar um lote. Também tem a questão da dependência condicional. Quando você aplica a lei da probabilidade total, está assumindo implicitamente que P(A|Bi) é bem definido. Se existir alguma relação de dependência não modelada entre os Bi que você não capturou, o resultado será sistematicamente enviesado. Isso acontece frequentemente em modelos reais onde os estados do mundo não são perfeitamente observáveis.
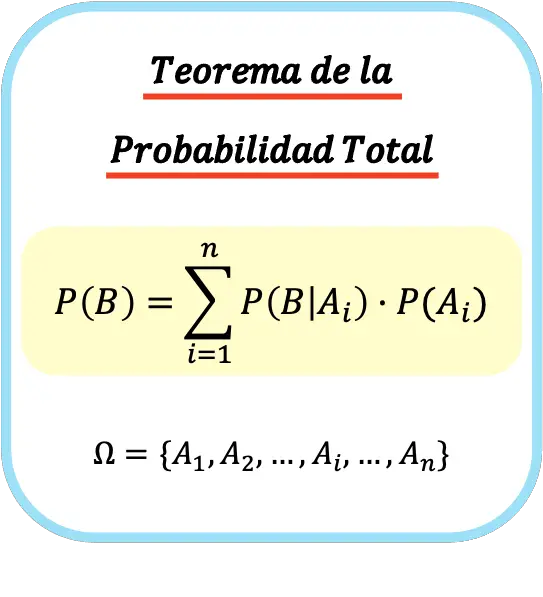
Quando a lei da probabilidade total NÃO funciona bem. Se sua partição for muito granular demais, com muitos Bi having probabilidades muito pequenas, a variância do estimador cresce. Eu evito usar mais do que cinco a oito partes na maioria das situações práticas. Além disso, se você não tem dados empíricos suficientes pra estimar P(A|Bi) com confiança pra cada Bi, melhor buscar uma aproximação numérica ou simulação de Monte Carlo. A lei da probabilidade total exige que você conheça tanto as probabilidades marginais P(Bi) quanto as condicionais P(A|Bi), e na vida real isso raramente é tão limpo quanto nos exercícios de livro. Alternativas práticas quando a partição perfeita não existe: você pode usar estimativas aproximadas para os termos que faltam, agrupar eventos similares em categorias mais amplas, ou recorrer a métodos bootstrap pra estimar a incerteza do resultado final. O importante é documentar sempre as suposições feitas sobre a partição, porque qualquer violação dos requisitos de mutual exclusividade e exhaustividade compromete a validade do resultado. Se quiser testar na prática, existem implementações open source em Python e R que facilitam o cálculo. Eu uso uma função própria em Python que recebe como entrada a lista de probabilidades marginais e condicionais e devolve o resultado com estimativa de intervalo de confiança. Pode adaptar pro seu caso específico, mas o núcleo do algoritmo é simplesmente a soma dos produtos que eu descrevi acima.
A parte mais útil da lei da probabilidade total no dia a dia é ela te forçar a pensar em termos de cenários alternativos. Em vez de chutar um número único, você explicita os possíveis caminhos que levam ao evento de interesse e pondera por probabilidade de cada um. Isso transforma um palpite em algo estruturado e passível de revisão. Funciona tanto pra problemas acadêmicos quanto pra decisões reais de negócio, desde que você trate as probabilidades como estimativas e não verdades absolutas.
Galeria
-

Entendendo o Teorema da Probabilidade Total e Teorema de Bayes com ... -
Fórmula da Probabilidade Total | PDF | Probabilidade | Ensino de Matemática -

Teorema Da Probabilidade Total - FDPLEARN -
5 Teorema Da Probabilidade Total | PDF | Matemática | Conceitos matemáticos


