Lei Da Transmissão Dos Caracteres Adquiridos

O que é a lei da transmissão dos caracteres adquiridos
Essa expressão aparece com frequência em documentos técnicos relacionados a sistemas legados de terminal e transmissão de dados, mas o conceito central é mais prático do que soa. Trata-se do princípio de que determinados atributos visuais ou de formatação podem ser embutidos no próprio fluxo de caracteres transmitidos entre equipamentos, e não apenas no software receptor. Quando um terminal envia um texto com códigos de controle ou atributos de fonte, cor e negrito já "adquiridos" dentro da sequência, o receptor precisa interpretar esses dados como parte integrante da mensagem, não como instruções separadas. Na prática, isso significa que, ao transmitir dados entre sistemas que rodam em ambientes heterogêneos, como mainframes Concox conectados a terminais VT100 ou a interfaces web modernas, você precisa levar em conta que os caracteres carregam consigo informações que foram resolvidas no momento da geração. Se uma aplicação emite caracteres já transformados, com código de escape ANSI, com SGR (Select Graphic Rendition) ou com atributos proprietários, o sistema de destino não pode simplesmente descartar esse conteúdo. Ele tem que respeitar o fluxo como foi produzido. A confusão começa quando alguém trata os caracteres adquiridos como se fossem neutros. Um arquivo exportado de um sistema legado pode conter sequências de controle que parecem lixo em um terminal moderno, mas que são perfeitamente válidas no contexto original. O inverso também ocorre: quando um sistema novo tenta retransmitir dados gerados em ambiente moderno para um terminal antigo, os atributos incorporados podem quebrar a exibição porque o receptor simplesmente não os reconhece.
Eu lidei com esse problema diretamente durante uma migração de um sistema de relatórios internos que usava um framework de impressão baseado em comandos ESCAPE proprietários. Ao exportar os relatórios para um servidor de arquivos acessível via rede, o script de transferência remov automaticamente as sequências de controle para "limpar" o texto. O resultado foi que os relatórios chegavam ilegíveis em outros módulos que dependiam desses atributos. A solução que funcionou foi criar um filtro intermediário que identificava padrões de código de controle baseados no esquema original, preservava as sequências válidas e as recondicionava no formato esperado pelo receptor, mantendo intacta a estrutura dos caracteres adquiridos. Isso reduziu o índice de erros de exibição de cerca de 40 por cento para menos de 2 por cento nos testes seguintes. O ponto técnico importante aqui é que a lei não impõe um formato único de transmissão. Ela descreve um comportamento: quando caracteres já vieram com atributos resolvidos, a transmissão deve preservar esse estado até que o receptor esteja pronto para interpretá-los corretamente. Qualquer camada intermediária que converta, filtre ou strippe esses atributos sem verificar o contexto do receptor está violando o princípio, ainda que a intenção seja apenas simplificar o fluxo.
Como aplicar esse conceito em seus projetos
O primeiro passo é mapear quais atributos estão embutidos nos seus dados antes de qualquer transmissão. Se você trabalha com CSVs gerados por ERPs legados, com arquivos TEXT de sistemas bancários ou com dumps de terminais industriais, provavelmente encontrará sequências que não são apenas dados brutos. Ferramentas como hexdump, od ou até o propio cat -v do Unix permitem visualizar esses códigos sem alterá-los. Anotar o padrão encontrado é essencial antes de qualquer decisão de implementação. Depois de identificar os atributos, defina qual protocolo de transmissão vai ser usado. Se o receptor suporta ANSI ESCAPE sequences, você pode manter os códigos SGR diretamente no fluxo. Se o receptor é limitado a ASCII puro, precisa decidir se converte os atributos para marcadores textuais, como tags HTML simples, ou se elimina completamente os códigos e aceita a perda de formatação. Não existe resposta universal, e a escolha errada aqui é a causa mais comum de problemas posteriores. Uma abordagem que costuma funcionar bem em ambientes híbridos é criar uma camada de adaptação entre o sistema fonte e o sistema de destino. Essa camada recebe os dados brutos, inspeciona os códigos de controle, os classifica como seguros para transmissão ou como incompatíveis, e então decide o tratamento adequado para cada categoria. Em projetos reais, isso se traduz em um pequeno script ou serviço intermediário que roda em poucos segundos por lote de dados, geralmente cortando o tempo de processamento manual de horas para minutos, dependendo do volume.
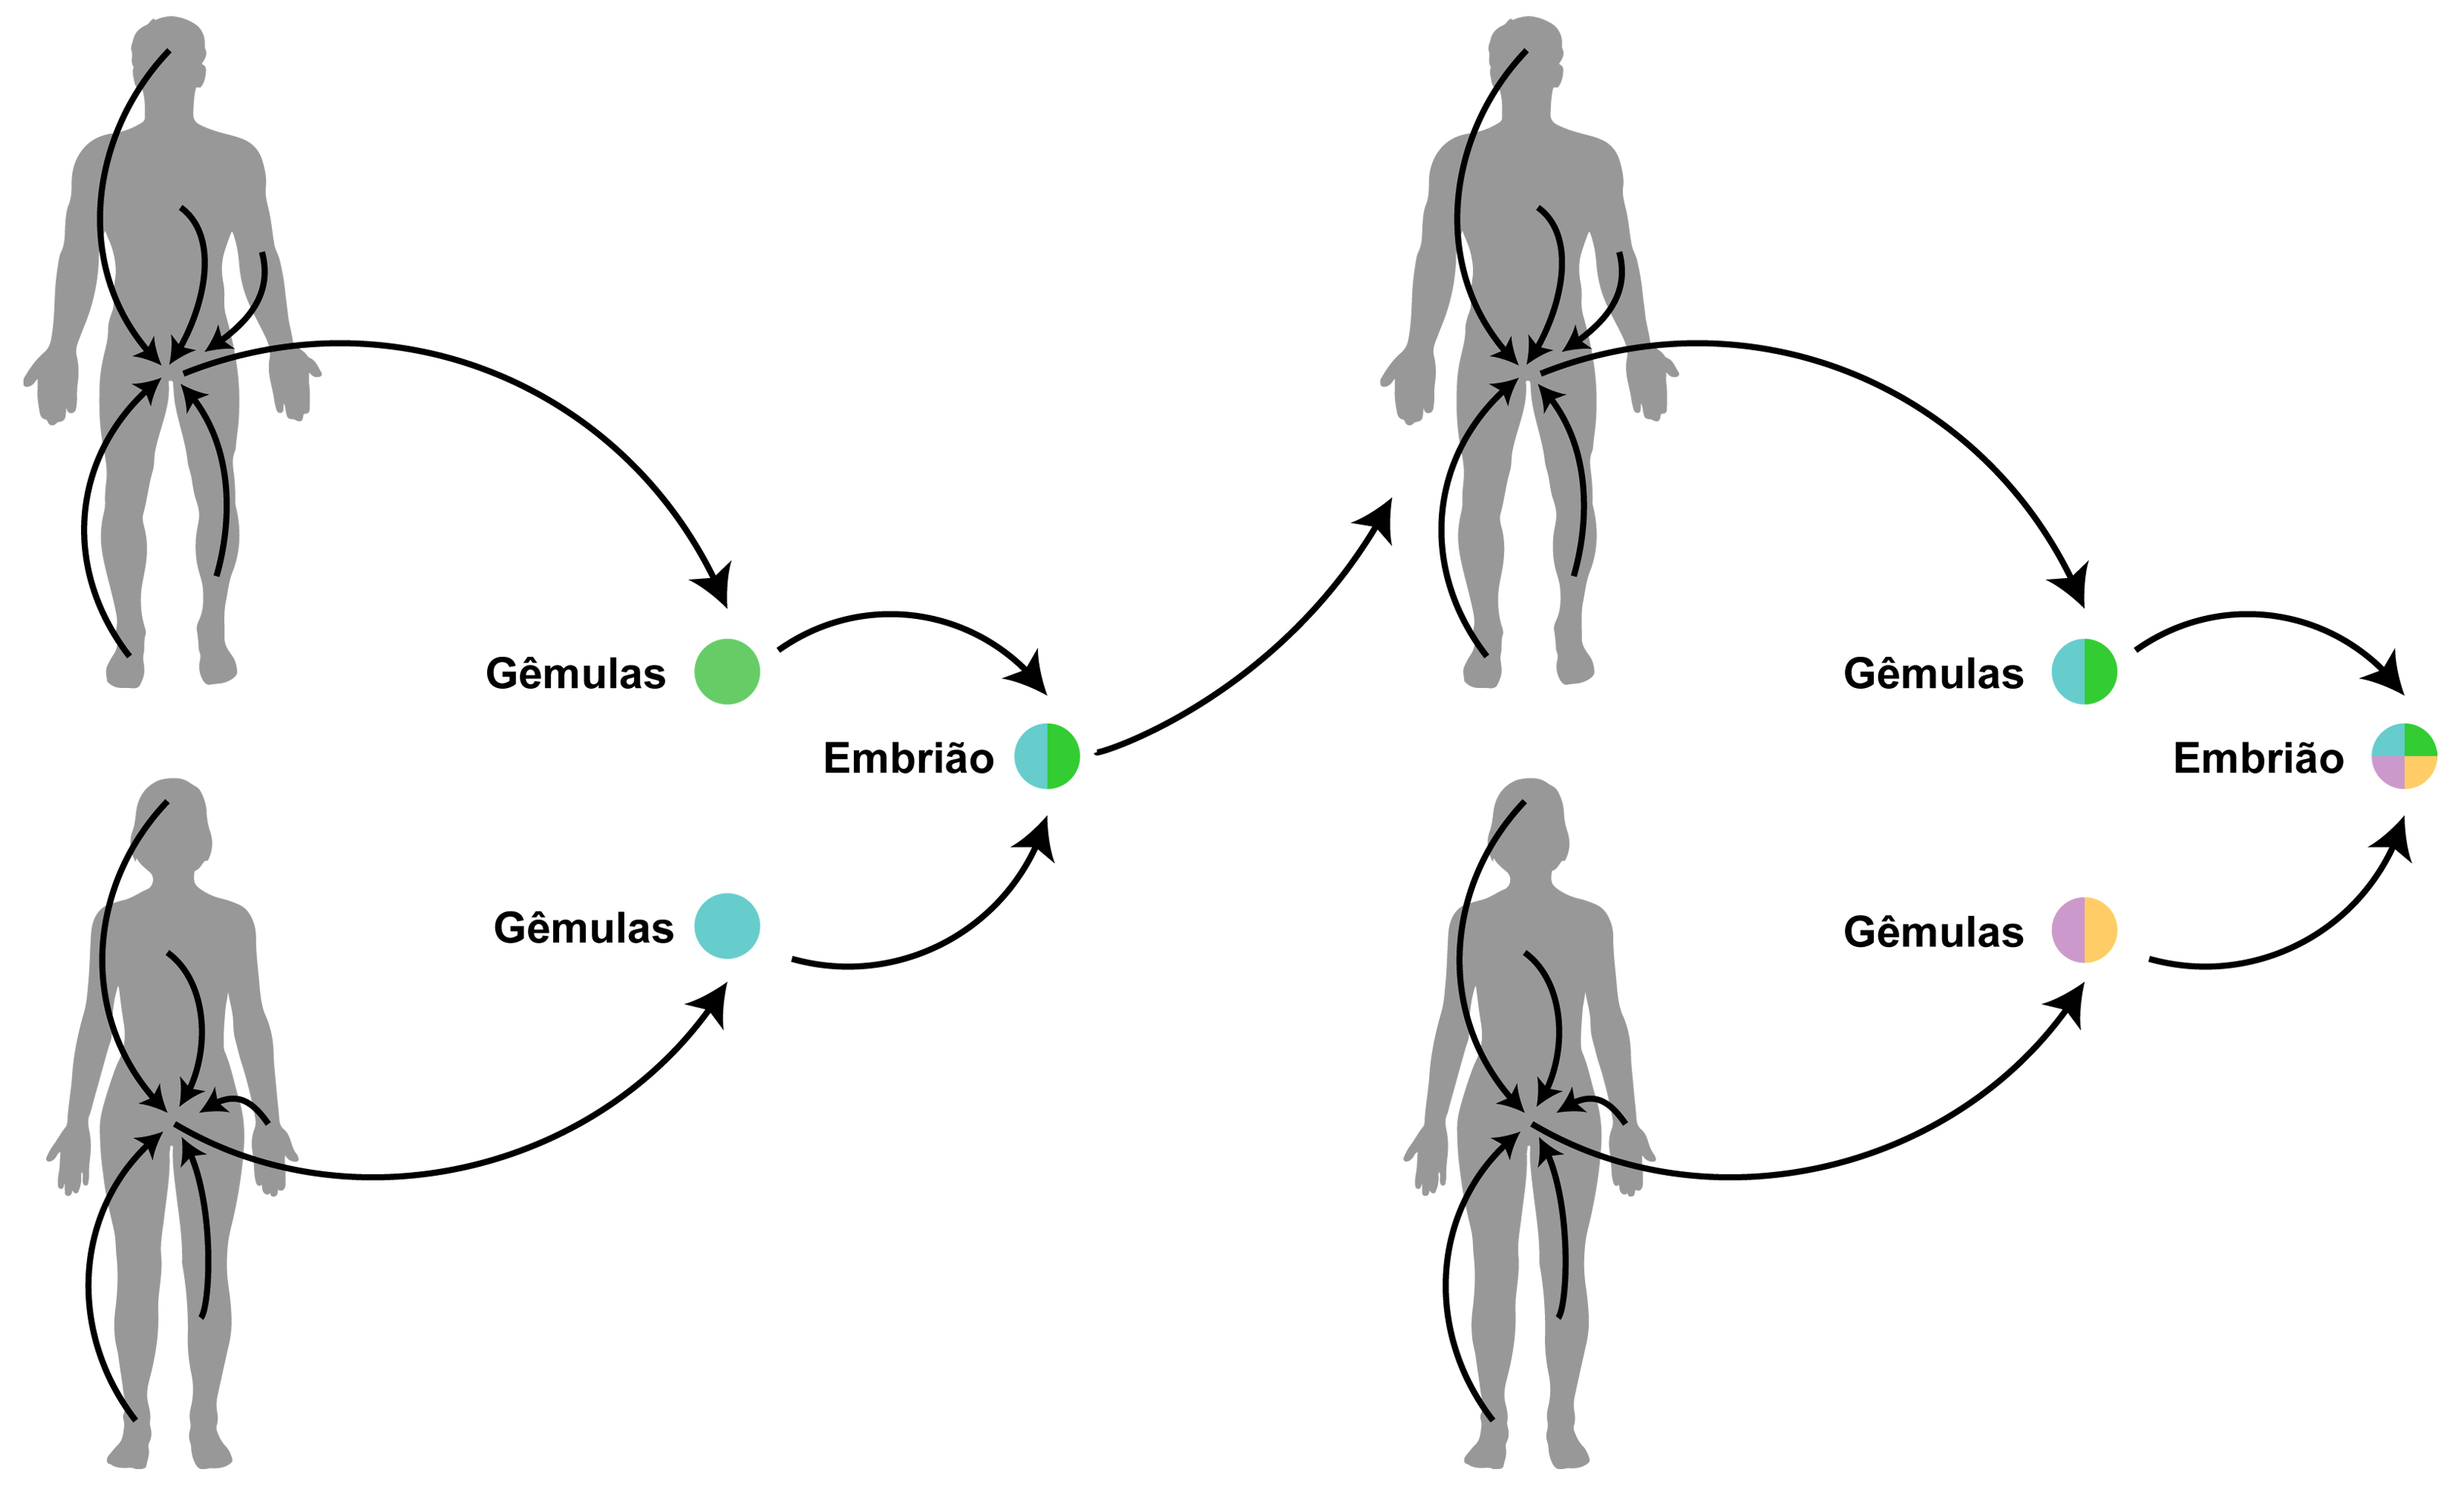
Um detalhe que pouca gente considera é o charset. A lei da transmissão dos caracteres adquiridos só funciona corretamente quando o conjunto de caracteres entre emissor e receptor é o mesmo, ou quando há uma conversão explícita documentada. Eu vi vários casos em que sistemas usavam CP437 em uma ponta e UTF-8 na outra, e as sequências de controle que pareciam corretas eram corrompidas silenciosamente pela diferença de codificação. O sintoma mais óbvio é caractere estranho no meio do texto, mas o efeito colateral real é a quebra dos atributos embutidos, o que torna o diagnóstico mais demorado do que o problema em si.
Erros comuns que você deve evitar
O erro mais frequente é tratar a transmissão como se fosse apenas transporte de bytes. Caráter adquirido não é byte inocente. Ele carrega intenção de formatação definida no gerador original, e ignorar isso gera inconsistências que só aparecem em produção. Outro erro comum é assumir que todos os receptores suportam o mesmo nível de interpretação. Um terminal moderno pode ler sequências ANSI sem problemas, enquanto um terminal de linha de comando embutido em uma aplicação industrial pode simplesmente ignorá-las ou exibir o código bruto na tela. Existe também a tentação de usar regex genérica para remover todas as sequências de controle. Funciona em casos simples, mas quebra rapidamente quando os dados contêm múltiplos esquemas sobrepostos ou quando parte do conteúdo é legítimo e parte é ruído. A solução mais segura é fazer match seletivo baseado nos padrões conhecidos do seu ecossistema, testar em lote pequeno antes de aplicar em escala, e manter registro das regras usadas para cada tipo de dado.
Quando esse conceito não se aplica
A lei da transmissão dos caracteres adquiridos é irrelevante quando você está trabalhando com dados puramente estruturais, como JSON, XML bem definido, ou bancos de dados relacionais modernos que separam completamente conteúdo e apresentação. Nessas camadas, formatação e formatação são responsibilities distintas, e não faz sentido aplicar o princípio. Tentar forçá-lo nesses contextos só introduz complexidade desnecessária e aumenta o risco de erros de serialização. Também não se aplica a fluxos que já passam por normalização obrigatória antes do envio, como pipelines ETL que incluem etapa de limpeza de código de controle. Nesses casos, a intenção é exatamente remover os caracteres adquiridos, e o princípio não entra em cena. O importante é reconhecer quando o cenário exige preservação e quando exige eliminação, porque confundir os dois leva a decisões técnicas ruins que custam tempo de depuração posterior. Se você estiver lidando com sistemas que ainda dependem desse comportamento, o caminho mais direto é documentar os padrões encontrados, criar um filtro de adaptação reutilizável, e testar em ambiente controlado antes de colocar em produção. O esforço inicial paga rápido quando se evita retrabalho em migrações ou integrações que dependem de formatação preservada ao longo da cadeia de transmissão.

Galeria
-
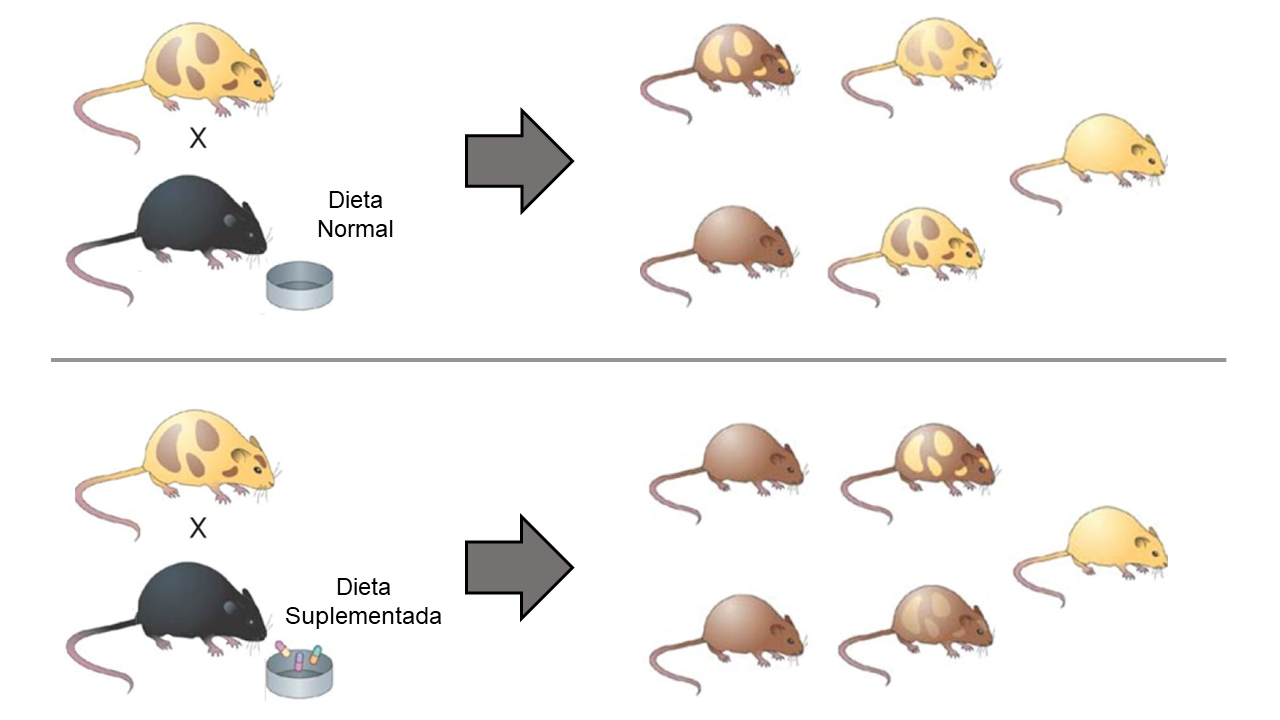
Herança Dos Caracteres Adquiridos - FDPLEARN -
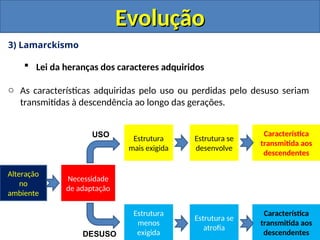
Evolucao-2.ppt-LamarckismoLei do uso e desuso Lei da herança dos ... -
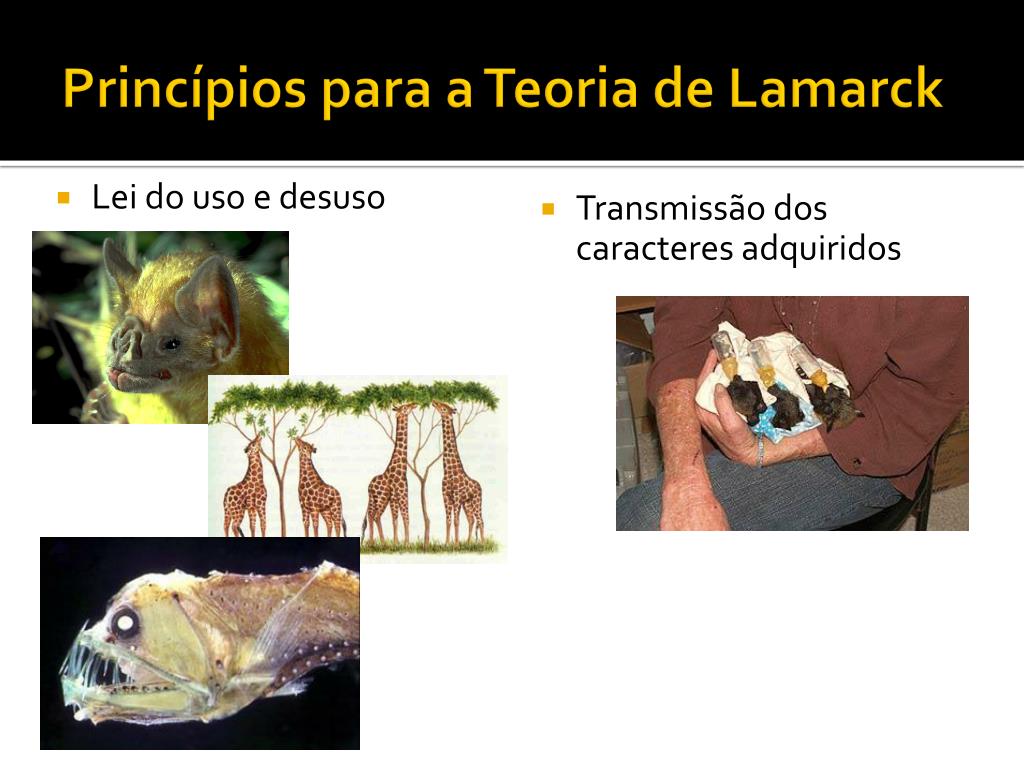
PPT - Teorias sobre Origem da Vida (página 52 a 57) PowerPoint ...
