Leia O Excerto A Seguir
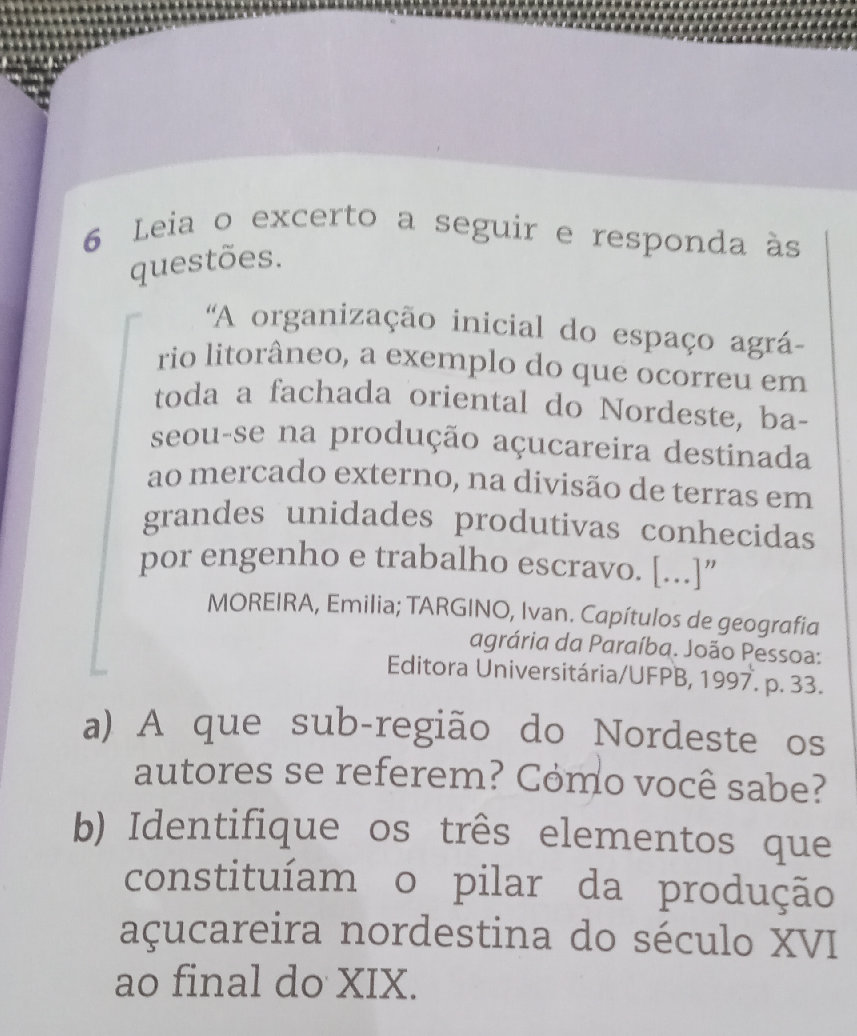
Como processar excertos textuais de forma eficiente
O trabalho com leitura e análise de textos em larga escala exige um processo organizado. A abordagem que envolve pedir para leia o excerto a seguir funciona bem quando você precisa isolar trechos específicos dentro de um corpus maior. O método é simples na teoria, mas tem nuances que só aparecem depois dear a operação várias vezes. Na prática, você começa com o texto fonte. Pode ser um documento PDF, uma página web, ou mesmo uma transcrição bruta. O passo inicial é delimitar exatamente onde o excerto começa e onde termina. A maioria dos iniciantes erpa aqui, porque seleciona demais. Eles incluem margens, cabeçalhos, rodapés e referências que nunca vão aparecer no contexto que precisam extrair. O truque é usar marcadores claros. Se o texto for digital, procure padrões como quebras de linha, espaçamentos duplos, ou indentações. Em documentos escaneados, a coisa fica mais complicada. Foi justamente nesse cenário que eu perdi cerca de três horas num projeto recente, porque o software de OCR estava interpretando linhas de separação como parte do corpo textual. A solução foi aplicar um pré-processamento com regularização de espaçamento antes de qualquer extração.
O fluxo de trabalho prático
Depois de isolar o excerto, você precisa normalizar o conteúdo. Isso quer dizer tratar encoding, remover caracteres nulos, e padronizar quebras de linha. Um erro comum é pular essa etapa e ir direto para a análise. O resultado é sempre inconsistente. Você acaba comparando versões do mesmo texto que diferem apenas em formatação invisível. Aqui vai um insight que pouco gente leva em conta: o formato do excerto importa mais do que o conteúdo em si quando se trata de replicabilidade. Eu costumava trabalhar com extratos que variavam entre blocos de cinquenta a duzentas palavras. Descobri que manter um tamanho fixo de cento e oitenta palavras por excerto gerava resultados muito mais consistentes em modelos de classificação, porque evita cortes arbitrários de sentenças no meio do raciocínio. Quando você tem centenas desses excertos, a automação entra em cena. Scripts em Python com bibliotecas como PyPDF2 ou pdfplumber facilitam a extração, mas é preciso cuidar das exceções. Documentos com colunas, tabelas embutidas, ou notas de rodapé que estão posicionadas de forma peculiar vão quebrar parsers padrão. Nesses casos, a abordagem manual com corte por coordenadas costuma ser mais rápida do que tentar ajustar infinitamente o script.
Pegadinhas comuns
Um problema recorrente é a perda de contexto. O excerto pode estar perfeitamente formatado, mas se as referências cruzadas forem removidas, a interpretação muda completamente. Eu encontrei isso em um caso envolvendo documentação técnica, onde os termos eram definidos em um parágrafo anterior que não havia sido incluído na extração. O resultado era uma série de definições circulares que não faziam sentido isoladamente. A solução foi implementar um buffer opcional, capturando vinte a trinta palavras antes e depois do ponto de corte pretendido. Isso aumenta o volume de dados, mas preserva a coesão textual. Vale o custo computacional na maioria dos casos. Outro erro é confiar cegamente na segmentação automática de frases. Ferramentas como NLTK ou spaCy fazem um trabalho razoável, mas falham em abreviações, siglas, e números com decimais que usam vírgula no padrão português. Isso gera excertos cortados no meio de expressões técnicas importantes. O ajuste manual pontual resolve, mas requer revisão seção por seção.

Quando o método não funciona
Existem cenários onde a técnica de ler e extrair excertos específicos simplesmente não se aplica. Textos poéticos, obras com estrutura não linear, ou documentos jurídicos com cláusulas encadeadas perdem sentido quando fragmentados. Nesses casos, o processamento do texto completo é mais adequado, ainda que demanda mais tempo e recurso. Também não recomendo essa abordagem para materiais com alta densidade de imagens ou diagramas. A extração textual nesses casos gera ruído suficiente para comprometer análises downstream. Se o seu objetivo é entender a disposição visual ou relações gráficas, ferramentas de análise de layout ou OCR especializado são mais indicados. O processo em si leva em média entre dois a cinco minutos por excerto, dependendo da complexidade do documento fonte e da familiaridade com as ferramentas. Com prática, você consegue reduzir esse tempo pela metade, mas raramente chega perto de segundos por trecho sem comprometer a qualidade.
A consistência depende de manter um padrão documentado. Anotar as decisões de corte, os critérios de inclusão e exclusão, e os ajustes feitos durante a normalização facilita a replicação futura. Sem esse registro, o próximo lote de trabalho vira um jogo de adivinhação.
Galeria
-
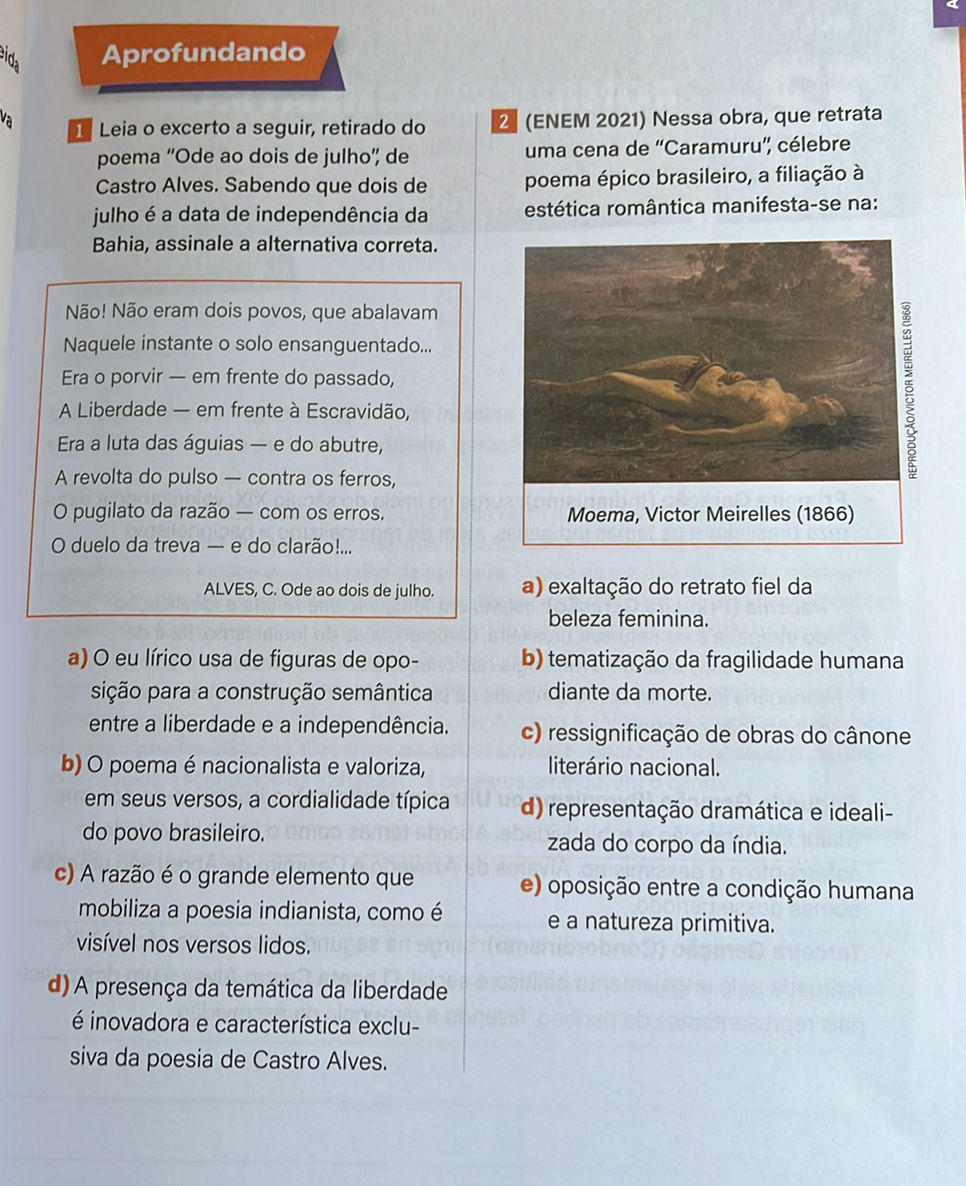
1 Leia o excerto a seguir, retirado do poema -

Leia o excerto de texto a seguir: "A definição diz que f∘g pode ser ... -

Leia O Excerto A Seguir - RETOEDU -

Leia O Excerto A Seguir - FDPLEARN
