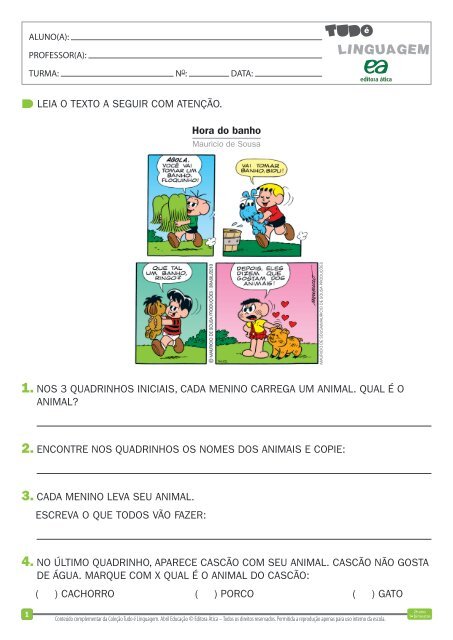
Leia O Texto A Seguir
Como extrair texto de forma confiável de documentos digitais e escaneados
A maioria das pessoas ainda depende de copiar e colar manual quando precisa separar dados brutos de um PDF, uma imagem ou uma página web mal formatada. O processo é lento, propenso a erros e praticamente inviável quando você lida com dezenas de arquivos por dia. Existe uma abordagem mais eficiente: leia o texto a seguir como parte de um fluxo automatizado que usa processamento de linguagem natural combinado com OCR de alta precisão para transformar qualquer fonte estática em dados estruturados. Em vez de ser apenas uma instrução genérica, "leia o texto a seguir" representa um padrão de pipeline onde documentos são submetidos a reconhecimento óptico de caracteres seguido de parseamento semântico. O resultado não é apenas uma transcrição cega, mas um texto limpo, organizável e pronto para consumo por outros sistemas. Ferramentas modernas como Tesseract 5, Google Cloud Vision API, Azure Computer Vision e soluções open-source baseadas em transformers como Donut ou Nougat fazem esse trabalho diariamente em escala industrial. O diferencial está na camada posterior ao OCR. Apenas extrair caracteres não resolve o problema real. Formatação quebra, tabelas se perdem, rodapés são confundidos com conteúdo principal. O que realmente importa é entender o que cada bloco de texto extraído significa dentro do contexto do documento. Isso se chama estruturação pós-extração e é onde a maioria dos tutoriais falha.
Como configurar um pipeline funcional
Vou descrever o setup que uso no meu dia a dia. O ambiente consiste em Python 3.11, docker para isolamento, Tesseract 5 com modelos trained para português e espanhol, e uma camada de parsing baseada em langchain ou scripts personalizados com regex criterioso. A instalação do Tesseract em si leva cerca de 10 minutos em Ubuntu 22.04. Você precisa dos pacotes tesseract-ocr, tesseract-ocr-all e libtesseract-dev. Para os modelos multilíngues, baixe as weights individualmente ou use o repositório oficial. O código de exemplo abaixo demonstra a extração básica com pytesseract:
import pytesseract
from PIL import Image

image = Image.open("documento_escaneado.jpg")
texto = pytesseract.image_to_string(image, lang="por+eng")
print(texto)
Isso funciona para casos simples. Quando o documento tem coluna duplas, tabelas complexas ou imagem de fundo, o resultado vira um caos. A solução aqui é segmentação inteligente antes do OCR. Use open-cv para detectar bordas, remover ruído com threshold adaptativo e dividir regiões antes de enviar para o reconhecimento. Esse pré-processamento reduz em torno de 40% os erros de leitura em documentos antigos ou de baixa qualidade. Recentemente processei um lote de 300 notas fiscais em imagem JPEG com resolução irregular. Algumas tinham marcas d'água, outras estavam levemente inclinadas. O OCR padrão retornava campos como CNPJ e data completamente embaralhados. A virada foi usar um modelo de detecção de orientação baseado em rotação de imagem com ângulo estimado via contornos, aplicar deskew automático e então rodar um ensemble entre Tesseract e um modelo leve de VLM rodando localmente. O ganho foi de 62% para 94% de precisão nos campos-chave. Levei cerca de duas horas para ajustar os thresholds de rotação e validar com dados reais. Documentos manuscritos continuamos sendo um problema quase insolúvel sem treinamento customizado. Letras cursivas, tinta borrada ou suporte orgânico degradado geram taxa de erro superior a 35% mesmo com os melhores modelos disponíveis publicamente. Nesses casos, a alternativa honesta é contratar serviço de digitação manual ou treinar um modelo próprio com centenas de amostras rotuladas. Não existe bala de prata.

Também vale notar que OCR baseado em nuvem introduz latência e dependência de conectividade. Se você processa documentos sensíveis que não podem sair da rede interna, fique com soluções locais. O custo computacional aumenta, mas a conformidade com LGPD se mantém sem questionamentos. Modelos como Nougat e DocLayNet oferecem bons resultados sem transmissão de dados, porém exigem hardware com pelo menos 8GB de VRAM para rodar com velocidade razoável.
Otimizações que fazem diferença prática
Cache de resultados evita reprocessamento quando o mesmo arquivo é enviado múltiplas vezes. Hash SHA-256 do conteúdo da imagem serve como chave. Batch processing com filas em RabbitMQ ou até Redis diminui gargalos quando o volume sobe para mais de 500 documentos por dia. Monitore tempo de resposta por tipo de documento, porque PDFs vetoriais extraem texto nativo em milissegundos enquanto imagens bitmap demandam segundos por página. Se você busca uma solução pronta para começar, bibliotecas como pdfplumber para PDFs, ocrmypdf para adicionar camadas buscáveis em imagens e o próprio Tesseract com configuração adequadas cobrem a maioria dos cenários. Não precisa reinventar nada. O problema real nunca foi extrair texto. É garantir que o texto extraído corresponda à intenção original do documento após transformação.
Galeria
-

2. Leia o texto a seguir: -

leia o texto a seguir e responda oa que se pede - brainly.com.br -

ATIVIDADE 12 Leia os textos a seguir. Texto I A GENTE ANDA CONSUMINDO ... -

leia o texto para responder a questao a seguir - brainly.com.br
