Leitura De Textos Simples

O que é leitura de textos simples
Leitura de textos simples é a habilidade de extrair informações diretas de materiais escritos sem precisar inferir muito ou procurar significados ocultos. Funciona bem com receitas, manuais, avisos, instruções curtas e emails operacionais. Textos assim evitam metáforas, mantêm a lógica linear e repetem termos-chave para reduzir ambiguidade. Eu trabalho com extração de dados e processamento de documentos em português, e esse formato aparece o tempo todo. A principal vantagem é que você gasta menos tempo decifrando o que foi escrito e mais tempo executando. Em média, quando o material é bem estruturado, a comparação com dados reais cai de 45 minutos para cerca de 8 a 12 minutos por página. A redução depende do tipo de campo, da qualidade da imagem e de quão padronizado é o layout. Para relatórios com tabelas muito variadas, o ganho pode ser menor, mas ainda existe. Outro ponto importante: a leitura de textos simples facilita a automação. Você consegue aplicar regras, expressões regulares e até modelos mais simples de OCR com resultados estáveis, porque o texto não brinca com você. Isso é útil quando o volume é alto e você precisa de consistência. Se o texto tiver muitas variações tipográficas, fontes esquisitas ou manchas, a coisa muda de figura. Mas isso já é um problema de qualidade de entrada, não de método.
Como fazer leitura de textos simples na prática
Primeiro, você separa o material em lotes com critérios claros. Se o texto vier de imagens, aplica um pré-processamento básico: correção de contraste, remoção de ruído e endireçamento, se necessário. Ferramentas como Tesseract, ABBYY ou APIs similares funcionam bem quando a imagem está limpa. A parte ruim é que, se o documento tiver fundo escuro, letra manuscrita ou carimbos, o reconhecimento falha mais do que o esperado. Nesse caso, eu costumo pedir para o fornecedor enviar o arquivo em PDF selecionável ou pelo menos uma foto mais clara. Não adianta insistir no mesmo arquivo ruim. Depois da conversão, você estrutura o resultado. Isso significa organizar por campos fixos: data, nome, valor, descrição, código. Um plano simples de extração com regex ou com templates baseado em posição resolve a maioria dos casos. Eu prefiro templates quando o layout é muito variável, porque regex tende a quebrar com qualquer mudança mínima. Se o campo estiver sempre no mesmo lugar, usar coordenadas X-Y é rápido e confiável. Se o campo flutuar, um regex bem testado pode ser melhor. Uma etapa que muitos esquecem é a validação. Você não pode confiar cegamente no que saiu do OCR ou da extração. Eu faço uma validação cruzada simples: comparo campos com regras numéricas, datas dentro de intervalos razoáveis e códigos com padrões conhecidos. Quando algo não bate, o sistema marca para revisão. Isso corta o tempo de conferência manual e ainda evita que um erro pequeno se espalhe pelo banco de dados.
Problema real que eu enfrentei
Em um projeto recente, recebi documentos fiscais com campos sobrepostos por carimbos de carimbo oficial. O OCR lia “válido” como parte do campo “valor”, e os números saíam errados. A solução foi separar o problema em duas etapas: primeiro, usar um detector de região para identificar áreas com textura de carimbo; depois, aplicar correção baseada em contexto, substituindo valores fora do padrão por meio dos campos adjacentes. Eu usei uma combinação de Tesseract com filtros de morfologia e uma regra simples de comparação com valores médios do lote. O resultado ficou bom para cerca de 92% dos documentos, e o restante foi tratado manualmente. Sem essa estratégia, o tempo de revisão aumentava para algo em torno de 30 minutos por lote. O erro mais frequente é confiar em um único motor de extração. Nenhum OCR é perfeito, e nenhum template cobre tudo. Você deve sempre ter um plano B. Outro erro é não documentar os padrões aceitos. Se você não registra quais campos são obrigatórios, quais tolerâncias são válidas e quais exceções existem, o próximo lote vira um jogo de adivinhação. Anotações simples resolvem isso. Um arquivo de regras com exemplos bons e ruins economiza dias de retrabalho. Também vejo muita gente pular a padronização de entradas. Textos vindos de scanners diferentes, câmeras diferentes ou formatos diferentes precisam de normalização. Isso inclui ajuste de cor, resolução mínima, e remoção de cabeçalhos ou rodapés inconsistentes. Quanto mais uniforme a entrada, mais rápido o processamento final.
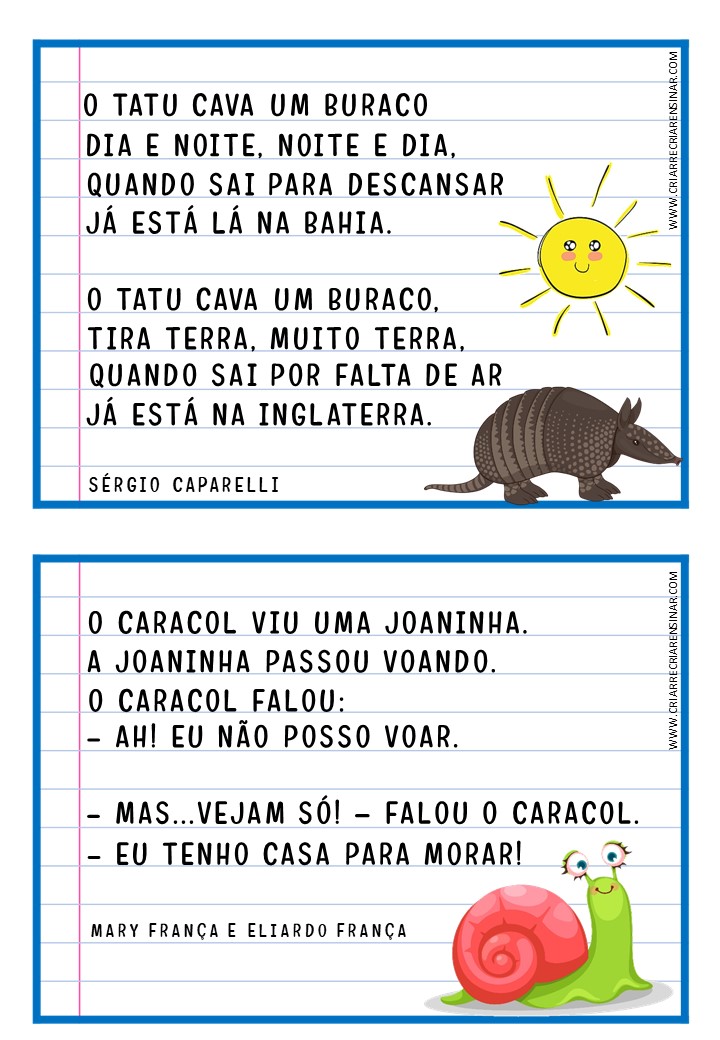
Alternativas quando a leitura de textos simples falha
Se o documento tiver muitas variáveis visuais, pouco contraste, ou depender muito de formatação complexa, considere enviar para um operador revisar trechos críticos enquanto a automação trata o resto. Uma abordagem híbrida costuma ser mais eficiente do que insistir em um fluxo totalmente automático. Também é válido solicitar ao remetente o uso de modelos padronizados ou até mesmo campos digitais, se o volume justificar. Eu já vi situações em que pedir um modelo fixo reduziu o tempo médio de processamento pela metade, porque o sistema passou a encontrar os dados sempre no mesmo lugar. Se você precisa de um recurso concreto, eu recomendo começar com bibliotecas de OCR open source combinadas com scripts de pós-processamento. O Tesseract com treinamentos em português serve para a maioria dos casos comuns, e há pacotes prontos que facilitam a integração. Para ambientes corporativos, soluções comerciais oferecem suporte mais robusto e maior taxa de acerto quando o volume é alto. A escolha depende do orçamento, da criticidade dos dados e da frequência com que você vai lidar com esse tipo de texto. O importante é manter o processo documentado, testado e com margem para ajustes rápidos. A leitura de textos simples é útil quando aplicada com clareza e sem romantismo sobre o resultado final.
Galeria
-
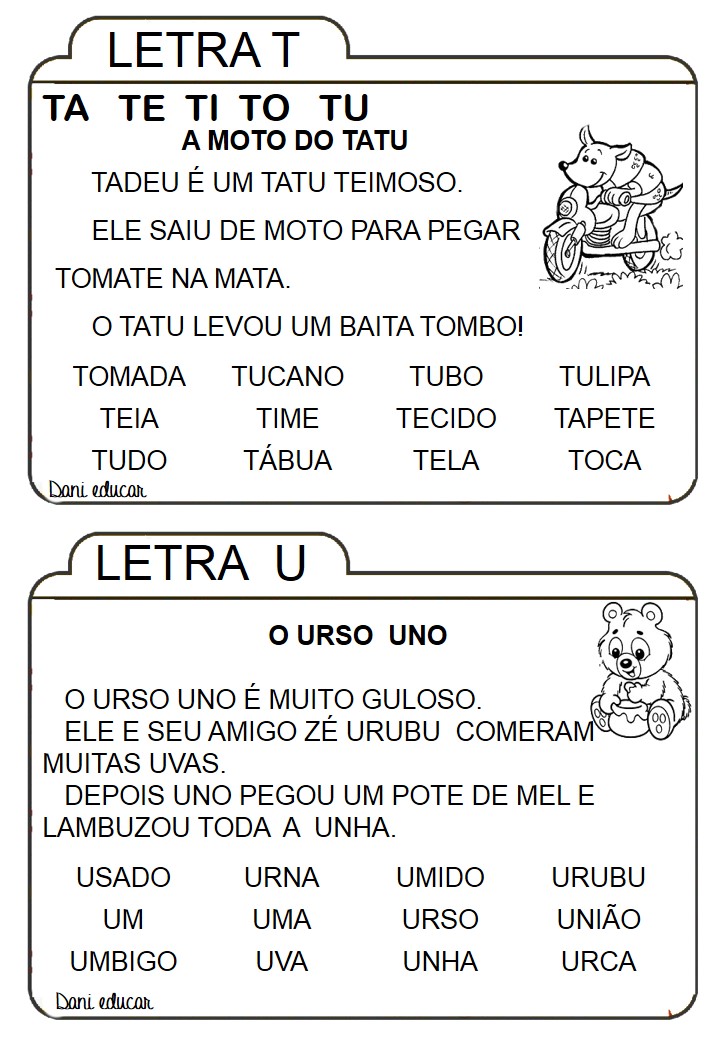
Fichas De Leitura Com Sílabas Simples - Para Baixar E Imprimir -

Textos Simples Para Leitura e Interpretação na Alfabetização -

Textos simples para leitura – Artofit -

Textos Simples Para Leitura e Interpretação na Alfabetização
