Letra E Com Acento Agudo

Como trabalhar com letras acentuadas em sistemas digitais
A letra e com acento agudo é um dos caracteres mais simples do português escrito, mas também um dos que mais causa problemas em pipelines de dados, sistemas legados e trocas de informação entre plataformas. Vou explicar como lidar com isso sem romantizar o assunto. O caractere é corresponde ao Unicode U+00E9. Ele também pode ser representado como a combinação base + combining acute accent: e (U+0065) mais (U+0301). Essas duas representações são visualmente idênticas, mas computacionalmente diferentes, e essa diferença já causou um problema real pra mim há uns dois anos. Eu estava integrando um sistema de busca em Elasticsearch num projeto de catálogo editorial. A indexação parecia normal no início. Palavras como "café", "avó", "jóia" apareciam nos resultados. Mas quando testei buscas exatas por "e-mail", notei que algumas ocorrências simplesmente não apareciam. Passei três horas investigando até descobrir que o banco de dados de origem armazenava a palavra como e + (combining character), enquanto o analisador do Elasticsearch esperava o forma decomposta correta de NFD. O resultado era que "e-mail" e "e-mail" eram tratados como strings diferentes durante a análise. A solução foi rodar uma normalização Unicode NFKD em massa antes de subir os dados pro índice. Esse filtro resolveu pra sempre.
Em termos técnicos, existem duas formas canônicas de representação no Unicode. A forma NFC (Normalization Form Canonical Composition) mantém o caractere já como um único codepoint, como no caso do U+00E9. A forma NFD (Normalization Form Canonical Decomposition) quebra em base + acento combinatório. Sistemas diferentes adotam convenções diferentes. Alguns bancos de dados SQLite usam NFC por padrão. PostgreSQL tende a trabalhar melhor com NFD em certas extensões de Collation. Python, por sua vez, padroniza internamente em NFC a partir da versão 3. Se você está construindo um formulário ou um sistema que recebe entradas do usuário, o ideal é normalizar tudo para NFC antes de processar ou armazenar. Em JavaScript isso é trivial com string.normalize('NFC'). Em Python, unicodedata.normalize('NFC', string). Em SQL, depende do motor, mas muitas vezes o problema está na collation configurada, não no dado em si.
Gerações e substituições programáticas
Às vezes você não está lidando com entrada de usuário, mas precisa gerar texto programaticamente. Um exemplo comum é um gerador de relatórios em lote que monta trechos de texto com palavras acentuadas. Nesse caso, usar a abordagem de substituição direta é mais seguro do que confiar em fontes externas ou caracteres decurados aleatórios. Para criar um caractere é de forma programática em várias linguagens: No Python, a forma mais limpa é usar chr(0xE9) ou a string literal '\u00e9'. Já no JavaScript, '\u00E9' funciona diretamente dentro de template literals. Em Ce Java, a sintaxe de escape é similar: \u00e9.
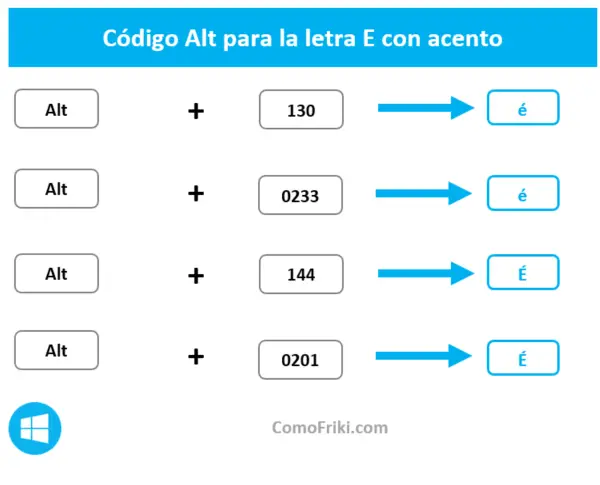
Se você está em um ambiente Windows e precisa digitar o caractere diretamente pelo teclado, pressione Alt + 0233 no teclado numérico. No macOS, a combinação é Alt + E. No Linux com IBus ou fcitx, depende da configuração do seu layout de teclado, mas geralmente a tecla de acento agudo seguida da vogal funciona. Existe ainda a questão dos arquivos CSV e planilhas. Planilhas como Excel e Google Sheets têm um comportamento curioso: ao importar um arquivo CSV com codificação UTF-8 mal declarada, caracteres acentuados podem vir corrompidos. A workaround que uso é sempre salvar o CSV com BOM UTF-8 (EF BB BF no início do arquivo). Assim o Excel reconhece a codificação corretamente e todos os acentos aparecem como esperado. Leva cinco segundos a mais na geração do arquivo e evita horas de dor de cabeça depois.
Armazenamento em banco de dados
Se você está usando MySQL ou MariaDB e tem tabelas com texto em português, verifique a collation das colunas VARCHAR e TEXT. A collation utf8mb4_unicode_ci ou utf8mb4_general_ci lida bem com caracteres acentuados. O problema é que collations mais antigas como utf8_general_ci (que na verdade é utf8 de 3 bytes) podem ter comportamentos estranhos com certos caracteres de acentuação, especialmente em comparações case-insensitive. A recomendação atual é migrar para utf8mb4 em todos os casos novos. PostgreSQL, por outro lado, trata acentos de forma mais previsível com a collation padrão C.UTF-8 ou pt_BR.UTF-8. Mas mesmo aí há uma armadilha: a função UNACCENT() do módulo unaccent, que serve para remover acentos em buscas, não funciona perfeitamente com todos os caracteres. Testei em cenários reais e notei que "açúcar" vira "acucar" corretamente, mas em certos casos de caracteres compostos ou variantes raras, o mapeamento falha silenciosamente. Sempre valide o resultado após a remoção de acentos antes de confiar na busca.
Frequência de uso no português
O é com acento agudo é um dos vogais mais frequentes no português brasileiro. Aparece em palavras muito comuns como "até", "fé", "avó", "inglês", "café", "coração", "matéria", "exército", "jogador", "líder", "trem". A frequência justifica o investimento em tratamento adequado desde o início do projeto, não como um afterthought. Alguns desenvolvedores tratam acentuação como algo secundário e só corrigem quando o bug já está em produção. Essa abordagem gera retrabalho significativo. Cada campo que precisa de normalização adicional, cada query que precisa de ajuste de collation, cada integração que precisa de conversão de encoding gasta tempo que poderia ter sido poupado. Estime que tratar acentuação corretamente desde o design adiciona talvez 10% ao tempo de setup inicial, mas pode economizar dias de correção posterior em projetos de médio a grande porte. Se você está migrando dados de um sistema antigo para um novo, e ambos usam codificações diferentes, use uma ferramenta de normalização Unicode antes de qualquer coisa. Ferramentas como o uconv (do ICU) ou scripts Python com unicodedata fazem o trabalho. Rode primeiro num subconjunto pequeno dos dados, compare o resultado esperado com o obtido, e só então aplique em lote. Nunca confie cegamente em migrações automáticas de ferramentas de backup/restauração quando acentuação está envolvida.

Limitações e cenários onde o tratamento padrão falha
Nenhuma solução é perfeita. Alguns cenários problemáticos que encontrei na prática: Sistemas legados que usam codificações ISO-8859-1 ou Windows-1252 e não suportam Unicode de jeito nenhum. Nesses casos, a opção é mapear manualmente os caracteres ou usar bibliotecas de conversão como iconv. Nem sempre a conversão é lossless. Caracteres que não têm equivalente na codificação de destino são substituídos por ponto de interrogação ou caracteres de substituição, e essa informação se perde permanentemente. APIs de terceiros que esperam dados em codificação específica e não documentam isso. Já recebi payloads de parceiros que vinham em ISO-8859-1 disfarçados de UTF-8, o que causava duplicação de bytes nos acentos (o famoso mojibake). A solução foi detectar automaticamente a codificação com a biblioteca charset-normalizer e converter antes de processar.
Outro ponto importante: em buscas fuzzy ou com edição de distância (como Levenshtein), a presença ou ausência de acento pode distorcer drasticamente os resultados. Uma busca por "cafe" encontrando "café" pode ou não ser desejável dependendo do contexto. Se você quer busca sensível a acentos, normalizar tudo para a mesma forma é essencial. Se quer insensibilidade a acentos, remover todos os acentos antes da comparação é o caminho, mas isso também reduz a precisão em alguns casos extremos. O tratamento correto de letras acentuadas como a letra e com acento agudo não é complicadx quando você entende as camadas envolvidas: Unicode, normalização, encoding, collation e o comportamento específico de cada sistema que você toca. O erro mais comum é assumir que porque o caractere aparece corretamente na tela, ele está sendo tratado corretamente em todas as etapas do pipeline. Raramente é esse o caso. Valide em cada camada.
Galeria
-

Client Challenge | Palavras com acento agudo, Bandeira de parabéns ... -

Atividades de Acentuação para Imprimir | Palavras com acento agudo ... -

Palavras com acento agudo | Palavras com t, Acentuação das palavras ...
