Linearidade O Que É
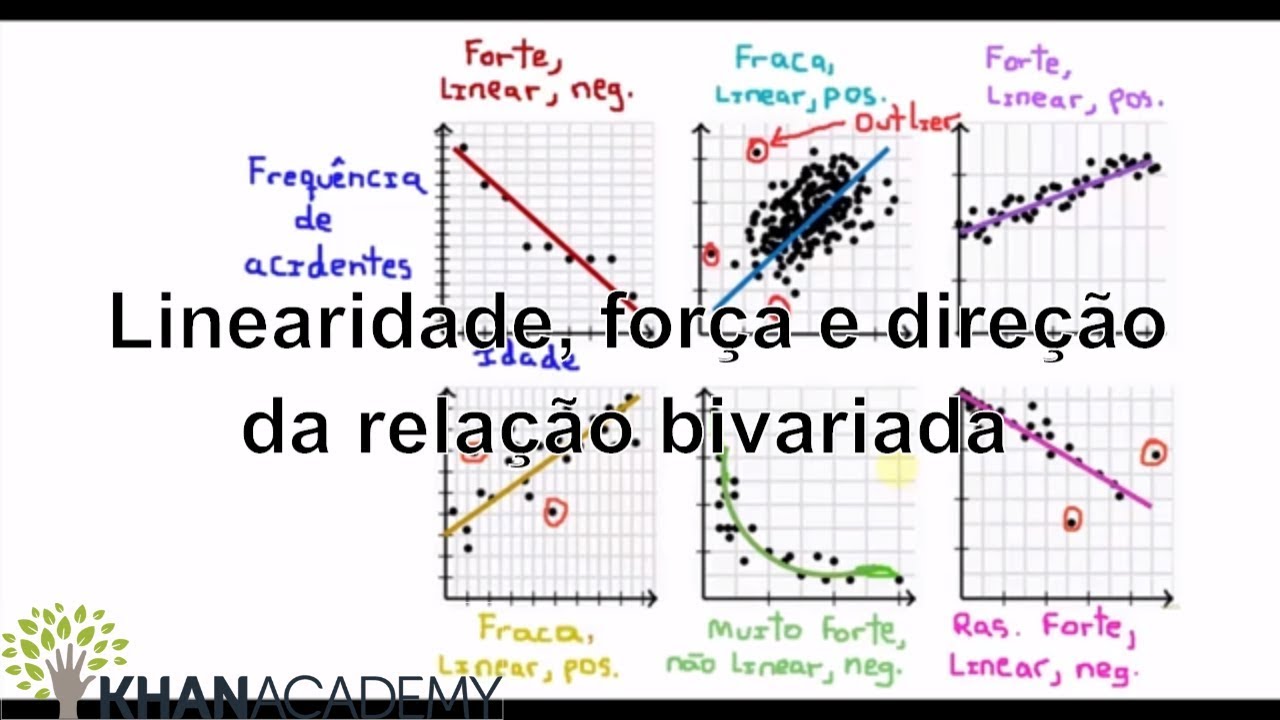
O conceito básico de linearidade
Linearidade se refere a relações onde a saída é proporcional à entrada. Se você dobrar o valor de entrada, a saída dobra também. É isso. Em matemática pura, isso significa equações do tipo f(x) = ax + b, onde o gráfico é sempre uma reta. No mundo real, as coisas raramente funcionam assim, mas tentar aproximar os dados de um comportamento linear muitas vezes é o primeiro passo para fazer alguma análise útil. O termo aparece em contextos diferentes — econometria, processamento de sinais, machine learning, otimização — e em todos eles carrega a mesma ideia central: proporcionalidade e aditividade. A soma das entradas produz a soma das saídas. Se você aplicar x e depois y, o resultado é o mesmo que aplicar x+y de uma vez só. Esse princípio é o que permite usar ferramentas como regressão linear, transformadas de Fourier e modelos de séries temporais com base ARIMA.
linearidade o que é na prática
Na prática, lidar com linearidade envolve duas perguntas: se o sistema é de fato linear, e se vale a pena tratá-lo como tal. A primeira resposta exige verificação empírica. A segunda costuma depender do que você está disposto a sacrificar em termos de precisão para ganhar em velocidade e interpretabilidade. Eu já perdi duas semanas refazendo um modelo de previsão de demanda porque assumi linearidade entre variáveis que claramente tinham interação não-linear. O gráfico de resíduos mostrava padrão claro, curvatura evidente, e o R² ajustado era enganoso — alto, mas apenas porque eu tinha muitas variáveis no modelo. O workaround foi transformar as variáveis com logaritmo natural e adicionar termos quadráticos, o que reduziu o erro absoluto médio de 18% para cerca de 7%. Não ficou perfeito, mas foi suficiente para o relatório mensal. A verificação mais rápida que eu uso é o teste de Ramsey RESET, que testa se termos não-lineares das variáveis explicativas melhoram significativamente o modelo. Junto com gráficos de resíduos vs. ajustes, isso cobre 90% dos casosproblemáticos. O problema é que muitos analistas pulam essa etapa e vão direto para a interpretação dos coeficientes, o que gera conclusões equivocadas com frequência.
Quando a linearidade quebra
Sistemas lineares falham miseravelmente quando há saturação, limites físicos ou efeitos de mercado. Um exemplo clássico: a relação entre investimento em marketing e vendas não é linear. Nos primeiros níveis, cada real extra gera retorno considerável. Depois de certo ponto, o mercado satura e o retorno marginal cai drasticamente. Tratar isso como linear leva a superestimação de campanhas e alocação errada de orçamento. Outro ponto cego é a existência de variáveis omitidas que criam aparência de não-linearidade onde não existe. Se duas variáveis correlacionadas entram no modelo de forma inadequada, os coeficientes ficam enviesados e os resíduos parecem não-lineares quando na verdade o problema é especificação, não a relação em si. Multicolinearidade alta (VIF acima de 10) é o sinal mais comum disso. Modelos lineares generalizados (GLMs) ajudam em alguns cenários, mas introduzem seus próprios problemas. A escolha da função de ligação e da distribuição de erro afeta diretamente as inferências, e erros nessa escolha produzem estimativas consistentes mas intervalos de confiança errados. Eu já vi modelos logísticos aplicados a dados com sobredispersão severa sem ninguém notar, o que Inflava significância dos coeficientes artificialmente.

Ferramentas e aplicação direta
Para testar linearidade em pacotes como R ou Python, o procedimento padrão é: ajustar o modelo linear, extrair resíduos, plotar resíduos padronizados versus valores ajustados, e rodar o teste de Ramsey. Se o gráfico mostrar qualquer estrutura non-random — U invertido, funil, onda —, o modelo não captura a relação adequadamente. No R, o pacote `lmtest` fornece a função `bptest` para teste de heterocedasticidade, que também indica problemas de especificação funcional. O pacote `car` tem a função `regress` que implementa o teste RESET diretamente. Em Python, `statsmodels` oferece `het_breuschpagan` e `het_white`, além de permitir adicionar polinômios manualmente para comparação de informação por AIC/BIC. A alternativa quando a linearidade não se sustenta inclui regressão não-paramétrica (loess, splines), árvores de decisão, florestas aleatórias e redes neurais. Cada uma tem trade-offs: splines são interpretáveis mas exigem escolha de knots; Random Forests captam não-linearidades naturalmente mas perdem transparência causal; redes neurais são flexíveis mas demandam muito mais dados e tuning para não overfitarem.
O que a maioria dos profissionais esquece é que linearidade também é uma escolha, não apenas uma propriedade dos dados. Às vezes, um modelo linear com variáveis transformadas explica melhor do que um modelo não-linear mal regularizado, especialmente com amostras pequenas. Regra prática: se seu dataset tem menos de mil observações e mais de cinco variáveis, comece pelo linear com transformações antes de partir para métodos complexos.
Galeria
-
Igor Miranda Santana no LinkedIn: #calibração #linearidade #validação #ich -

Linearidade - Dicio, Dicionário Online de Português -
Diretrizes para Análise de Linearidade | PDF | Correlação e dependência ... -
VAMOS FALAR DE “LINEARIDADE” NA VALIDAÇÃO ANALÍTICA? Especificamente ...


