Mas Depois Da Virgula

o que é e como funciona na prática
Você já precisou separar um campo de texto por vírgula e se deu mal? A maioria das pessoas acha que saber o básico de string.split() resolve. Resolve em 60% dos casos. Nos outros 40%, você perde horas tentando entender por que os dados vieram todos errados. O conceito de mas depois da virgula trata justamente disso: o que acontece com os dados após o delimitador, como lidar com edge cases que quebram parsers ingênuos, e por que a abordagem mais óbvia geralmente é a errada.
mas depois da virgula
Na minha experiência, o primeiro erro que vejo todo mundo cometer é confiar no split simples em CSVs mal formatados. Eu fiquei uma tarde inteira tentando debugar um script Python que truncava dados de um relatório financeiro porque a planilha usava vírgulas dentro de campos entre aspas. Algo como "São Paulo, SP" virava dois campos em vez de um. A solução que eu achei foi usar o parser do próprio módulo csv do Python, passando o parâmetro quotechar corretamente. Em vez de split(), você faz csv.reader(seu_arquivo, delimiter=',', quotechar='"'). Isso resolve o problema de campos com vírgulas internas, mas traz outro: se o arquivo veio do Excel exportado como CSV, a codificação pode ser cp1252 em vez de UTF-8, e você vai receber caracteres estranhos sem entender o motivo. O workaround foi especificar encoding='latin1' na abertura do arquivo. Cuidado com dados numéricos decimais. Em sistemas brasileiros, a vírgula é separador decimal. Se você for fazer parse de números com split por vírgula pensando que vai isolar campos, vai destruir os valores. Um valor como "1.234,56" vira duas partes: "1.234" e "56". A regra prática é: nunca use vírgula como único delimitador se houver chance de haver números decimais no arquivo. Use tabulação, pipe (|), ou semicolon se o gerador do arquivo permitir configurar.
Outro ponto que poucos mencionam: a consistência do delimitador em arquivos grandes. Eu processei arquivos de 2GB onde a planilha original tinha 3 delimitadores diferentes misturados (vírgula, ponto e vírgula e tab). O resultado era colunas desalinhandando progressivamente conforme a linha avançava. A solução foi detectar o delimitador dominante analisando as primeiras 500 linhas antes de processar o resto. Em média, isso evita bugs silenciosos que aparecem só na linha 50 mil. Se você está trabalhando com CSVs exportados de sistemas legados, a melhor coisa é primeiro verificar se existe uma opção de exportar com delimitador customizável. Muito software antigo força vírgula mesmo quando o conteúdo dela é problemático. Nesses casos, uma alternativa viável é usar a biblioteca pandas com o parâmetro sep=';' ou sep='\t' conforme o arquivo exigir, e fazer mapeamento manual das colunas quando a leitura automática falha. O problema real não é a técnica em si. É que todo mundo assume que o arquivo segue um padrão limpo quando na prática raramente segue. O mais comum é encontrar arquivos com linhas truncadas, campos faltando, e cabeçalhos que não batem com o corpo. Você economiza tempo fazendo uma validação inicial antes de processar o arquivo todo: conte as vírgulas por linha, verifique se a contagem é consistente, e descarte ou corrija as linhas que fogem da média antes de qualquer transformação.
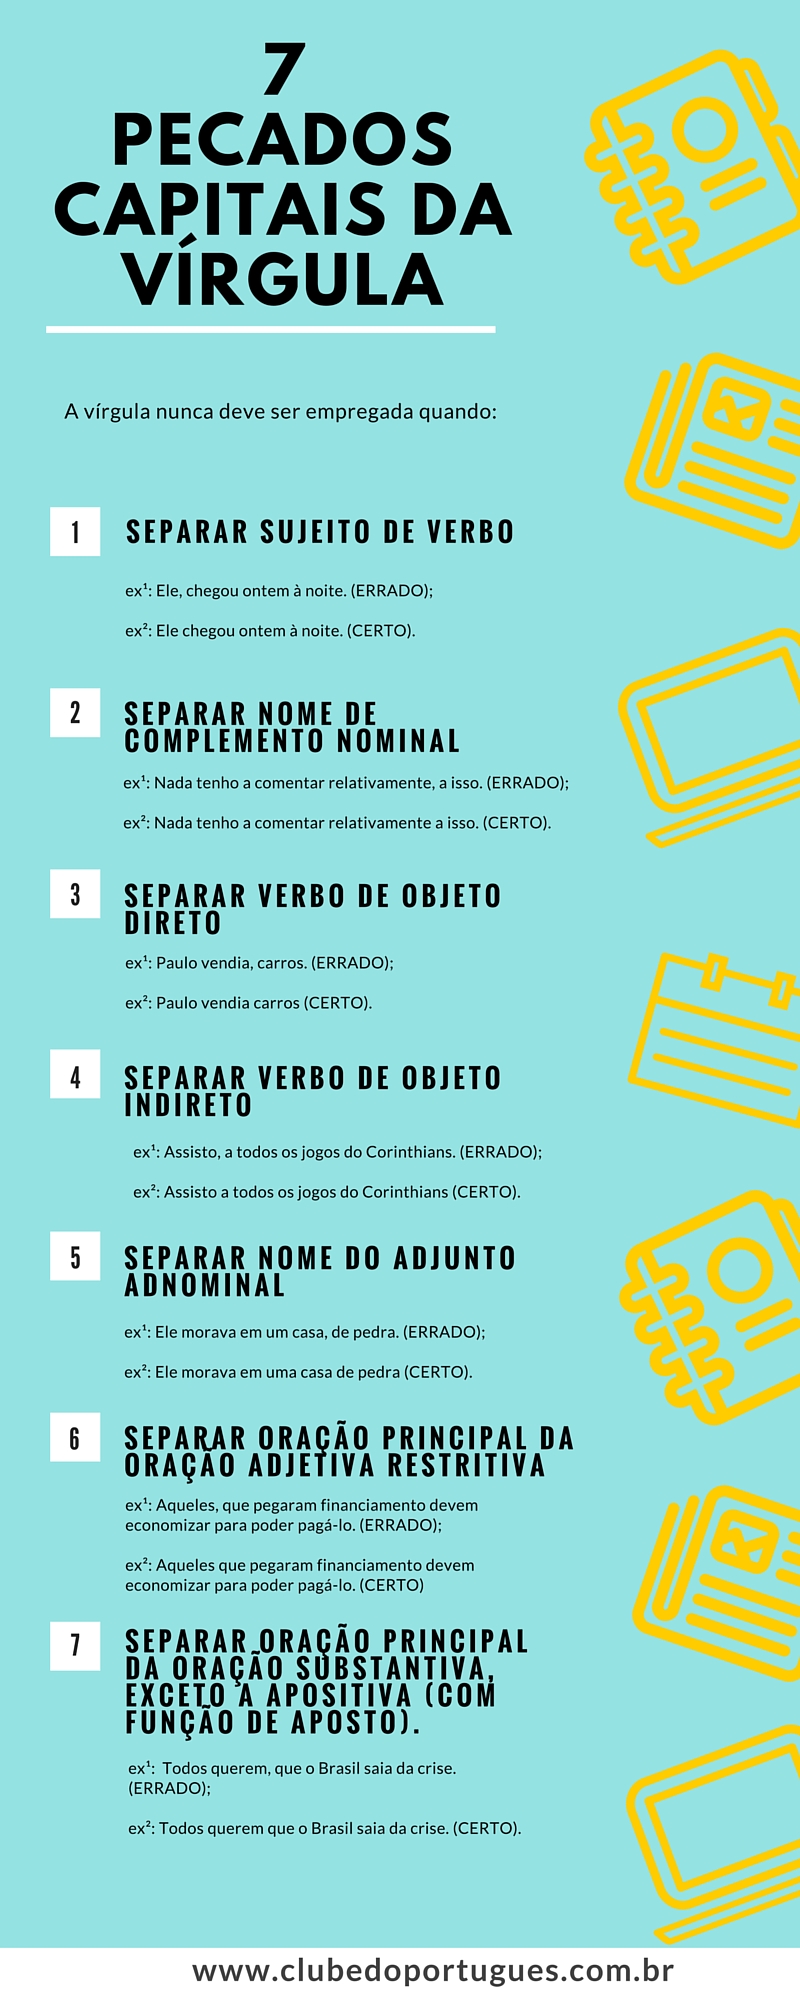
Se o seu caso é especialmente complicado — arquivos mistos com múltiplos delimitadores, codificação desconhecida, ou estruturas irregulares — vale a pena considerar ferramentas especializadas como o R's readr ou o Python's csvkit, que fazem detecção automática de esquema com muito mais margem de acerto do que um parser manual. O custo é uma curva de aprendizado menor do que o preço que se paga quando o parse falha em produção.
Galeria
-

PoRtUgUêS nA TeLa: #dicasdasemana: uso do MAS e a VÍRGULA -
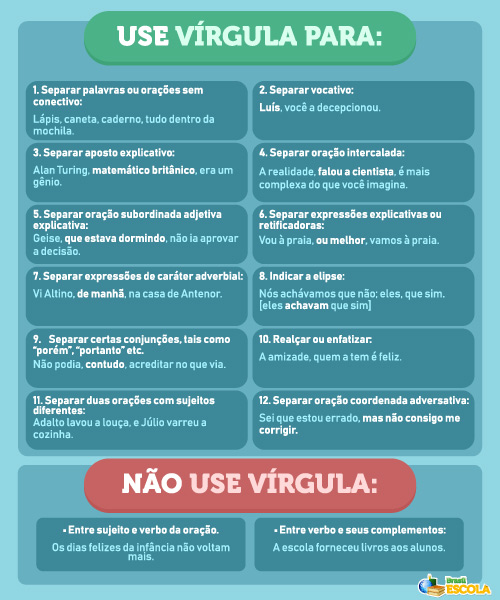
Usos da vírgula: resumo, exemplos, mapa mental - Brasil Escola -
Uso da Vírgula: Regras e Exemplos | PDF | Gramática | Sintaxe -

12 regras simples do uso da vírgula | Sinais de pontuação atividades ...

