Matematica Probabilidade

Probabilidade na prática: o que realmente funciona quando os livros não ajudam
A primeira coisa que todo mundo erra em probabilidade é achar que os eventos são independentes quando não são. Eu vi isso acontecer em análise de risco num projeto de logística, onde a equipe tratava avarias em veículos diferentes como eventos mutuamente independentes. A conta final saiu com uma margem de erro de quase 40% porque dois tipos de caminhão compartilhavam o mesmo fornecedor de peças e uma falha simultânea era bem mais provável do que o modelo indicava. O ajuste foi simples: mapear as dependências reais e calcular probabilidades condicionais nos trechos críticos. A regra básica de Probabilidade é P(A) = casos favoráveis / casos possíveis, mas essa fórmula funciona perfeitamente só em espaços amostrais finitos e equiprováveis. Quando o espaço é contínuo, ou quando as chances não são uniformes, você precisa ir pra densidade de probabilidade e integrar. É um erro comum tentar aplicar a definição clássica em distribuições contínuas e acabar com resultados que não fazem sentido.
O que ninguém ensina sobre matematica probabilidade no dia a dia
Aqui vai algo que eu aprendi na marra: a chamada paradoxa do aniversário não é apenas uma curiosidade de festa. Ela aparece constantemente em testes de segurança cibernética quando você está avaliando chance de colisão em hashes. Duas strings gerando o mesmo hash parece improvável com strings suficientes, mas o cálculo ingênuo "dividir casos" te entrega uma resposta errada. Você precisa pensar em probabilidades complementares — P(nenhuma colisão) e depois subtrair de 1. Isso economiza horas de teste desnecessário em simulações de Monte Carlo. Outro ponto que todo mundo pula é a diferença entre probabilidade incondicional, condicional e conjunta. A fórmula de Bayes é famosa, mas o uso correto exige que você entenda o que cada termo representa. P(A|B) não é a mesma coisa que P(B|A). Eu vi um analista usar P(dado positivo | doença) no lugar de P(doença | dado positivo) numa avaliação médica e o diagnóstico ficou completamente distorcido. O valor de sensibilidade do teste não é a probabilidade de você ter a doença se o teste deu positivo. Vou dar um exemplo prático rápido. Digamos que você tem uma caixa com 3 moedas: uma justa, uma viciada que dá cara 70% das vezes, e outra viciada que dá coroa 80% das vezes. Você pega uma moeda ao acaso, joga 5 vezes e sai cara 4 vezes. Qual a probabilidade de ser a moeda justa? A resposta não é intuitiva. Usando Bayes:
P(justa | 4 caras em 5) = P(4 caras | justa) × P(justa) / P(4 caras) O numerador fica (0.5)^4 × 0.5 = 0.03125. O denominador soma as contribuições de cada moeda, calculando a probabilidade binomial de 4 caras em 5 lançamentos para cada uma. O resultado final mostra que a probabilidade de ser a moeda justa cai para cerca de 12%, não 33% como muitos achariam de forma intuitiva.

Distribuições: quando usar cada uma e onde elas falham
A binomial é a mais cobrada em provas, mas também a mais mal aplicada. Ela exige exatamente n tentativas, resultados binários (sucesso/fracasso), probabilidade constante e independência entre tentativas. Se qualquer uma dessas condições quebra, a binomial te leva ao erro. Distribuição geométrica para o número de tentativas até o primeiro sucesso, distribuição hipergeométrica quando a amostragem é sem reposição e a probabilidade muda a cada extração — essas alternativas aparecem com frequência em cenários reais que parecem binomiais à primeira vista. A normal é onipresente, mas tem limitações sérias. A aproximação normal da binomial só funciona bem quando np 10 e n(1-p) 10. Fora disso, os caudas ficam distorcidas e as probabilidades calculadas passam a ser imprecisas. Em processos industriais, eu já vi gente usar a normal para modelar tempos de falha de componentes com distribuição assimétrica à direita, o que gerava estimativas de garantia completamente equivocadas. O correto nesse caso seria uma distribuiçãoWeibull ou log-normal. O problema da convergência do Teorema do Limite Central também é mal compreendido. O TLC diz que a média amostral tende a uma normal quando n cresce, mas "cresce" depende da distribuição original. Para distribuições simétricas, n=30 já é razoável. Para distribuições altamente assimétricas, como exponencial ou Poisson com lambda pequeno, você pode precisar de centenas de observações antes da aproximação normal se comporte de forma confiável.
Probabilidade condicional e independência: apegos perigosos
Duas variáveis podem ser dependentes marginalmente mas independentes condicionalmente, ou o contrário. Isso se chama independência condicional e é fundamental em modelos bayesianos e redes bayesianas. Um exemplo clássico: a probabilidade de chover e a probabilidade de alguém usar guarda-chuva não são independentes, mas se você souber que está chovendo, essas duas variáveis se tornam independentes em relação ao comportamento das pessoas. Entender isso evita raciocínios causais errados em análise de dados. A correlação não implica causalidade é o clichê mais citado da estatística, mas a versão probabilidade-condicional do mesmo erro é ainda mais perigosa. Se P(A|B) > P(A), isso não significa que B causa A. Pode ser que A cause B, ou que uma terceira variável C cause ambas. Em investigação de causa raiz, esse tipo de confusão gera recomendações de correção que tratam sintomas ao invés de causas.
Ferramentas e implementação prática
Para cálculos manuais, uma calculadora científica com funções estatísticas resolve boa parte dos problemas introdutórios. Para situações reais, Python com as bibliotecas scipy.stats e numpy é o padrão do setor. A função scipy.stats.binom.pmf te dá a probabilidade pontual, pmf para acumulada, e rv_discrete para distribuições personalizadas. Em termos de velocidade, uma simulação de Monte Carlo de 100 mil iterações com numpy roda em menos de 0.5 segundos num notebook comum, enquanto o mesmo cálculo analítico com integração numérica pode levar muito mais tempo dependendo da complexidade do modelo. O R ainda é forte em análise estatística acadêmica e setor regulatório, mas o ecossistema Python cresceu demais pra ser ignorado em pipelines de produção. Se você trabalha com dados em ambiente corporativo, aprender a construir modelos probabilísticos em Python te dá interoperabilidade com todo o resto da stack — armazenamento, API, dashboards. Não é uma questão de gosto, é eficiência operacional.

Erros que custam caro e como evitá-los
O erro mais frequente que eu vejo em revisões de modelos é a double counting: calcular a probabilidade de dois eventos ocorrerem somando as probabilidades individuais em vez de usar a fórmula da união P(AB) = P(A) + P(B) - P(AB). Isso inflaciona resultados e aparece com frequência em cálculos de risco combinado. Se A e B são independentes, P(AB) = P(A) × P(B), mas se há dependência, você precisa estimar a probabilidade conjunta corretamente. Outro problema crônico é ignorar a probabilidade base. Um teste com 99% de sensibilidade e 99% de especificidade para uma doença que afeta 1 em 10.000 pessoas não significa que um teste positivo tem 99% de chance de ser verdadeiro. Aplicando Bayes, a probabilidade real de ter a doença dado um teste positivo é de aproximadamente 0.9%. A taxa de falsos positivos domina porque a prevalência é baixíssima. Isso já causou pânico desnecessário em programas de triagem populacional que eu tive que revisar. A interpretação de intervalos de confiança também é amplamente distorcida. Um IC de 95% não significa que há 95% de chance de o parâmetro verdadeiro estar no intervalo calculado. Ele significa que, se você repetisse o experimento infinitas vezes, 95% dos intervalos construídos conteriam o parâmetro. A diferença é sutil mas matematicamente significativa, especialmente em inferência bayesiana onde os credíveis intervalos realmente representam probabilidades sobre o parâmetro.
Cálculo de probabilidade em cenários complexos
Quando o problema envolve múltiplas etapas com ramificações, árvores de decisão são úteis mas ficam ingovernáveis rápido. Eu precisei modelar um processo de produção com 12 estágios e 3 possíveis falhas em cada estágio, o que gerava mais de 500 ramos na árvore. A solução foi abandonar a árvore e usar recursão com memoização em Python, calculando a probabilidade de falha do sistema como 1 - produto das probabilidades de sucesso em cada estágio, considerando as dependências mapeadas previamente. Processos estocásticos como cadeias de Markov aparecem quando o estado futuro depende apenas do estado presente, não do histórico completo. Cadeias markovianas discretas são amplamente usadas em modelagem de fila, previsão de churn, e análise de confiabilidade. A propriedade markoviana simplifica muito os cálculos mas é uma suposição forte. Se o seu sistema tem memória de longo prazo — como degradação cumulativa de um componente — uma cadeia de Markov de primeira ordem vai subestimar riscos de falha sucessivas. Simulações de Monte Carlo são provavelmente a ferramenta mais versátil em probabilidade aplicada. Você modela o sistema, define as distribuições de entrada, roda milhares de iterações e analisa a distribuição de saída. O custo é computacional, mas com hardware atual isso raramente é gargalo. O gargalo real é definir as distribuições de entrada corretamente. Uma simulação com assumptions erradas é mais perigosa do que nenhuma simulação, porque gera confiança falsa nos resultados.
A probabilidade é uma ferramenta de raciocínio sob incerteza, não uma bola de cristal. Os cálculos ficam precisos quando os pressupostos estão corretos, e os pressupostos estão corretos quando você entende o domínio do problema melhor do que o modelo. Não adianta ter a fórmula perfeita se o problema foi formulado de forma errada desde o início.

Galeria
-
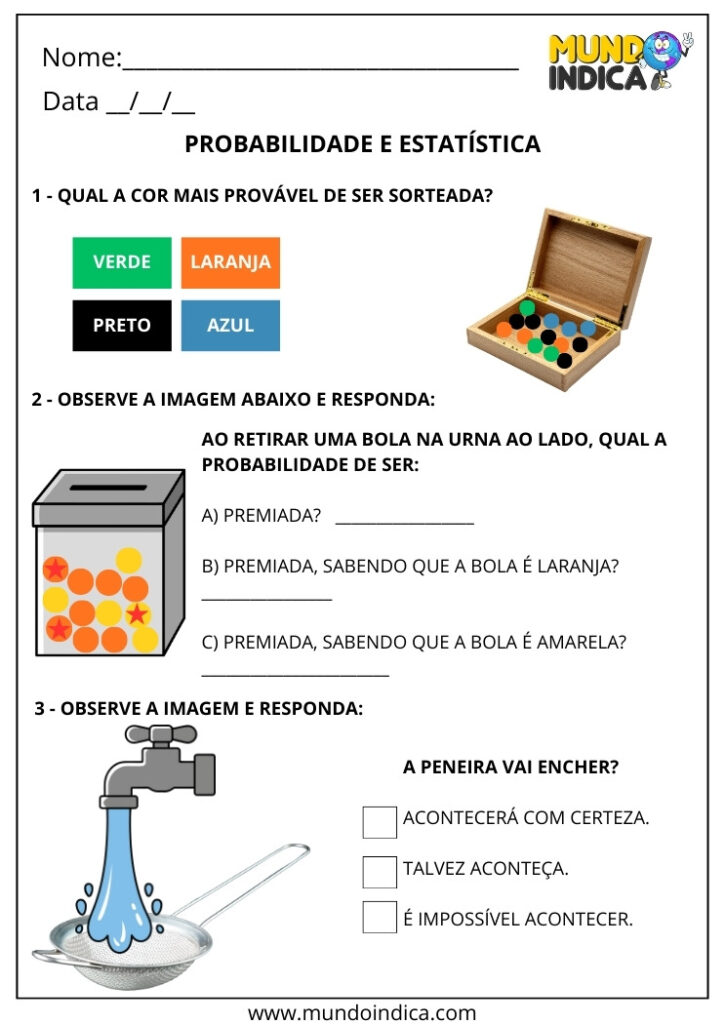
Atividades de Matemática 2º ano sobre Probabilidade e Estatística -
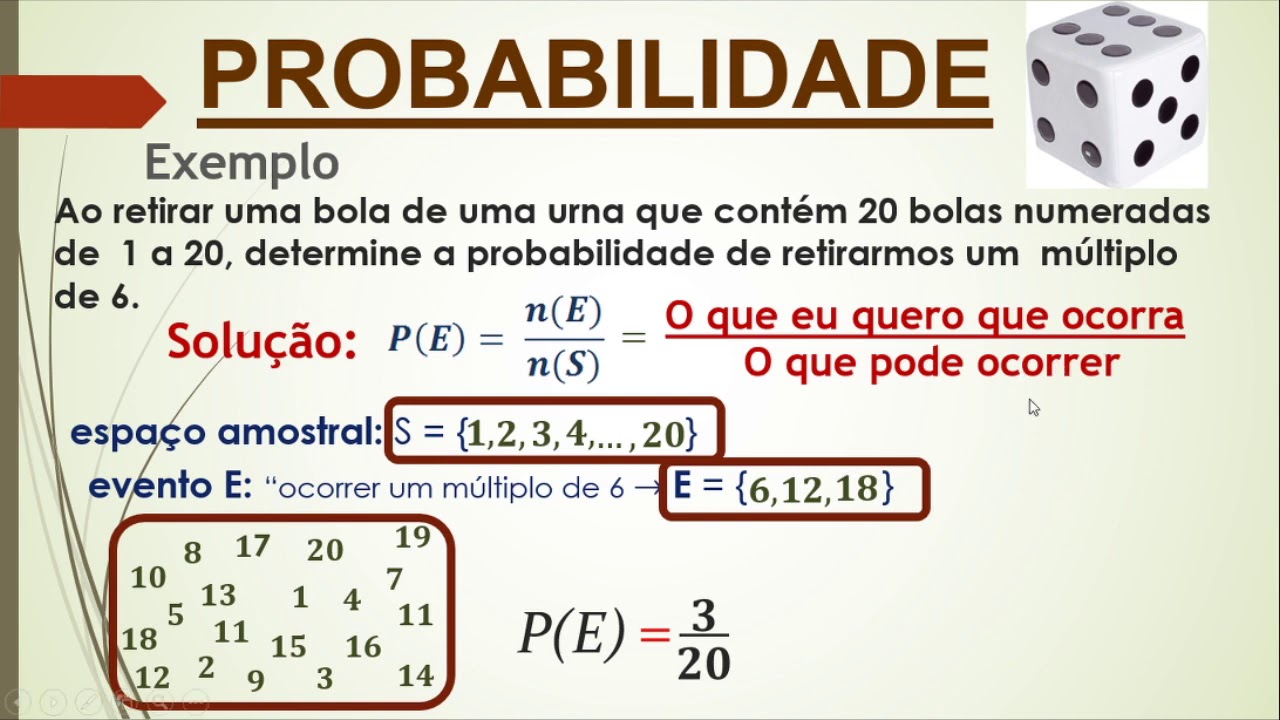
Exercícios De Probabilidade 5 Ano - FDPLEARN
