Medidas De Dispersão Absoluta E Relativa
Medidas de dispersão: o que funciona na prática
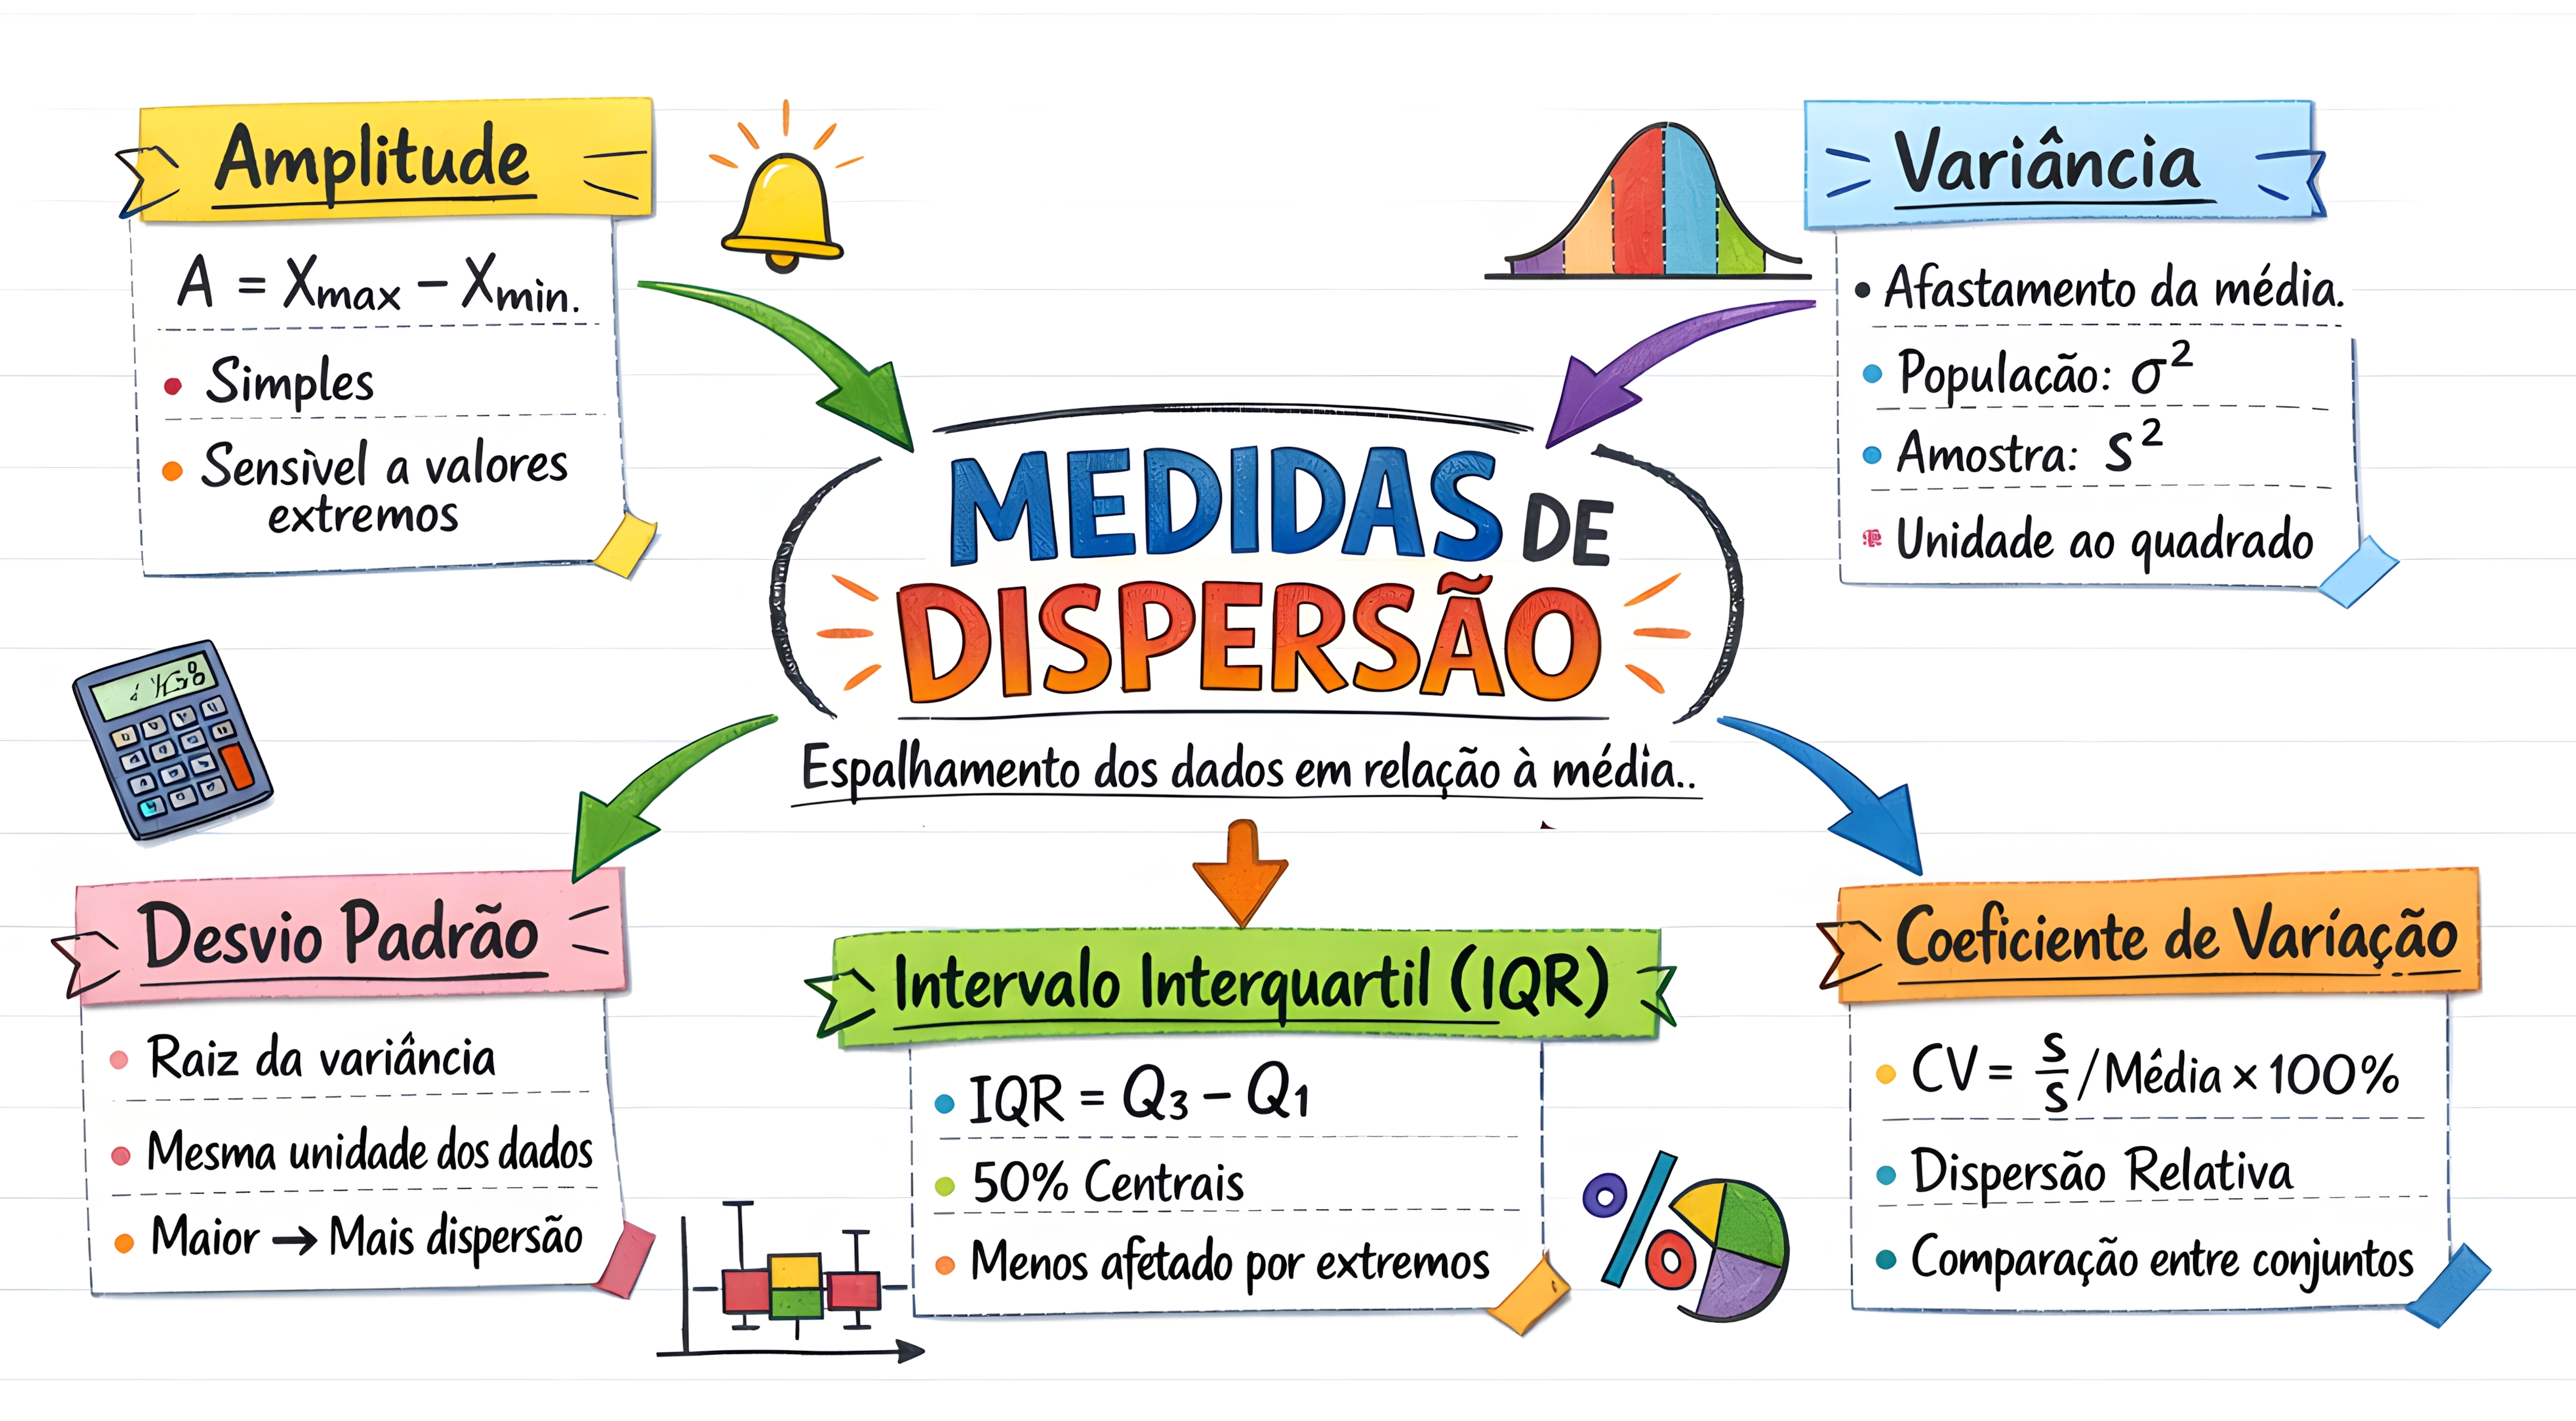
Quando você está analisando um dataset e só olha para a média, quase sempre está passando perto da verdade. A média diz onde o centro está. Nada mais. Para entender como os dados se comportam de fato, você precisa olhar para as medidas de dispersão, divididas em dois grupos: absolutas e relativas. O pessoal costuma confundir isso nos relatórios porque mistura tudo numa tabela só sem pensar no contexto. Eu já vi analista usar desvio padrão normal e coeficiente de variação juntos como se fossem sinônimos. Não são. Eles respondem perguntas diferentes.
Medidas de dispersão absoluta e relativa na prática
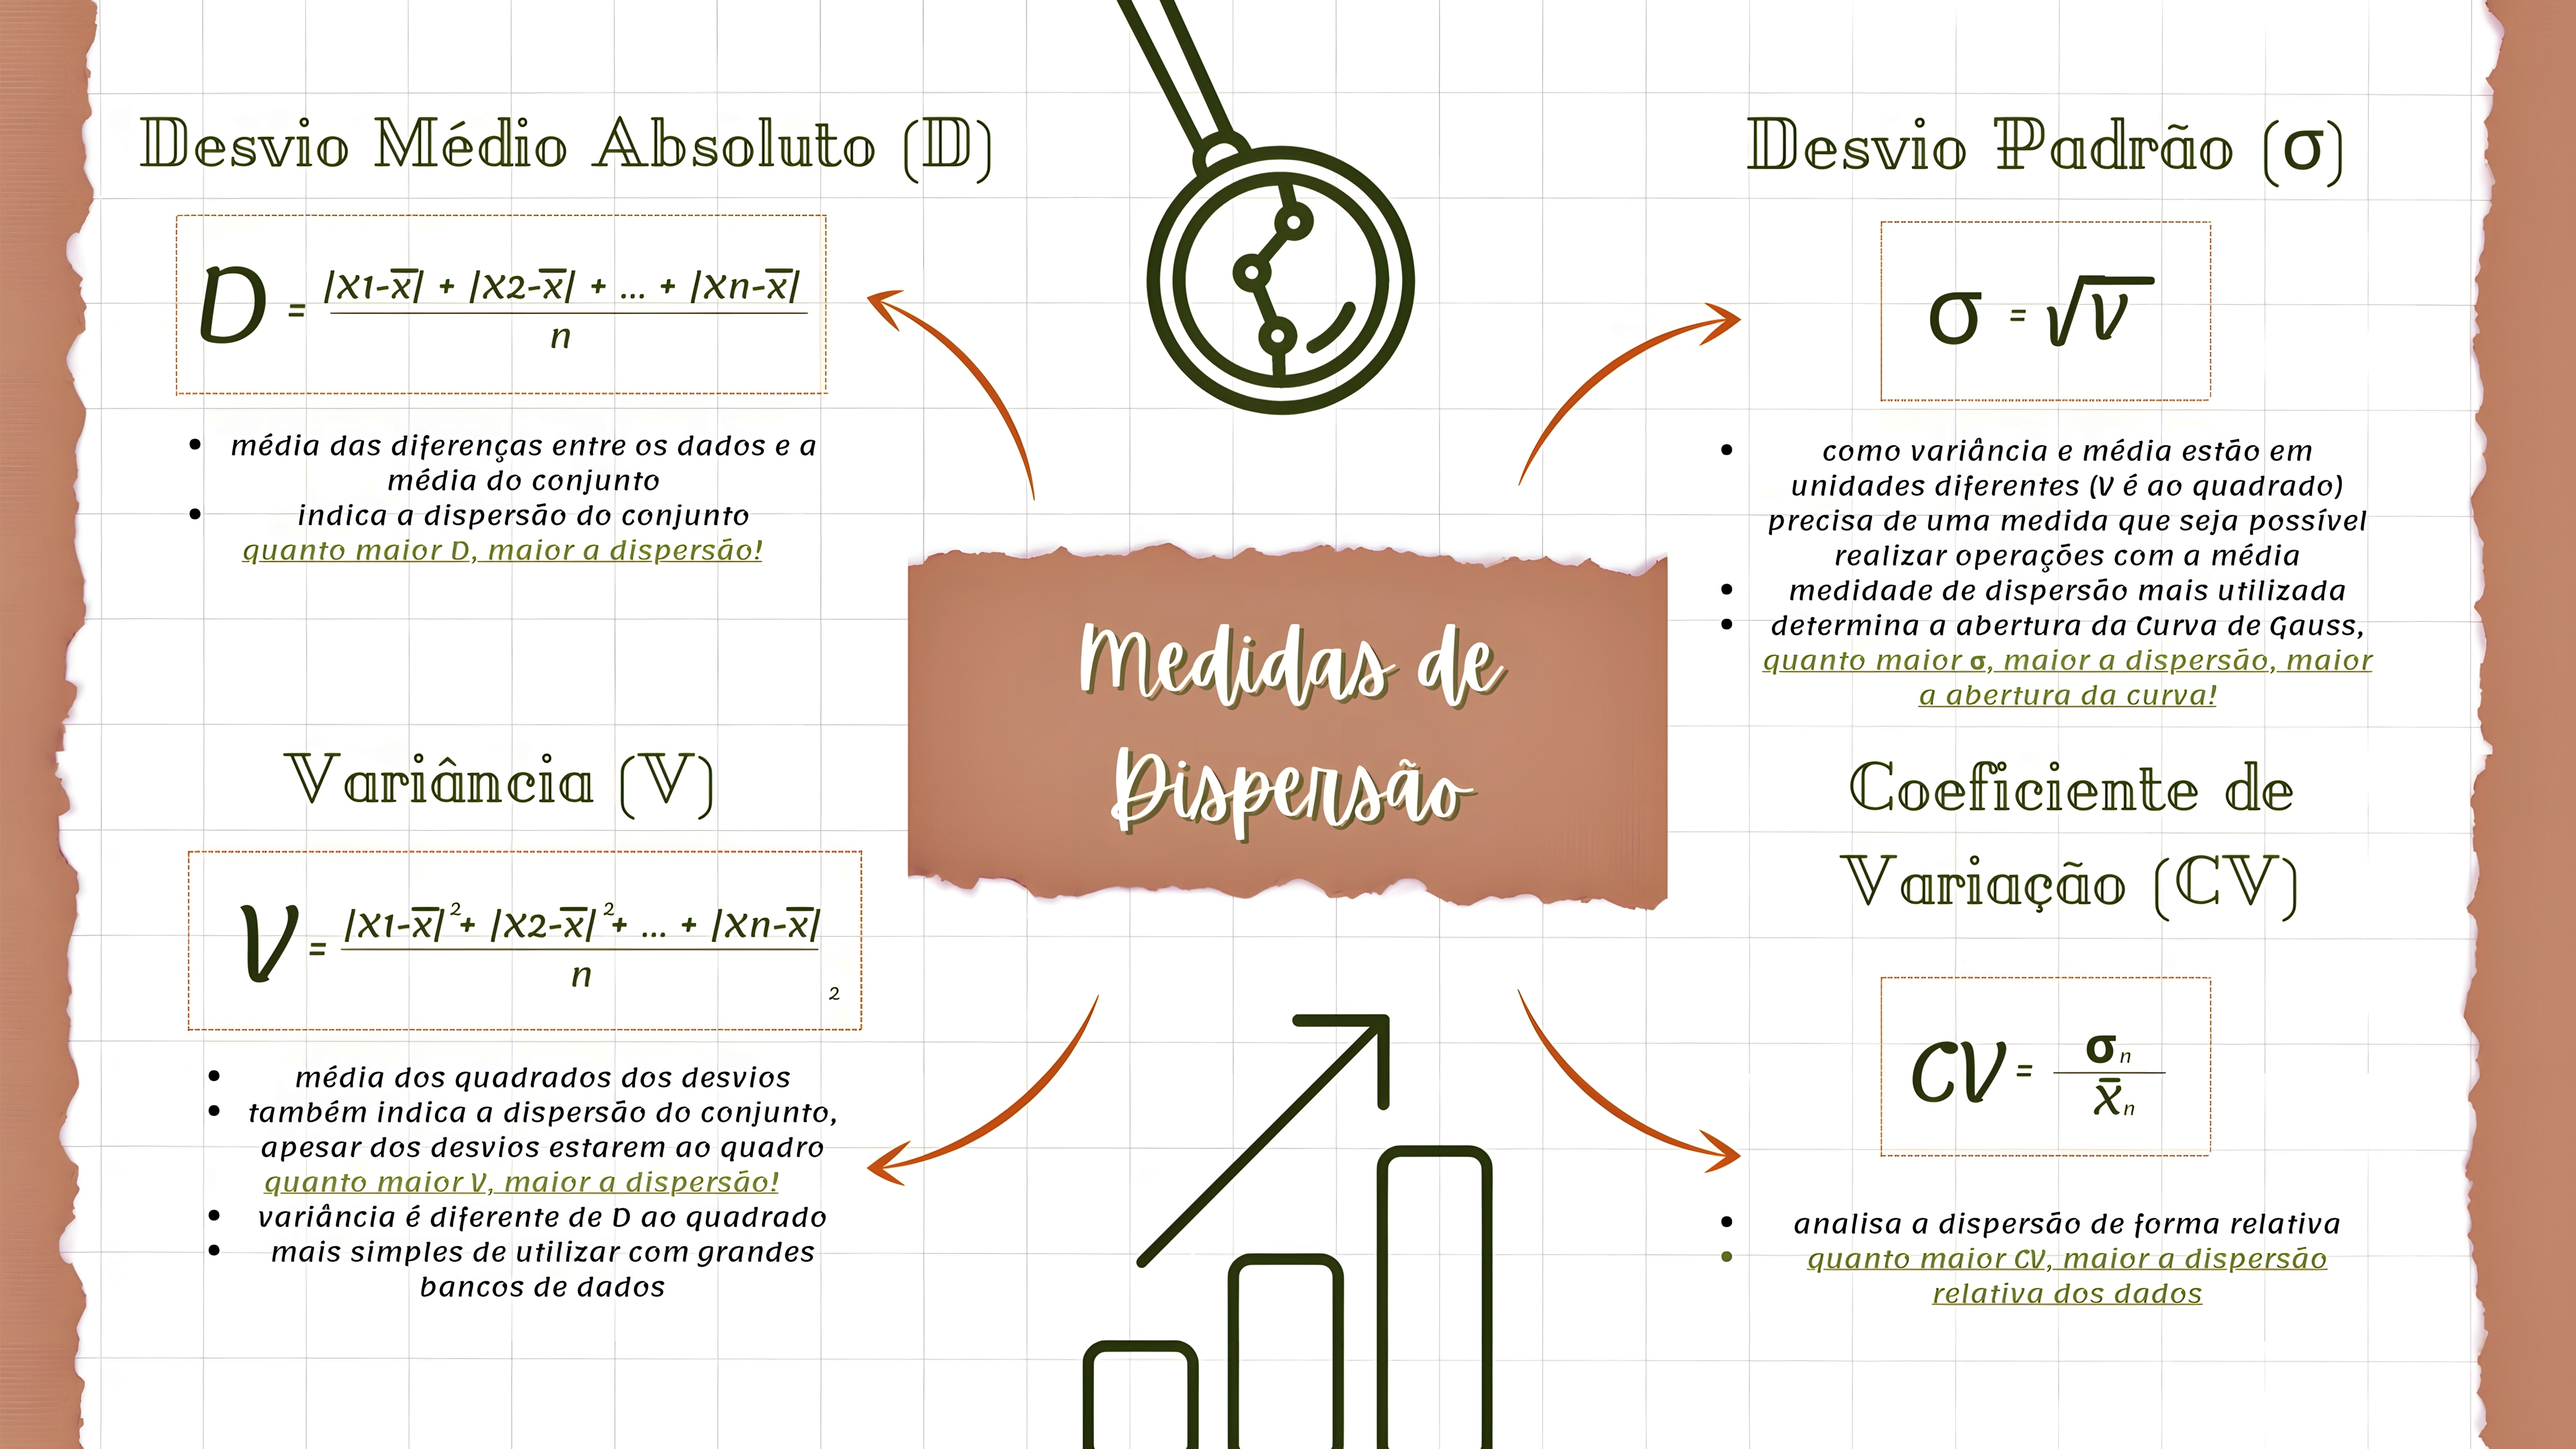
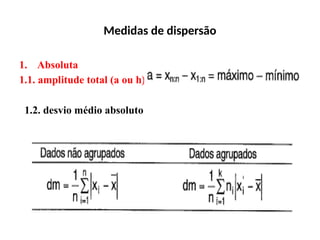
Vamos começar pelo básico mesmo, porque a maioria dos erros vem daqui. Dispersão absoluta mede o quanto os valores se espalham na mesma unidade da variável original. Dispersão relativa elimina essa unidade e permite comparação entre conjuntos com escalas diferentes. Essa diferença não é técnica, é funcional. A amplitude total é a medida absoluta mais simples. Você pega o maior valor, subtrai o menor e pronto. O problema é que ela só depende de dois pontos. Se seu conjunto tem um outlier extremo, a amplitude mente pra você. Eu tive um caso recente com dados de tempo de resposta de um servidor onde a amplitude dava 47 segundos, mas 95% das requisições ficavam entre 0,8 e 2,3 segundos. A amplitude estava completamente desconectada da realidade. O desvio padrão resolve parte disso porque considera todos os pontos. Ele é a raiz quadrada da média dos quadrados dos desvios em relação à média. Parece simples, mas tem pegadinha. O desvio padrão amostral usa n-1 no denominador, não n. Se você usar n por hábito, vai subestimar a variabilidade. No meu trabalho, isso já causou um intervalo de confiança apertado demais num teste A/B e levamos duas semanas pra perceber o erro depois que a decisão de deploy já estava tomada.
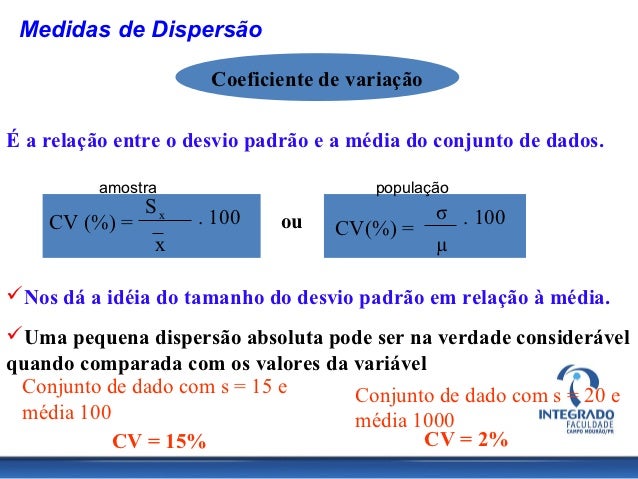
A variância é o quadrado do desvio padrão. Você quase nunca reporta ela sozinha porque a unidade fica ao quadrado. Mas é útil em cálculos intermediários, especialmente em análise de variância (ANOVA). Se você está fazendo modelagem estatística, a variância aparece o tempo todo nos cálculos internos. O desvio médio absoluto é menos divulgado mas vale a pena conhecer. É a média dos valores absolutos dos desvios. Ele é mais robusto que o desvio padrão porque não eleva tudo ao quadrado, o que significa que outliers pesam menos. Em datasets com caudas longas, o desvio padrão pode inflar artificialmente a percepção de variabilidade. Agora as medidas relativas. O coeficiente de variação é o mais usado. Ele divide o desvio padrão pela média e multiplica por 100 pra dar uma porcentagem. A vantagem é clara: você compara a volatilidade de salários (em reais) com a volatilidade de idades (em anos) diretamente. O limitação é que a média precisa ser diferente de zero. Se sua variável tem média próxima de zero, o coeficiente de variação explode e perde sentido. Eu vi isso acontecer com dados de variação percentual de preços onde alguns valores eram negativos, gerando CVs absurdos que não representavam nada.

O coeficiente de variação de Pearson é uma variação que usa a moda quando a distribuição é simétrica e unimodal. Funciona bem nesse cenário específico, mas é raro encontrar distribuições perfeitamente simétricas em dados reais de produção. Na prática, eu recomendo usar só o CV padrão e ignorar essa variação. Existe também o coeficiente de variação interquartil, que divide o intervalo interquartil pela mediana. Esse é mais interessante quando sua distribuição é assimétrica ou tem outliers. O intervalo interquartil por si só já é uma medida absoluta que eu sempre reporto junto com o desvio padrão porque ele captura o espalhamento dos 50% centrais dos dados sem ser distorcido por extremos. Na hora de escolher qual medida usar, a regra prática que eu sigo é simples: se seus dados são normais e livres de outliers, desvio padrão funciona bem. Se há assimetria ou valores extremos, use desvio médio absoluto ou intervalo interquartil. Para comparar grupos com unidades diferentes, vá de coeficiente de variação. Se a média for negativa ou próxima de zero, o CV é descartável e você precisa de outra abordagem, como normalizar os dados primeiro.
Um detalhe que pouca gente menciona: dispersão absoluta e relativa são complementares, não concorrentes. Reportar só uma delas é como descrever uma cidade dizendo só o número de habitantes sem falar o tamanho territorial. Eu costumo pedir em relatórios que acompanhem sempre a média, o desvio padrão e o coeficiente de variação. Isso cobre o centro, a dispersão interna e a comparabilidade externa em três linhas. Para calcular isso no dia a dia, ferramentas como R, Python com pandas ou até planilhas fazem o trabalho rapidamente. O tricky não é calcular, é interpretar. Um desvio padrão pequeno numa média grande pode significar menos variabilidade relativa do que um desvio padrão pequeno numa média pequena. É por isso que o coeficiente de variação existe. Outra armadilha comum é tratar desvio padrão como sinônimo de erro. Ele não é. O desvio padrão descreve a população ou amostra. O erro padrão da média descreve a precisão da estimativa da média. São coisas distintas que todo mundo confunde em apresentações executivas.
Se você trabalha com controle estatístico de processo, a dispersão absoluta é mais relevante porque a unidade importa. Se trabalha com finanças comparando ativos de capitais diferentes, a dispersão relativa vira obrigatória. O contexto define a ferramenta, não o contrário.
Limitações que ninguém anuncia
Nenhuma dessas medidas funciona bem com distribuições multimodais. Se seu dado tem dois picos, a média e o desvio padrão vão dizer algo que não reflete nenhuma parte real da distribuição. Nesse caso, você precisa separar os grupos antes de calcular. Eu perdi tempo analisando dados de tempo de atendimento que misturavam ligações novas com renovações, e o desvio padrão altíssimo me fez achar que o processo era instável quando na verdade eram dois processos diferentes com comportamentos distintos. Em distribuições com variância infinita, como certas caudas pesadas, nem o desvio padrão converge. Isso é raro em dados empresariais, mas acontece em finanças com séries de retornos extremos. Nesses casos, medidas de dispersão baseadas em quantis são a única opção confiável. O coeficiente de variação também falha quando a escala dos dados não é de razão. Em dados de intervalo, como temperatura em Celsius, o CV é matematicamente inválido porque o zero não é zero absoluto. Eu vi isso aplicado em estudos climáticos onde usavam CV em graus Celsius e os resultados eram completamente arbitrários. Sempre verifique o tipo de escala antes de aplicar qualquer medida relativa.
Em resumo, dispersão absoluta e relativa são ferramentas que exigem compreensão do contexto dos dados. Calcular é trivial. Escolher certo e interpretar corretamente é o trabalho real.
Galeria
-
Medidas de Dispersão e Análise Estatística em Geologia e Geomatemática ... -
Aula 12 medidas de dispersão -
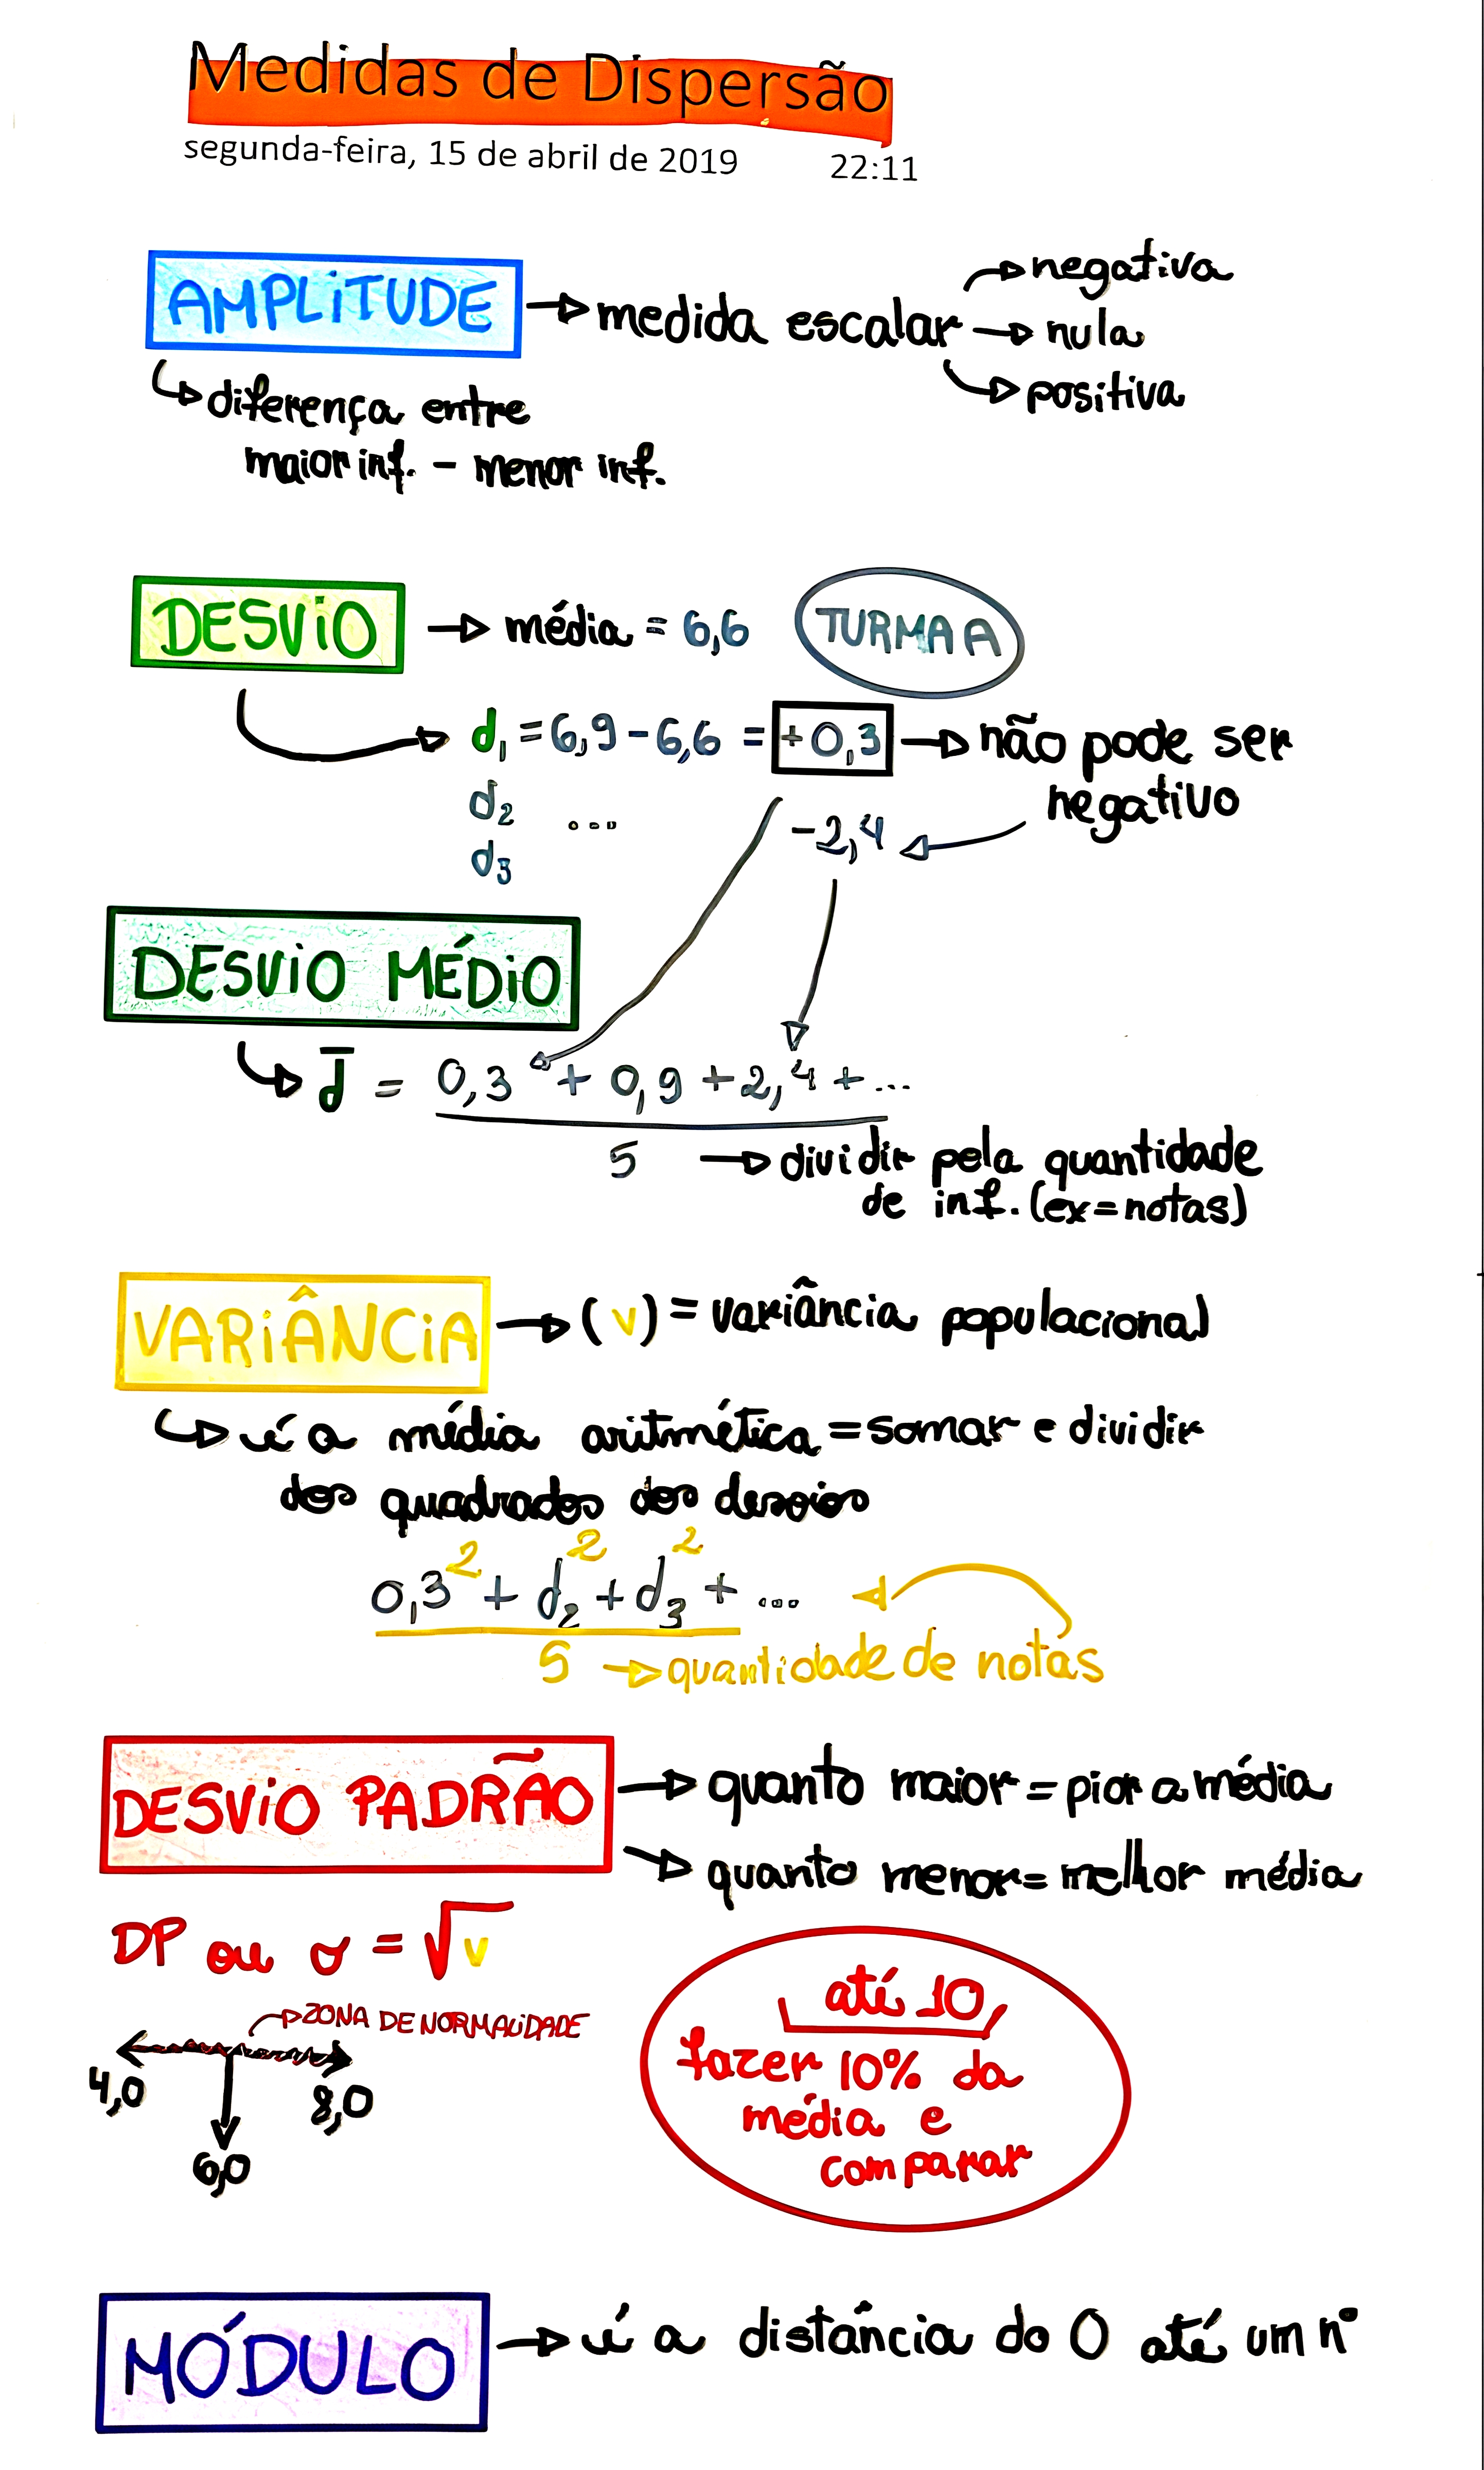
MAPA MENTAL SOBRE MEDIDAS DE DISPERSÃO - Maps4Study
