Medidas De Tendência Central E Dispersão

Entendendo medidas de tendência central e dispersão na prática
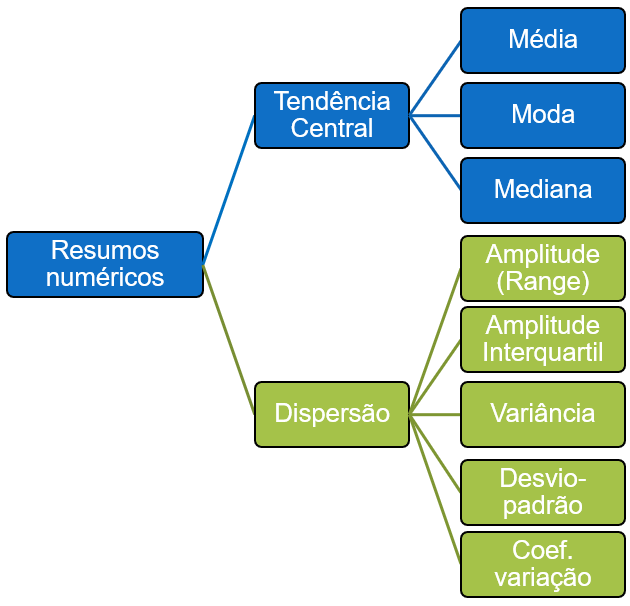
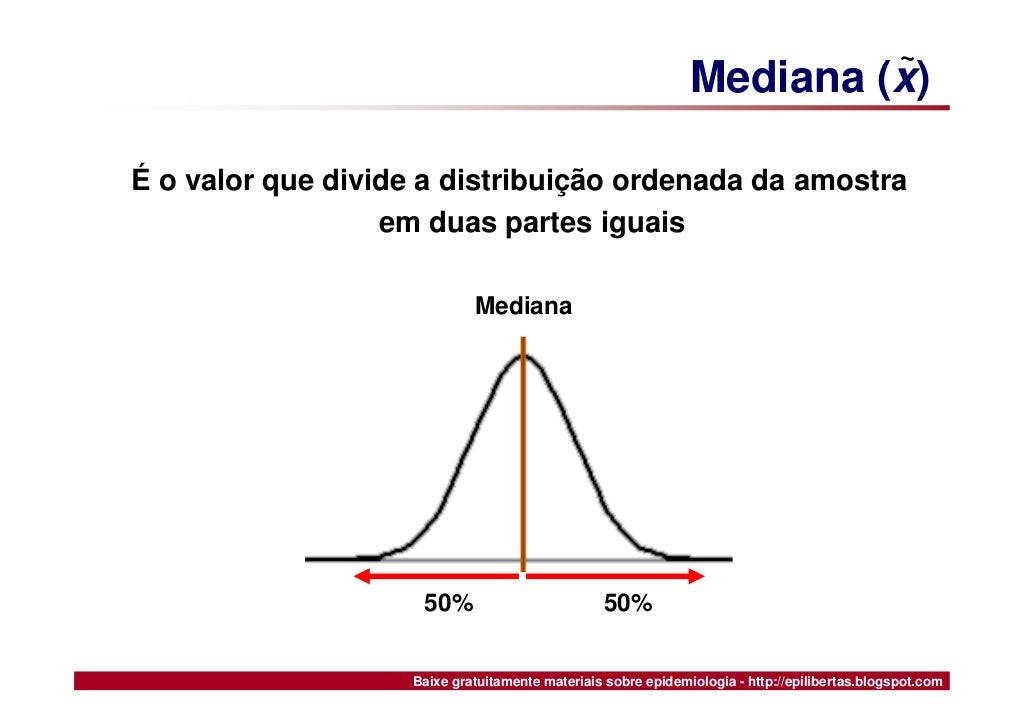
Quando você abre um conjunto de dados, a primeira coisa que tenta responder é qual é o comportamento típico do que está sendo medido. As medidas de tendência central resolvem isso resumindo um universo de valores em um único ponto representativo. Média, mediana e moda são os pilares, cada um com vantagens e limitações claras que só aparecem quando você trabalha com dados reais. A média aritmética some todos os valores e divide pela quantidade. Parece simples, mas é a medida mais sensível a valores extremos. Já a mediana divide o conjunto ao meio, o que significa que metade dos dados fica acima e metade abaixo. A moda é simplesmente o valor mais frequente. Em muitos casos práticos, os três números precisam ser olhados juntos para ter uma visão honesta da distribuição.
Medidas de tendência central e dispersão: como usar de verdade
A dispersão complementa a tendência central porque um único número central esconde tudo que acontece nos extremos. Desvio padrão calcula o quanto os dados se espalham em relação à média, elevando as diferenças ao quadrado, somando e tirando a raiz quadrada. Variância é o quadrado do desvio padrão, mas na prática o desvio padrão é muito mais interpretável porque volta à unidade original da variável. Range ou amplitude é a diferença entre o maior e o menor valor. Simples, mas extremamente sensível a outliers. Intervalo interquartil, que subtrai o primeiro quartil do terceiro quartil, ignora os extremos e mostra onde 50 por cento dos dados estão concentrados. Esse é o número que eu confio mais quando os dados não são simétricos. No meu trabalho com análise de dados de produção industrial, tive um caso em que a média de tempo de ciclo era de 47 segundos, mas a mediana era 38 segundos. O desvio padrão altíssimo e a amplitude de 120 segundos indicavam algo muito desigual. Aconteceu que uma linha específica tinha uma varredura defeituosa que puxava a média para cima. A solução foi isolar os dados por turno e analisar cada linha separadamente antes de calcular qualquer agregado geral. Trabalhar com o todo mascarava o problema.
Outro ponto que os materiais introdutórios costumam ignorar é a diferença entre tratar um conjunto como população ou amostra. Quando calculo desvio padrão amostral, divido por n menos um. Para população, divido por n. Misturar os dois caminhos pode alterar o resultado em cerca de dois a cinco por cento dependendo do tamanho da amostra, e isso parece pouco até você depender daquele número para tomar uma decisão de controle de qualidade. A assimetria também merece atenção. Quando a média é maior que a mediana, os dados tendem a ter uma cauda direita longa, ou seja, valores altos puxando a média. O inverso acontece com cauda esquerda. Em distribuições assimétricas, usar apenas a média sem considerar a mediana e o intervalo interquartil gera interpretações equivocadas. O desvio padrão sozinho também é insuficiente nessa situação porque pressupõe, de forma implícita, uma distribuição mais próxima da normal. Se o seu objetivo é apenas descrever um conjunto pequeno de números, as fórmulas tradicionais funcionam bem. Planilhas resolvem em segundos. O problema aparece quando você precisa replicar o cálculo para dezenas de colunas, filtrar por múltiplas dimensões e ainda detectar outliers automaticamente. Nesse cenário, fazer tudo manualmente gera muito trabalho repetitivo e aumenta o risco de erro humano. Ferramentas como Python com pandas, R com dplyr, ou até macros avançadas no Excel cortam esse tempo de processamento para uma fração do que seria feito manualmente.

Existem limitações importantes que valem registrar. O desvio padrão assume que os dados têm uma relação previsível em torno da média. Quando a distribuição é multimodal, ou seja, tem mais de um pico, o desvio padrão pode ser enganoso porque sugere concentração onde não existe. A moda, por sua vez, perde utilidade em dados contínuos sem binning adequado. E a média sempre vai ser manipulada por valores extremos, então não confie nela cegamente em conjuntos com caudas longas. O que funciona na prática é sempre apresentar tendência central e dispersão junto. Média isolada sem desvio padrão ou intervalo interquartil é informação incompleta. Mediana isolada sem quartis também. O ideal é reportar média e desvio padrão quando a distribuição for aproximadamente simétrica, e mediana com intervalo interquartil quando houver assimetria ou outliers conhecidos. Nada disso é revolucionário, mas é o padrão que evita erros de interpretação no dia a dia. Para quem quer calcular rapidamente, bibliotecas como numpy e pandas no Python oferecem funções diretas. mean, median, std, var, quantile, iqr. No Excel, MÉDIA, MEDIANA, DESVPAD.P e DESVPAD.P. Basta selecionar o intervalo e aplicar. A parte mais trabalhosa costuma ser a limpeza dos dados antes, não o cálculo em si.
Se você está começando agora, construa o hábito de sempre plotar um histograma ou boxplot junto com os números. Os gráficos revelam padrões que as fórmulas sozinhas escondem. Distribuições bimodais, valores discrepantes e agrupamentos estranhos aparecem de imediato no visual e passam despercebidos na tabela de medidas. Em resumo, dominar essas medidas significa saber quando confiar em cada uma, reconhecer os limites de cada métrica e combinar mais de um indicador antes de tirar qualquer conclusão. Isso economiza tempo de análise e reduz significativamente o risco de decisões baseadas em resumos enganosos.
Galeria
-
O básico da Estatística: Medidas de Tendência Central e Dispersão | by ... -

Medidas De Tendência Central E De Dispersão - FDPLEARN -
Medidas De Tendencia Central E Dispersão - FDPLEARN -
Medidas de Tendência Central e Dispersão | PDF | Dispersão estatística ...

